知乎原文
OpenAI这家公司是不是对“不”有什么情结?2025年GPT的输出疯狂套用“不是,而是”这种句式。估计他们也…
OpenAI这家公司是不是对“不”有什么情结?
2025年GPT的输出疯狂套用“不是,而是”这种句式。估计他们也收到吐槽了,最近新版本的GPT没有出现这个了,但是经常出现“这不能证明”“这不意味着”“这不代表”,不管分析什么事情,所有可能性都要说一遍,好话全部被它说了。体现在编程就是防御性编程。
知乎作品库
知乎原文
OpenAI这家公司是不是对“不”有什么情结?
2025年GPT的输出疯狂套用“不是,而是”这种句式。估计他们也收到吐槽了,最近新版本的GPT没有出现这个了,但是经常出现“这不能证明”“这不意味着”“这不代表”,不管分析什么事情,所有可能性都要说一遍,好话全部被它说了。体现在编程就是防御性编程。
知乎原文
我实在忍不住想吐槽:一个人就算完全分不清“权利”和“权力”,闭眼二选一,正确率也该有50%吧?可我在知乎看到的,感觉十次里有九次都是错的。该写“权利”的时候写成“权力”,该写“权力”的时候又写成“权利”。我真服了,大家到底是怎么做到错得如此精准的?哪怕完全不懂,也有50%的概率能蒙对啊。
知乎原文
我严重怀疑Deepseek APP端背后的模型搞不好只有8B,实际使用下来,错误连篇,完全不可用。
知乎原文
我让 Codex 帮我找个合适的旅行保险,它就在携程各个页面里点来点去。让我震惊的是,碰到不明白的地方,它居然真的点开在线客服,直接跟客服聊了起来。虽然早就知道AI浪潮渗透进了生活中的方方面面,但是这一刻还是觉得很震惊。如果有一天GPT能够拨打电话,我怀疑它真会自己调用语音,直接打给客服。
知乎原文
知乎原文
知乎原文
知乎原文
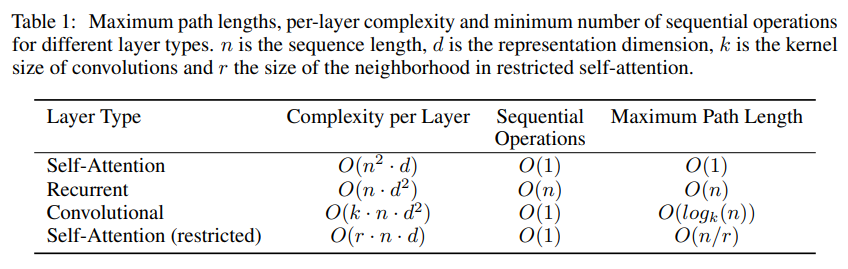
这是来自2017年的Transformer论文中的一张表格。当时做机器翻译,输入的 token 数通常比向量维度小。单看表里这一层的计算量,这时候全量自注意力比 RNN 省。可现在有的模型已经把上下文拉到了上百万个 token。向量维度不变,序列翻一倍,全量自注意力要算的配对大约翻四倍,RNN 那一项只翻两倍。到了长序列,当年「算得少」的优势就反过来了;能并行的优势还在。
知乎原文
在读GPT2论文的时候,看到这样一句话:But the often erratic behavior of captioning models (Lake et al., 2017), reading comprehension systems (Jia & Liang, 2017), and image classifiers (Alcorn et al., 2018) on the diversity and variety of possible inputs highlights some of the shortcomings of this approach.
这两个词都能表示「多样」。想强调这些东西彼此不一样,可以用 diversity;想说有好几种,可以用 variety。不用先判断它们算不算同一类。
比如我们正在训练一个深度学习模型用于图像识别,我们有一个包含了各种类型的猫的数据集(有不同的品种、颜色、年龄、体型等)。这里的 “diversity” 指的就是这个猫的数据集的多样性,即各种类型的猫的图片都包含在内。
而 “variety” 则可能指的是:在做一个更大规模的动物识别的任务时,我们收集了多种不同种类动物(如猫、狗、鸟、鱼等)的图像作为数据集。这里的 “variety” 指的就是数据集包含的动物种类的多样性。
知乎原文
均匀分布的熵最大,有三个点要注意:(1)先把比较范围定下来:只给定有哪些可能的结果,或者只给定一个有限区间,再在这个范围里比;(2)均匀分布在教材中一般指的是连续型均匀分布,但是大多数讲解信息熵的例子,是用离散型均匀分布来举例的;(3)在离散型均匀分布中,类别越多,其对应的熵越大。这背后的直觉是,类别越多,不确定性越大。如果是二分类,至少知道结果只会在两个之中出现。但如果是100分类,面临的选择就有100种了。