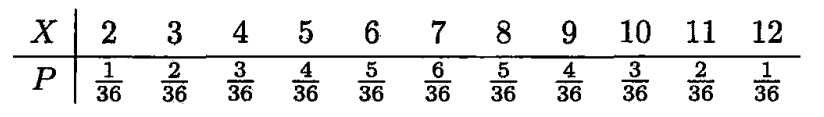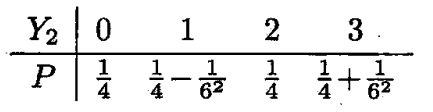武辰作品索引

知乎作品库

文章 · 6

知乎原文

一道机器学习岗位面试题:求圆上任取三个点组成锐角三角形的概率

这是一道某大厂的机器学习岗位的面试题。面试的过程有40分钟,一共三道题。前两道是概率题,最后一道是编程题。

第一道题是:抛一枚均匀的硬币若干次,直到出现连续两次正面向上,所需抛硬币总次数的数学期望是多少?

解答可以参考:

一道机器学习岗位面试题:平均要抛多少次硬币,才能出现连续两次正面向上?

第二道题是:在圆周上独立、均匀地取三个点组成三角形,求这个三角形是锐角三角形的概率。

这个问题网上有很多精妙的解答,如下面链接的回答,以及b站里3blue1brown大神的视频。

圆上任选三点组成三角形,这个三角形是锐角、钝角和直角三角形的概率分别是多少?

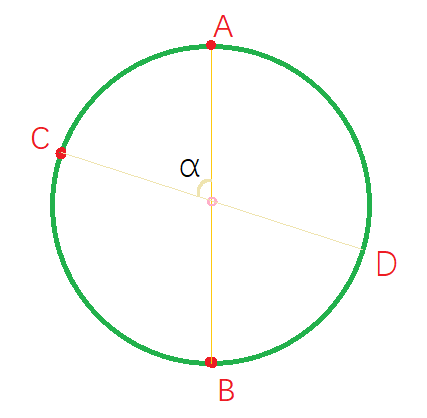
我要讲的方法是最基本的微积分方法。如下图所示,假设圆半径为1。首先固定住A点,我们把A点作为三角形的第一个点。接下来在圆周取作为三角形第二个点的点C。点C可能在AB的左边,也可能在AB的右边。由于左右完全对称,因此不妨设点C在AB的左边。

原文配图

最后一步是三角形第三个点的选取。易知,只有当第三个点E在劣弧BD上时,ACE才能组成锐角三角形(一个事实是:圆周上三个点组成锐角三角形,当且仅当圆心在三角形内部)。此时的概率为 BD̃2π=α2π\frac{\tilde{BD}}{2\pi}=\frac{\alpha}{2\pi} ,其中 BD̃\tilde{BD} 表示劣弧BD的弧长。

我们知道 α\alpha 服从 (0,π)(0,\pi) 上的均匀分布,经过加权得(即运用全概率公式): ∫0πα2π⋅1πdα=14\int_{0}^{\pi}\frac{\alpha}{2\pi}\cdot\frac{1}{\pi}d\alpha=\frac{1}{4} 。


以上是面试题。基于这道有趣的题目,我不禁展开了一个新的脑洞:圆上任选三点组成三角形,求三角形的面积的数学期望。

我的思路是,分别连接圆心到三角形的三个顶点。先固定第一个点 A。从 A 沿逆时针方向绕一圈,剩下两个点,先碰到的排前面。前两段圆心角记作 α 和 β,最后一段就是 2π−α−β。两个点本来各自在整圈里抽,密度是 1/(4π²)。先抽到近处、再抽到远处,或者反过来抽,排完都是同一组角,所以密度要乘 2,变成 1/(2π²)。根据三角形面积公式 S=12absincS=\frac{1}{2}absinc ,最终的式子是:

∫02π∫02π−α12[sinα+sinβ+sin(2π−α−β)]⋅12π2dβdα=32π\int_{0}^{2\pi}\int_{0}^{2\pi-\alpha}\frac{1}{2}[sin\alpha+sin\beta+sin(2\pi-\alpha-\beta)]\cdot\frac{1}{2\pi^{2}}d\beta d\alpha=\frac{3}{2\pi}

注:①由于弧长与对应角度是线性关系,因此关于圆周的均匀分布也是关于圆周角的均匀分布。这里和贝特朗奇论没有关系。(一个反例是,圆的面积与半径是平方关系,因此,关于面积的均匀分布不是关于半径的均匀分布);

②我已经考虑到了钝角三角形的情况。如果是钝角三角形,这三段圆心角里有一段超过半圈,那一项的正弦就是负的。这个负号正好把多算的那块面积减掉。


这道题我也写进了《大白话概率论》的面试题部分。书里用了另一种解法:把顶点翻到圆的对面,不用积分也能算出四分之一。

知乎原文

2019高考数学全国卷压轴题的统计学原理

温馨提示:阅读本文需要有本科概率论与统计学基础。

在正文开始之前,我先讲一个小例子。我们现在要通过比赛来决定徐徐和坤坤谁的三分球命中率高。可以有两种比赛方式。第一种方式是:徐徐和坤坤分别投十次球,看谁命中的次数多(或者徐徐和坤坤分别投若干次球,可以不相等,然后比较谁的命中率高);第二种方式是徐徐和坤坤进行多轮比赛。每一轮比赛中,徐徐和坤坤分别投一个球。经过多轮比赛,直到其中一个人比另一个人命中的次数多4次时,比赛停止。这两种方式都是可行的方式。第一种方式是最简单可行的方式。第二种方式技巧性更高些,也是我们今天要讲的主题。
原文配图

今年数学卷的最后一题(21题)是一道概率论与统计学方面的题。在统计学中检验两种药效的优劣有很多种方法。这道题提到的方法是其中一种。

一个最常见且自然的方法是:药物甲和药物乙分别用在 nn 个不同的小白鼠身上。记药物甲治愈了 aa 只小白鼠,药物乙治愈了 bb 只小白鼠。直观的想法是:若 a>ba>b ,则说明甲比乙更有效。当然直观的想法缺乏严谨性。如果考虑实验遵循的二项分布,可以精确地算出检验的拒绝域与两类错误。

本文以这道题为背景,并且对这道题经过稍微的改动,介绍另一种检验方法:进行若干轮实验。每一轮实验中,拎出一对幸运的小白鼠出来,其中一个吃药品甲,另一个吃药品乙。然后观察哪只小白鼠被治愈了,记录下来,然后进入下一轮试验。直到其中一种药物治愈的小白鼠的数目比另一种药物多4个,试验就停止。(为什么是4个?事实上,你也可以设置为1个,这样的话可能第一轮就分出胜负了,这种情况下检验的随机性太大。也可以把门槛设到10个。只要两种药确实有高下,门槛越高,判反的机会就越小;代价是实验往往要做更多轮,多花经费、时间,还要用上更多可怜的小白鼠。)

再补充一点,乒乓球、羽毛球中有这样的规则:当达到赛点后,如果双方比分接近,那么再继续若干轮比赛,直到一方率先比另一方多2分,就判定领先的人获胜,这背后的思想与本题的思想是一致的。

记 Xj=1X_{j}=1,若药物甲成功治愈第 jj 个小白鼠;

Xj=0X_{j}=0 ,若药物甲未能治愈第 jj 个小白鼠;

Yj=1Y_{j}=1 ,若药物乙成功治愈第 jj 个小白鼠;

Yj=0Y_{j}=0 ,若药物乙未能治愈第 jj 个小白鼠。

当 |(X1+X2+……+Xn)−(Y1+Y2+……+Yn)||(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n})| 首次达到4时,则试验结束。若此时 (X1+X2+……+Xn)−(Y1+Y2+……+Yn)=4(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n})=4 ,就按这个规则判甲更好。若此时 (Y1+Y2+……+Yn)−(X1+X2+……+Xn)=4(Y_{1}+Y_{2}+……+Y_{n})-(X_{1}+X_{2}+……+X_{n})=4 ,就按这个规则判乙更好。

做这个检验关心的问题是弃真错误和取伪错误。我们首先假定(即 H0H_{0} ):药物甲比药物乙好。如果的确药物甲比药物乙好,且实验的结果显示药物甲比药物乙好,那么我们没有犯错误。如果的确药物甲比药物乙好,但实验的结果显示药物乙更好,那么就犯了弃真错误。另一方面,如果药物乙比药物甲好,但实验的结果显示药物甲更好,那么就犯了取伪错误。

如果你第一次接触弃真错误和取伪错误两个概念,你可能对上面的描述有些犯晕。再举个例子:企业面试某个人,最后的结果有四种:①招到了有能力的人,②招到了没能力的人,③拒绝了有能力的人,④拒绝了没能力的人。结果①和④是好结果,没有犯错误。但是结果②和③是犯了错误的。拒绝了有能力的人,是弃真(顾名思义,放弃了真正有能力的人);招到了没能力的人,是取伪(顾名思义,是录取了没有能力的人)。

多说一句,在其他条件不变的情况下,弃真错误和取伪错误不能同时降低。你降低了弃真错误,必定会提升取伪错误。比如,你想降低弃真错误,即尽量不要拒绝有能力的人,那么你就要放低招人的标准。而放低了招人的标准,更加有可能会招到没能力的人。

当然弃真错误和取伪错误不是绝对的。要看你把哪句话当作原假设。

回到这道题,我们把“甲比乙好”当作原假设。实际是甲更好,却判了乙更好,这是弃真;实际是乙更好,却判了甲更好,这才是取伪。

那么,判错的概率怎么算呢?

设药物甲有效的概率是 p1p_{1} ,药物乙有效的概率是 p2p_{2}。这里假定不同小白鼠的治愈结果相互独立。

则药物甲有效、药物乙无效的概率是 p1(1−p2)p_{1}(1-p_{2}) ,此时分数的差距(即 (X1+X2+……+Xn)−(Y1+Y2+……+Yn)(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n}) )增加1;药物乙有效、药物甲无效的概率是 p2(1−p1)p_{2}(1-p_{1}),此时分数的差距减少1。我们记这两种情况为“有效实验”。另外的情况是:分数差距不变,即两种药物都有效或者两种药物都无效,此时对应的概率为 p1p2+(1−p1)(1−p2)p_{1}p_{2}+(1-p_{1})(1-p_{2}) 。

综合来看,分数差距增加1的概率为:

P=P(P=P( 增加1 || 增加1或减少1 ))

=p1(1−p2)p1(1−p2)+p2(1−p1)=\frac{p_{1}(1-p_{2})}{p_{1}(1-p_{2})+p_{2}(1-p_{1})} (*)

对应地,分数差距减少1的概率为 1−P1-P 。

根据赌徒输光定理,赌徒每次以概率 pp 赢1元钱、否则输1元钱,那么在净输了 mm 元之前,先净赢了 mm 元的概率为 11+(1−pp)m\frac{1}{1+\left(\frac{1-p}{p}\right)^{m}} 。(至于这个式子怎么来的,可以参考https://zhuanlan.zhihu.com/p/51554762,这篇文章有轻微的涉及。如果有机会我会新开一篇文章讲述这个结论是怎么来的,现在你只需把这个当现成的结论即可)

接下来具体解释“净输了 mm 元之前,先净赢了 mm 元”的含义。背景是赌徒和另一个人在进行赌博,每个人的初始资产有 mm 元。其中一方输光所有的钱即为破产。“其净输了 mm 元之前,先净赢了 mm 元”,指的就是对手先破产。

同样的道理,可以把每一次有效实验看作是一次赌博。这里的 P 就是上面算出的概率,令 r=1−PPr=\frac{1-P}{P} 。甲先领先4分的概率是 11+r4\frac{1}{1+r^{4}} ,乙先领先4分的概率是 r41+r4\frac{r^{4}}{1+r^{4}} 。如果 P=12P=\frac12 ,两边各有一半的机会。

回到原题。甲的治愈率是50%,乙是80%。只看不打平的轮次,甲赢一轮的机会是20%,最后却先领先4分的概率是1/257,不到0.4%。
知乎原文

一道机器学习岗位面试题:平均要抛多少次硬币,才能出现连续两次正面向上?

这是一道某大厂的机器学习岗位的面试题。面试的过程有40分钟,一共三道题。前两道是概率题,最后一道是编程题。对于两道概率题,我当时马上给出了答案。但是我花了30多分钟攻编程题,最终没有想出思路。

第一道题是:抛一枚均匀的硬币若干次,直到出现连续两次正面向上,所需抛硬币总次数的数学期望是多少?

在回答这个问题之前,我们先来看另一个简单的问题:抛一枚均匀的硬币若干次,直到出现一次正面向上,所需次数的数学期望是多少?

这个模型是一个典型的几何分布。由于抛到正面的概率是 12\frac{1}{2} ,因此所需的试验次数是2次。也就是说,你可能抛1次就出现了正面,也可能抛十多次才出现了正面,但是平均来说,你需要抛两次才能出现正面。

现在的问题加大了难度,咋一看貌似不能用几何分布的思路去解决了。


我给出的思路是:

记 NkN_{k} =为了得到连续 kk 次正面向上必须的试验次数。

那么 E(Nk)E(N_{k}) 为所求。

这个解答最核心的式子是:

E(Nk|Nk−1)=Nk−1+p+(1−p)[1+E(Nk)]E(N_{k}|N_{k-1})=N_{k-1}+p+(1-p)[1+E(N_{k})]

首先 pp 是硬币正面向上的概率,在本题中 p=12p=\frac{1}{2} 。(也就是说本解法更具有一般性)

左边这个式子是说:已经知道前面花了几次才凑够连续 k−1k-1 个正面,现在来算,从第一抛到结束,平均一共要抛多少次。

目前已经出现连续 k−1k-1 次正面向上了,只差最后一步了。 E(Nk|Nk−1)E(N_{k}|N_{k-1}) 首先至少等于 Nk−1N_{k-1} ,因为我已经进行了 Nk−1N_{k-1} 次的试验,这即是右边的第一项。那么接下来的一步(我称之为关键步)有两种情况:如果是正面向上,那么大功告成。这一步只花 1 次,所以右边的第二项就是 pp 乘以 1。如果是反面向上,那么功亏一篑,从头再来,这对应着右边式子的第三项。为什么是 1+E(Nk)1+E(N_{k}) ?因为关键步也要算在内。

接下来用全期望公式。等到连续 k−1 个正面,有时花的次数多,有时花的次数少。前面是按其中一种情况来算,现在把所有情况按各自的概率平均一遍:

E(Nk)=E[E(Nk|Nk−1)]E(N_{k})=E[E(N_{k}|N_{k-1})]

=E(Nk−1)+p+(1−p)[1+E(Nk)]=E(N_{k-1})+p+(1-p)[1+E(N_{k})]

移项得 E(Nk)=1p+E(Nk−1)pE(N_{k})=\frac{1}{p}+\frac{E(N_{k-1})}{p}

根据数列的知识,可解得 E(Nk)=1p+1p2+……+1pkE(N_{k})=\frac{1}{p}+\frac{1}{p^{2}}+……+\frac{1}{p^{k}}

特别地,若取 p=12p=\frac{1}{2} ,那么E(N1)=1p=2E(N_{1})=\frac{1}{p}=2 ,这就是抛硬币出现一次正面所需次数的数学期望。

E(N2)=1p+1p2=6E(N_{2})=\frac{1}{p}+\frac{1}{p^{2}}=6 ,这就是本题答案。

如果取 p=16p=\frac{1}{6} ,计算 E(N3)=6+36+216=258E(N_{3})=6+36+216=258 ,这个可以解释抛一枚均匀的骰子若干次,平均要抛258次才能出现连续三次都是1点向上。

以上解法显得有些复杂,可能是因为其过于一般化。如果是单纯地在 p=12p=\frac{1}{2} 的条件下求 E(N2)E(N_{2}) ,肯定还有更简单的方法。希望大家贡献自己的智慧。


这道题我也写进了《大白话概率论》的面试题部分。书里换了个算法:还没抛到正面,和已经抛到一个正面,这两种情况分开算。

知乎原文

双色球是随机的吗?

双色球是中国福利彩票的一种玩法。

原文配图

你需要选择七个数字。其中前六个数字对应的是红球,红色球号码从1-33中选择;最后一个数字对应的是蓝球,蓝色球号码从1-16中选择。一般来说,蓝球是起决定作用的球。为了简单起见,本文只考虑蓝球。

有朋友问我:为什么在蓝球里,有几个数字(比如1)经常出现,而有几个数字(比如8)几乎不出现,这背后是不是有什么规律?

这引发了我的兴趣。于是我进行了一个简单的假设检验。

原假设:蓝色球的16个数字服从离散均匀分布,即它们是均匀随机出现的。这里先假设每期开奖相互独立。

备择假设:蓝色球的16个数字不是均匀随机出现的。

这是一个分布拟合检验。我首先假设每个数字出现的概率都是均等的,即不存在出现概率比其他数字高的数字,也不存在出现概率比其他数字低的数字。换句话说,数字1经常出现,数字8很少出现,仅仅是因为是“噪声”在起作用,是运气而已,而非这两个数字本来出现的概率不一样。

原文配图

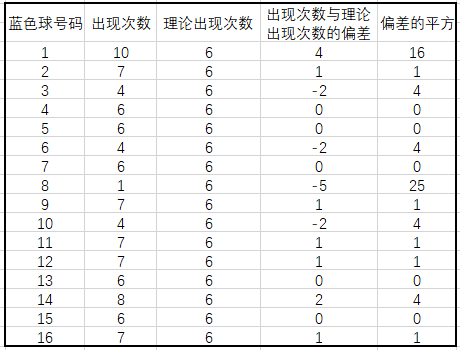
如上图所示,我截取了从2018年7月开始的96期数据。这96期里,1号出现了10次,最多;8号只出现了1次,最少。这个差距算不算大?接下来算一算。

如果蓝色球的16个数字是均匀随机出现的,那么每个球理论出现的次数为 9616=6\frac{96}{16}=6 次(上表中的第3列)。接下来计算出现次数与理论出现次数的偏差,比如1号球比理论出现次数高了4次,那么这个偏差就为4。为了消除正负号的影响,把偏差进行平方(线性回归中的最小二乘法也是这个原理)。最后一步是计算偏差的平方和。

这个分布拟合检验的核心思想是:如果偏差平方和越小,那么这些数字的分布越均匀。这是符合直观的,如果你没理解到这一点,不妨停下来再体会一遍。经过简单的计算得出偏差平方和是62。那这个数字是大还是小呢?这需要有一个严格量化的标准。

事实上对离散均匀分布的拟合检验有如下的结果:

偏差平方和理论出现次数近似服从χr−12\frac{\text{偏差平方和}}{\text{理论出现次数}}\ \text{近似服从}\ \chi^{2}_{r-1}

其中 rr 为可能的结果数,在这个例子中 r=16r=16,所以自由度是15。

查表得 626\frac{62}{6} 不在拒绝域内。这96期各号码出现的次数,没有偏得让我们怀疑它们的机会不一样。这里数的只是每个号出了几次,没看开奖顺序。

本文只是介绍简单的分布拟合检验。这个检验一般要求每个号码理论上至少出现5次。表里每个号码的理论次数都是6,可以做这个检验;只是样本不多,偏差很小的话不容易看出来。


如果双色球的出奖流程公平公正且号码随机,那么把时间花在研究彩票走势图上将是一件浪费时间的事情。这就好比你连续扔均匀的硬币5次,结果都是正面向上,但下一次再扔的结果是正面向上的概率不会减少。

另外,如何解释在近96次结果中,8号球只出现了一次的情况?如果事先就盯着8号看,96期里它恰好只出一次的概率约是1.3%。不信你可以自己做一个试验:找16个标有数字1-16的台球放进一个黑盒子中,有放回地抽96次出来然后记录结果,每次抽之前充分摇晃。首先通过结果你可以大体上看出,16个球中,每个球出现的次数大体上都在6次左右;另一方面,事先指定一个号,96次一次都没抽到,概率约是0.2%;如果16个号里随便哪个没抽到都算,概率约是3.2%。也有可能某个球出现了10次以上。

举另外一个有趣的例子:如果你抛一枚硬币,连续十次都是正面向上,你会不会认为这枚硬币有问题?一般来说我们有非常大的把握认定这枚硬币有问题。但是如果做这样的实验:一个报告厅内坐了1024(2的10次方)名学生,每名学生都发了一枚硬币。这1024枚硬币都是一样的,而且都是正常的硬币,即正反面均匀。接下来,大家各自独立地抛这枚硬币10次。可以算出,有约63%概率会出现至少一个“不幸”的学生,ta连续十次的结果都是正面向上。怎么算的?一个人没连出十次正面的概率是1023/1024,1024个人全没碰上,就把这个数取1024次方,大约是37%。用1减掉这37%,就是约63%。也就是说,哪怕这枚硬币是完全均匀完全公平的,仍然有概率出现极端情况,而且这个概率不算太低。如果你就是那个“不幸”的学生(设身处地地想一想),而且你不知道周围学生抛硬币的结果,那么你是不是会认为眼前的硬币是有问题的呢?

我还想举一个例子,这个例子想必很多人都听说过了。有一天杰克收到了一封信,这封信的内容是预测下一次足球比赛皇马会赢。他没有在意。几天后结果出来了,皇马果真赢了。然后他又收到了第二封信,说下一场比赛巴萨会赢,果不其然,巴萨赢了。这样连续十次,杰克都收到了正确的预测信。这个时候,如果第11封信写着“支付1000英镑,我会告诉你下一场比赛的结果,然后你可以通过赌球赚取更多的钱,快加入我们吧!”杰克很可能会稀里糊涂地上钩。

事实上,写信的人在第一场比赛之前,写了1024封信,其中512封信预测皇马赢,另外512封预测皇马没赢,然后分别邮寄给不同的人。如果皇马真的赢了,写信人就只给猜对的512户继续寄:一半收到“巴萨会赢”,另一半收到“巴萨不会赢”。后面每场比赛都这样分。那么最后,写信人可以稳定地保证有一个人连续收到了十次正确的预测信。事实上,一开始可以寄更多信,比如2048、4096这样的量级。现在是互联网时代,一次性群发个几十万封邮件也是很常见的操作,那么在这个数量级下,会出现好几百个连续十次收到正确预测信的人。如果缺乏概率的思维,很有可能会上当受骗。

知乎原文

前10次投篮中命中了9次,那么下一次命中的概率是多少?

篮球巨星徐坤在前10次投篮中命中了9次,他下一次投篮命中的概率是多少?这里假定每次投篮的结果是相互独立的,比如:第一次投篮的成功与否,不会影响后续投篮的命中结果。

这个问题可以一般化:在一系列独立试验中,每次试验要么成功要么失败。前 rr 次试验中成功了 kk 次,那么下一次试验成功的概率是多少?

当然是 kr=0.9\frac{k}{r}=0.9 呀!

文章结束。

原文配图

等等,我贝叶斯有话说!

解决这个问题最自然的方法是估计出参数 pp (每次试验的成功概率)。常见的估计方法有矩估计、最大似然估计和贝叶斯估计。矩估计和最大似然估计的结果是 p=0.9p=0.9 ,贝叶斯估计中的后验期望估计的结果是 p=0.83p=0.83。这些都是概率论中最基本的问题,因此这里只给出结果而略去过程。另外可以看出贝叶斯估计和矩估计的结果是不同的,我将在后文给出一个直观的解释。

本文的重点是:如果我不想估计出参数 pp ,而只是想直接求出下一次试验成功的概率,有何办法?

记 A=A= 第 r+1r+1 次试验成功, B=B= 前 rr 次试验成功。取 pp 的先验分布为均匀分布。那么有:

P(A|B)=P(AB)P(B)=∫01P(AB|p)dp∫01P(B|p)dpP(A|B)=\frac{P(AB)}{P(B)}=\frac{\int_{0}^{1}P(AB|p)dp}{\int_{0}^{1}P(B|p)dp}

=∫01Crkp·pk(1−p)r−kdp∫01Crkpk(1−p)r−kdp=\frac{\int_{0}^{1}C_{r}^{k}p·p^{k}(1-p)^{r-k}dp}{\int_{0}^{1}C_{r}^{k}p^{k}(1-p)^{r-k}dp} (*)

注意到有恒等式(这个恒等式来源于伽马函数与贝塔函数的关系): ∫01pk(1−p)n−kdp=k!(n−k)!(n+1)!\int_{0}^{1}p^{k}(1-p)^{n-k}dp=\frac{k!(n-k)!}{(n+1)!}

因此(*) =k+1r+2=\frac{k+1}{r+2} .

这个结果和贝叶斯估计是一样的,但是和矩估计与最大似然估计不一样。我认为贝叶斯估计更合理些。

举个极端的例子:假如徐坤投篮了三次,一次都未中,那么按照矩估计,他下一次命中的概率为0;而如果按照贝叶斯估计,他下一次命中的概率为0.2。事实上0.2显得更合理些,因为仅凭三次试验失败而完全否决一个人未免显得残忍。同样地,考虑另一个极端情况:假设徐坤三次投篮都命中了,按照矩估计,他下一次命中的概率为1;而如果按照贝叶斯估计,他下一次命中的概率为0.8。0.8这个结果也更合理些,因为三次投篮成功不代表以后投篮都成功。

知乎原文

还在纠结三门问题?不如用代码暴力验证(附Python代码)

三门问题是一个经常在各大论坛里出现的问题。对于大众来说,三门问题可以说是最具有富有争议性的数学问题之一。三门问题具体表述如下:

有一个电视游戏竞猜节目,主持向挑战者(也就是你)展示了三扇门。有一扇门之后是一辆小轿车,另两扇门之后是空房间。主持人事先知道门后是什么。

游戏分为三步:首先,你选择一扇门;然后,主持人将会打开剩余的两扇门中的一扇,展示一个空的房间(当然他从未打开那扇后面藏有轿车的门);最后,你可以选择是仍然选择你开始选择的那扇门,还是选择去打开另一扇仍然关闭的门。 如果你选择换门,则你获得小轿车的概率是多少?

咋一看,貌似这道题的答案是二分之一。因为不管你选择哪扇门,主持人都会一边向你坏笑一边打开一扇空门,主持人打开空门这个动作看起来是多余的。

但是答案是:选择换门是更好的策略。理论证明可以见我的这篇文章:

[终结数学月经题系列2]三门问题

如果你不想看理论证明,或者不认同我的答案,或者看完理论解释后仍然云里雾里,怎么办?亲自用程序模拟一遍或许对你有帮助。

在下文,我给出了我的编程模拟的过程。我的代码是用Python写的,关键的地方都加了注释。

原文配图


import random
buhuan=0 #不换
huan=0 #换

for i in range(10000): # 做10000次实验
    car = random.choice([1,2,3]) #汽车随机出现在三扇门之中
    challenger = random.choice([1,2,3]) #挑战者随机选择了一扇门
    #以下五行代码:主持人随机选择一扇门,这扇门不是挑战者选择的门,也不是汽车所在的门
    host_list = [1,2,3]
    host_list.remove(challenger)
    if car in host_list:
        host_list.remove(car)
    host = random.choice(host_list)
    
    if challenger == car:
        buhuan = buhuan+1 #如果挑战者一开始选的门背后有汽车,那么不换是对的
    else:
        huan = huan+1 #如果挑战者一开始选的门背后没有汽车,那么换是对的
    
print(buhuan)
print(huan)

换门赢的次数大约是不换门的两倍!你可能也发现了,代码选出了主持人开的门,最后却没用到它。因为主持人一定会开一扇空门,只要你一开始选错,剩下那扇没开的门后面就一定是车。


开个脑洞,把题目稍微做变动:主持人事先不知道车在哪个门后面。如果主持人在第二步打开的门刚好是有汽车的门,那么游戏重来。在这种情况下,换门与不换门孰优孰劣?

import random
buhuan=0
huan=0

for i in range(1000):#这意味着我们要做1000次实验
    car = random.choice([1,2,3])#汽车随机出现在三扇门之中
    challenger = random.choice([1,2,3])#挑战者随机选择了一扇门
    #以下三行代码:主持人随机选择一扇门,这扇门不是挑战者选择的门
    host_list = [1,2,3]
    host_list.remove(challenger)
    host = random.choice(host_list)
    
    if host == car:
        continue # 开到车,这一轮不计入结果

    if challenger == car:
        buhuan = buhuan+1
    else:
        huan = huan+1

print(buhuan)
print(huan)

只看主持人开到空门的那些轮,换门和不换门赢的次数差不多。


那么问题又来了,假如我不知道主持人事先是否知道车在哪扇门后面,那么挑战者应该换门吗?

按上面两种玩法,我还是会换。主持人知道车在哪,换门赢的机会是三分之二;他不知道、只是碰巧开到空门,换不换都是一半。所以换门至少不吃亏。至于换门到底有多大机会赢,还得看你看到空门的那些轮里,这两种情况各占多少。

知乎原文

自我指涉——一个有趣且深奥的哲学问题

自我指涉(self-reference)简称自指,是一个逻辑学的概念。通俗来说,一个东西在描述自己,这就叫做自我指涉。

自指是奇妙的哲学问题,也是一个强大的工具。罗素在朴素集合论引入自指引发了第三次数学危机,哥德尔引入自指证明了大名鼎鼎的哥德尔不完备定理,而图灵机的自指则导致了停机问题等等。

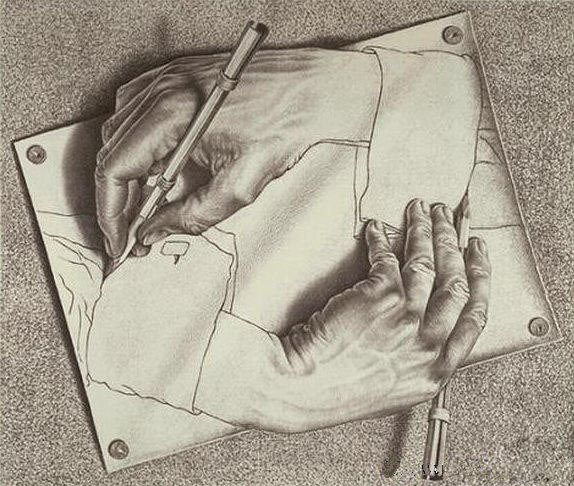
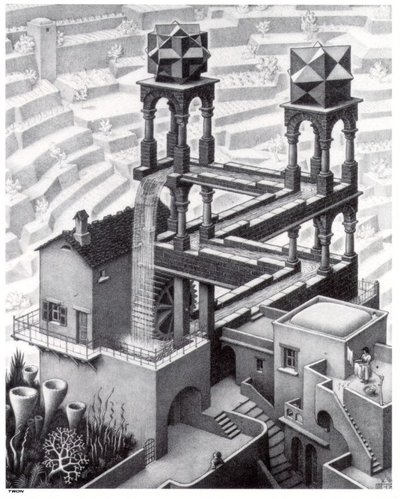
自我指涉还能出现在音乐、文学、美术领域。下面两张图是著名艺术家埃舍尔的画作。

原文配图
埃舍尔用精妙绝伦的绘画完美地表现出自我指涉的概念
原文配图
这样的瀑布可能存在吗?

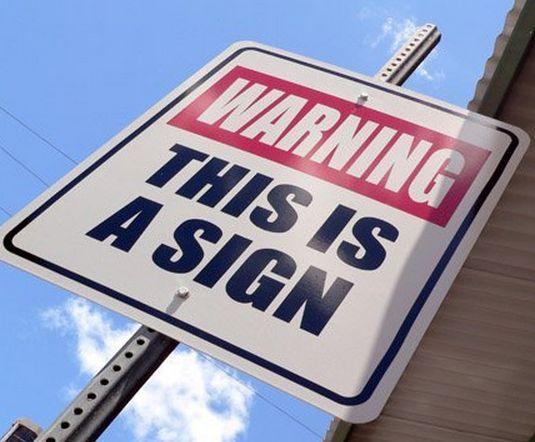
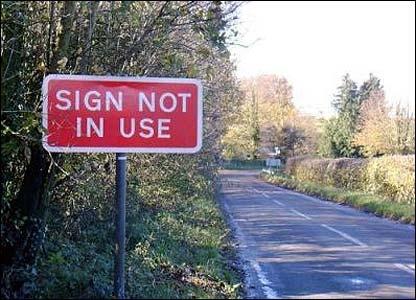
以下两张标示是不是让你哭笑不得呢?

原文配图
原文配图

本文不打算给大家讲述枯燥的定义,而是通过一些奇妙的自指语句传达出自我指涉的有趣之处。自指语句是很难想到的。下文的自指语句大多来源于matrix67的博客以及这篇博文:

武辰:自我指涉——一个有趣且深奥的哲学问题

这句子很短。

我是这个句子的主语。

这个句子有八个字。

的写着倒是话句这。

这是一个问句吗?

这个句子是不是一个自我指涉的句子?

从前有座山,山里有座庙,庙里有个老和尚和小和尚,有一天老和尚对小和尚说:“从前有座山,山里有座庙,庙里有个老和尚和小和尚,有一天老和尚对小和尚说……”

上海一男子因造谣称自己因造谣而被拘留15日而被拘留15日。(严格来说这条语句不是语言本身的自指,而是说话者的自指)

问:人类的本质是复读机吗?答:人类的本质是复读机吗?

这句话是错的。

这个句子又两个错悟。

这个句子又三个错悟。

我只喜欢那些不被任何人喜欢的人。

这个句子会让你联想到特朗普吗?

公司里整顿拖延症的会议因为太多人迟到而被迫取消。

有没有什么句子会莫明其妙地包含“哈密瓜”这个词?

这句话在自我指涉。

我不会通过文字来表达我的任何想法。

凡事绝对的话一定是错的。

人们在历史中得到的唯一的教训是人类在历史中不会得到任何教训。

如果“真”和“假”的意思颠倒一下,这个句子就不会是错的了。

这个世界上有三种人:会数数的和不会数数的。

如果我再乱发毒誓,我就被天打雷劈!

这个世界上有10种人:会二进制的和不会二进制的。

这个世界上有10种人:会二进制,不会二进制的,和错把它当成二进制的。

这个世界上有两种人:认为这个世界上有两种人的,和不这么认为的。

世上没有“绝对”。

迷信会带给人厄运。

87.5%的统计数据都是编造出来的。

所有普遍化的原理都是有问题的。

所有的规则都可以被打破,这一条除外。

我他妈的从不骂脏话。

他们造的谣有一半都是真的。

和以往一样,你做的异常出色。

在我讲话之前,有一些事情我想先交待一下。

我也想变得很有耐心,但这需要花很长的时间。

我从不做任何预言。我现在不会,将来也永远不会。

我曾经是一个优柔寡断的人,但现在我不敢肯定我是这样的人。

我是我所见过的最不谦虚的人。

我是我所见过的最谦虚的人。

那些去看心理医生的人脑子都有问题。

那地方太拥挤了,以至于没有人会去那里。

成功的两条秘诀: 1. 不要把你知道的东西都告诉别人。

自大是一种错误,但我没有任何错误。

我经常讨厌两种人:一是有种族歧视的人,二是黑人,三是不识数的人,四是经常讨厌别人的人。

我肯定是这个星球上的最后一个乐观主义者了。

Never say never!

我们要打破一切规则!

我们必须要坚持自由意愿,我们别无选择!

考虑由所有从未被考虑过的集合所组成的集合。

排中律的定义:你要么相信排中律,要么不相信排中律。

Hofstadter法则:任何事花费的时间都比你想象中的长,即使你把Hofstadter法则也考虑进来。

定理:所有的数都可以用20个以内的汉字表达(比如25852016738884976640000可以表达为“二十三的阶乘”,100000000000000000000000可以表达为“一后面二十三个零”)

证明:反证,假设存在不能用20个以内的汉字表达的数,则必有一个最小的不能用20个以内的汉字表达的数,而这个数已经用“最小的不能用20个以内的汉字表达的数”表达出来了,矛盾。

哲学考试,教授出题:“这就是题目,请做答”。某学生挥笔写下几个大字:“这就是答案,请给分”。

一个逻辑学家救了一个外星人。外星人很感谢他,给了他一个问问题的机会(因为外星人无所不知)。

于是,逻辑学家问:“我现在应该问的最好的问题是什么,它的答案又是什么?”

外星人顿了一下,然后回答:“最好的问题就是你刚才问的那个问题,问题的答案就是我现在给你的这个答案。”


自指语句不仅存在于人类自然语言上,还能出现在计算机语言中。把下面代码用Python运行,试试看会发生什么。

s = 's = %r\nprint(s%%s)'
print(s%s)

知乎原文

财富分配可能天生不公平(附Python代码)

收入分配是福利经济学中的重要话题。假设有5个人的收入分别是[99.5,101,100.5,100.2,98.6],那么可以直观地看出这5个人的收入比较均匀。如果有另外5个人的收入分别是[100,520,13,26,46540],那么可以直观地看出这5个人的收入不均匀。

基尼系数是衡量一个地区居民收入差距的常用指标。它的取值范围是[0,1]。基尼系数越接近0表明收入分配越趋向平等。


接下来我通过一个简单的游戏来模拟财富分配(在本文中,财富分配等同于收入分配)。假设有一根特别长(可以假设为100公里)的面包,上帝随机在这个面包切99999刀(具体来说,如果把面包固定在数轴上,面包的左端点对应零点,那么每一刀都独立地在这 100 公里里随机选个位置)。切完之后面包可以分为十万份。接下来把这十万份小面包分给十万个人。假定面包量意味着收入,那么这十万个人的收入分配是公平的吗?

直观来说,这个分配规则十分公平,因为每个人被分配到的面包量应该是差不多的。最直接的想法是每个人的收入服从均匀分布。如果不是均匀分布,那么正态分布也是一个不错的答案,因为大多数人分到的面包量应该差不多,且只有少数人获得非常大或者非常小的面包量,这两条性质几乎完整地刻画了正态分布的规律。然而理论计算以及程序模拟的结果都与均匀分布或者正态分布大相径庭。

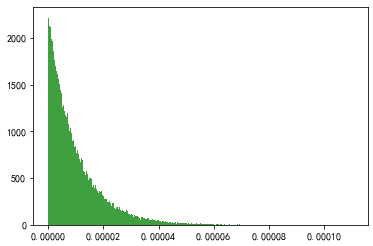
我做了多次 Python 模拟。下图是当时画的直方图,横轴是每段占整条面包的比例。短的面包段很多,长的很少。这跟正态分布先往上、再往下的样子不一样。

原文配图

为什么会这样?先看最左边那段:它要超过 1 米,前 1 米就得一刀都没挨到。一刀避开这 1 米的机会是 99.999%,99999 刀都避开,机会就只剩约 37%。如果要超过 2 米,照样算,机会就只剩约 14%。

其他位置的面包段,长度的分布也一样。刀数很多时,每段的长度就很接近指数分布。

按这个切法,切得足够多时,基尼系数会接近 0.5。每个人拿到大块面包的机会一样,可最后拿到手的大小还是能差很多。

不过这个结论可能并非那么反直觉。哪怕财富在一个从 0 开始的区间里均匀分布,基尼系数也有 13\frac{1}{3} (这个例子不是那么准确,因为均匀分布不代表所有人的财富是均匀的,均匀分布只是表示每个财富值的概率都是相等的;事实上,如果财富分配绝对均匀,那么财富的分布应该是退化分布,对应地,退化分布的基尼系数为0)。这是因为即使是均匀分布也会有不小的方差存在,而方差会使得大家的收入分配不均。

我在本文用一个简单的模型去模拟财富分配,仅是本人的一家之言。现实生活中的财富分配情况远远比这个模型复杂。但尽管如此,我认为这个结论也是具有一定的启发性的。


以下是Python代码:

# -*- coding: utf-8 -*-
"""
@author: 武辰
"""
import matplotlib.pyplot as plt
import random
import numpy as np 
#打算要在面包上切n刀
n=99999
#cut_list的元素是每一刀对应的数轴上的值,它服从均匀分布
# alocate_list 记录每段占整条面包的比例
cut_list=[]
#生成cut_list,并排序
for i in range(n):
    x=random.random()
    cut_list.append(x)
cut_list.sort()
# 把左右端点也放进去,再用相邻坐标相减
alocate_list = np.diff([0.0, *cut_list, 1.0])
#画出每一刀的位置的直方图
brr=cut_list
plt.figure("cut_list")
n, bins, patches = plt.hist(brr, bins=500,facecolor='green', alpha=0.75)  
plt.show()
#画出每一个人得到的面包量的直方图
arr=alocate_list
plt.figure("alocate_list")
n, bins, patches = plt.hist(arr, bins=500,facecolor='green', alpha=0.75)  
plt.show()
#解决matplotlib显示中文乱码问题
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
fig, ax = plt.subplots()
#画出洛伦兹曲线并计算基尼系数
def Gini():
    #计算数组累计值,从 0 开始
    wealths = alocate_list
    cum_wealths = np.cumsum(sorted(np.append(wealths, 0)))
    sum_wealths = cum_wealths[-1]
    #累积占比
    xarray = np.arange(len(cum_wealths)) / (len(cum_wealths) - 1)
    upper = xarray
    yarray = cum_wealths / sum_wealths
    #绘制基尼系数对应的洛伦兹曲线
    ax.plot(xarray, yarray)
    ax.plot(xarray, upper)
    ax.set_xlabel(u'人数累积占比')
    ax.set_ylabel(u'面包量累积占比')
    plt.show()
    #计算曲线下面积的通用方法
    B = np.trapezoid(yarray, x=xarray)
    #总面积 0.5
    A = 0.5 - B
    G = A / (A + B)
    return G
a=Gini()
print(a)

知乎原文

麻将的掷骰子环节是公平的吗?

春节回到家,文体两开花。

杰克变狗蛋,露西成翠花。

穿上花棉袄,套上棉毛衫。

亲戚齐上门,一起打麻将。


麻将中的先手与后手在赢的概率上有非常细微的差别。先手能够先于其他人调整第一轮的牌。拿天胡举个例子:庄家起手就凑齐了能胡的牌,这就叫天胡。下面我们只看一种玩法:用骰子决定谁先打。

原文配图

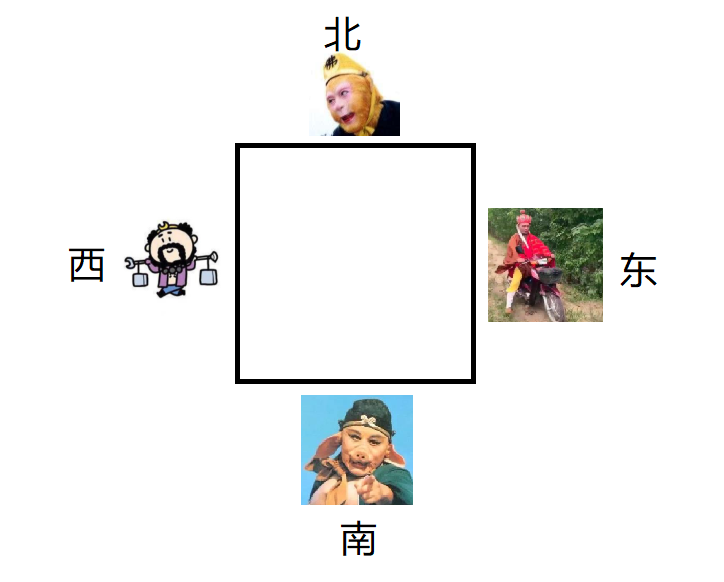
这套玩法是由上局的赢家(在本文称为“抛骰者”)抛两个骰子,然后算出两个骰子点数之和m,再算出m除以4的余数k。从抛骰的人算第 1 个,逆时针数。余数是几,就数到第几个;余数是 0,就数到第 4 个。

举个例子,如下图所示:假设上局孙悟空赢了。孙悟空在本局中抛出5点和2点。由于7除以4余3,所以从孙悟空开始逆时针数,第三个是猪八戒。因此这局中猪八戒是先手。

原文配图

那么问题来了,东南西北四个人成为先手的概率一样吗?

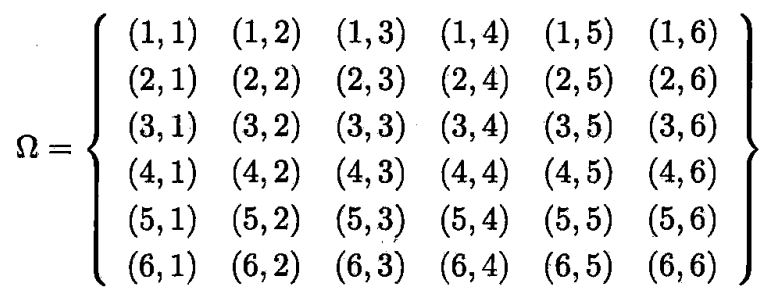
我们可以暴力枚举出抛两枚骰子的所有可能:

原文配图

以 XX 表示两骰子点数之和,则易计算出 XX 的分布列为:

原文配图

以Y2Y_{2} 表示 XX 除以4的余数,则 Y2Y_{2} 的分布列为:

原文配图

假设孙悟空(北)是上局的赢家,那么余数1、2、3、0分别对应北、西、南、东。可以看出抛骰者是先手的概率是 14−136\frac{1}{4}-\frac{1}{36} ,比 14\frac{1}{4} 小,这个结果不利于上局的赢家。而抛骰者的对家是先手的概率是 14+136\frac{1}{4}+\frac{1}{36} ,比 14\frac{1}{4} 大。

有些地方的规则是只抛一枚骰子,用一枚骰子的结果除以4取余数;或者抛两枚骰子,把更大的点数除以4作余数。可以计算出这两种方法使得概率分布更加不均匀,即让结果更加不公平。


那么可不可以通过改进抛骰子的规则,使得四个人都是先手的概率是一样的?这个问题暂时留给读者思考,如果有机会我将更新这个问题。

我先给出一个思路:在我所在的城市,抛骰子要经过两轮。由上局赢的人抛第一轮的骰子。第一轮骰子的结果所指向的人继续抛第二轮骰子。最后由第二轮的结果决定谁是先手。

每轮都掷两枚骰子。两轮掷完,按北、西、南、东排,四个人当先手的机会分别是 1296 种结果里的 326、324、322 和 324 种。跟四分之一比,最多只差约千分之 1.5;直接拿最高和最低比,则差约千分之 3.1。这个结果在直观上也很好理解:第一轮骰子的结果不利于第一轮的抛骰者,而利于第一轮抛骰者的对家。因此第一轮抛骰者的对家最容易成为第二轮抛骰者。而不管哪轮,抛骰者都是处于不利情况的。因此正如风水轮流转,两次抛骰子的结果会产生一定的抵消。

另一个粗暴的思路是,六面的骰子只用前四面。如果出现5和6,则重新抛。但是这个方法没有充分利用骰子的信息,不符合数学美的原则。一个类似的问题是:“一枚均匀的硬币可以得出两个概率相等的结果,那如何操作才能得出三个概率相等的结果呢?”


本文的灵感来源于《数学的实践与认识》期刊中第45卷的《麻将桌上的一个概率问题》一文。

这道麻将题我也写进了《大白话概率论》,用它讲怎么把余数相同的几种情况加起来。

知乎原文

[机器学习]学习笔记:PCA(主成分分析)的直观理解

PCA是一种基本的数据降维技术。在知乎或者百度搜索PCA,会找到很多关于PCA的介绍。

我喜欢在直观上理解数学知识。因此我打算从直观的角度把我对PCA的理解写出来。


我以最简单的模型为例:如何把二维数据压缩至一维。

数据压缩的目标是:让新数据的方差尽可能地大。这样的标准能使得新数据尽可能地不丢失原有数据的信息,因为方差越大,数据间的差异越大。

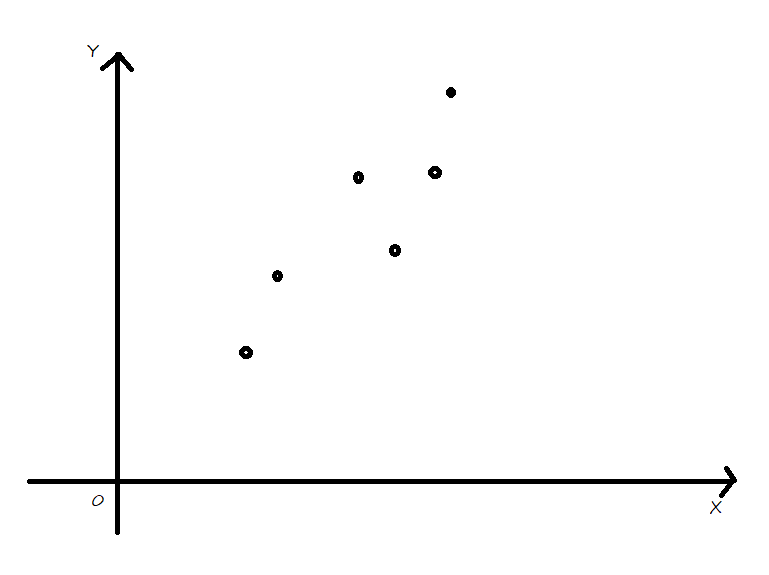
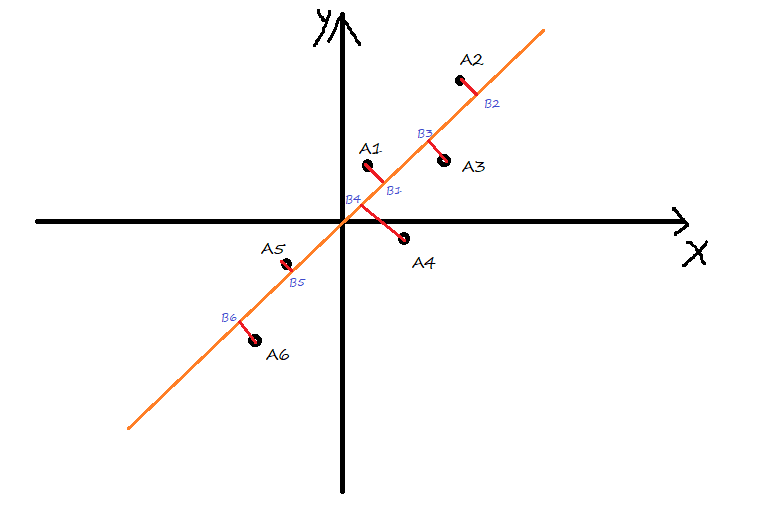
如下图所示:有六个点,每个点有两个特征,分别对应x轴和y轴。我们需要把他们压缩成一维的数据,即每个点只有一个特征。

因此要寻一条直线,让所有点投影到该直线上。该直线上的刻度即为新数据的值。

原文配图

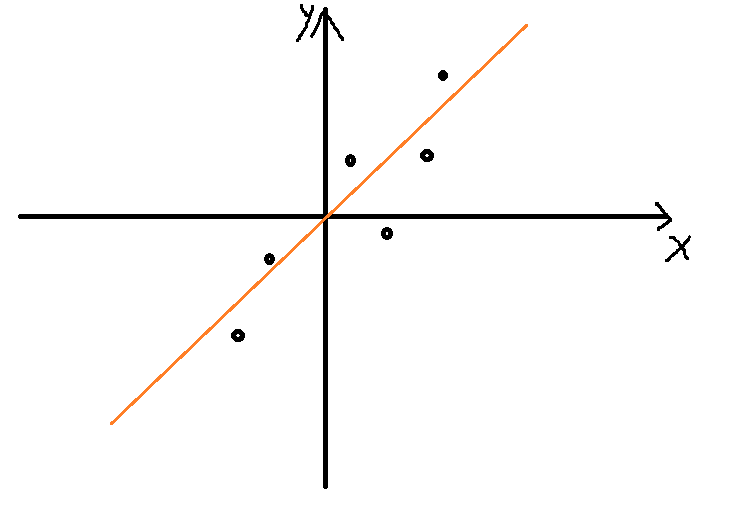
首先进行中心化处理。中心化的好处在于,我们寻求的直线必定经过原点。如下图所示。我们只需从所有经过原点的直线中,找一条直线,使得各个数据的方差最大。

原文配图

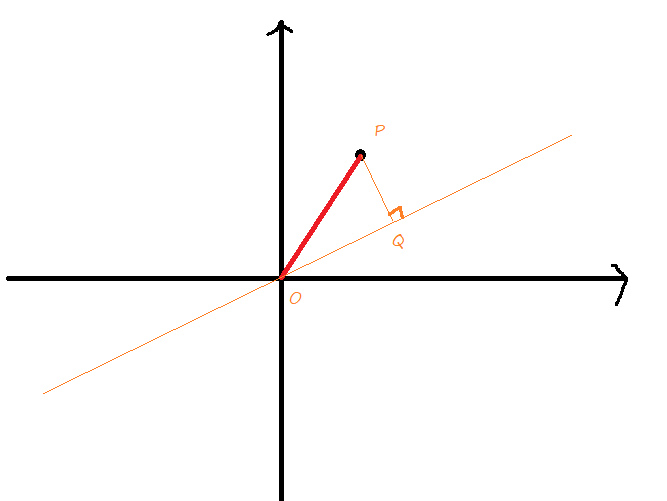
如下图所示,设P是样本的一个数据。注意到这样一个性质:由于OP的距离是定的,因此过原点作任何一条直线,记Q是P在该直线上的投影点,都有 OQ2+PQ2OQ^{2}+PQ^{2} =定值。

原文配图


显然知道 OQOQ (带正负号的长度)是数据 P(xp,yp)P(x_{p},y_{p}) 压缩后的值。

那么如下图所示:对于 A1A_{1} 到 A6A_{6} 六个点,分别作直线的垂线,交直线于 B1B_{1} 到 B6B_{6} 六个点。直线可以看做数轴,坐标系的原点就是数轴的原点。记 B1B_{1} 到 B6B_{6} 六个点的刻度分别为 b1,…,b6b_{1},…,b_{6} 。那么 b1,…,b6b_{1},…,b_{6} 就是降维后的数据。

原文配图

由于数据已经做了中心化处理,所以 b1+b2+…+b6=0b_{1}+b_{2}+…+b_{6}=0 。一般性的具体证明如下:沿着这条直线选一个正方向,记这个方向的单位向量为 (ux,uy)(u_x,u_y) 。第 i 个点投上去,读到的刻度就是 bi=uxxi+uyyib_i=u_xx_i+u_yy_i 。把六个刻度加起来:中心化之后,横坐标加起来是 0,纵坐标加起来也是 0,所以六个刻度的和也是 0。

也就说明 bb 的均值为0。那么 bb 的方差为: b12+b22+b32+b42+b52+b62n\frac{b_{1}^{2}+b_{2}^{2}+b_{3}^{2}+b_{4}^{2}+b_{5}^{2}+b_{6}^{2}}{n} .

回想我们的目标是让压缩后的数据方差最大,即让 ∑i=16bi2\sum_{i=1}^{6}{b_{i}^{2}} 最大。

记点 AiA_{i} 到直线的距离为 did_{i} ,那么有 di2d_{i}^{2} + bi2b_{i}^{2} =定值。

于是 ∑i=16bi2+∑i=16di2\sum_{i=1}^{6}{b_{i}^{2}}+\sum_{i=1}^{6}{d_{i}^{2}} =定值。

使 ∑i=16bi2\sum_{i=1}^{6}{b_{i}^{2}} 最大,那么等价于 ∑i=16di2\sum_{i=1}^{6}{d_{i}^{2}} 最小。

到这里,问题就差不多解决了。后面的步骤和网上其他方法是一样的。

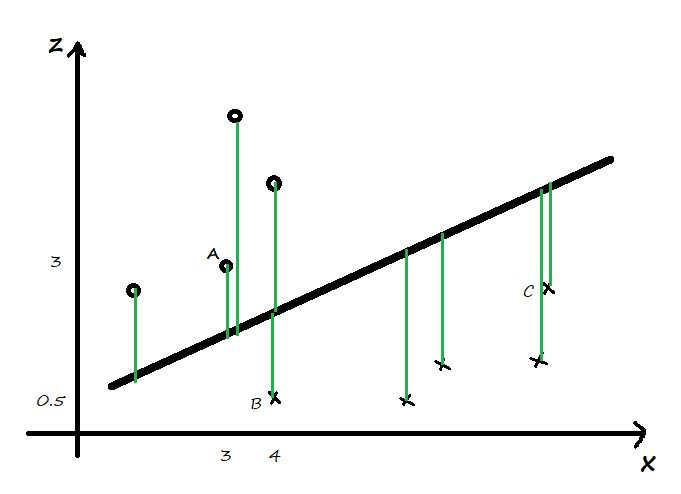
这个结果是很美妙的,我忍不住和一元线性回归作比较。如下图所示,一共有九个点。我们要进行一元线性回归,所采取的策略是让平方损失最小,通俗地来说,就是让九条绿线的平方和最小。

原文配图

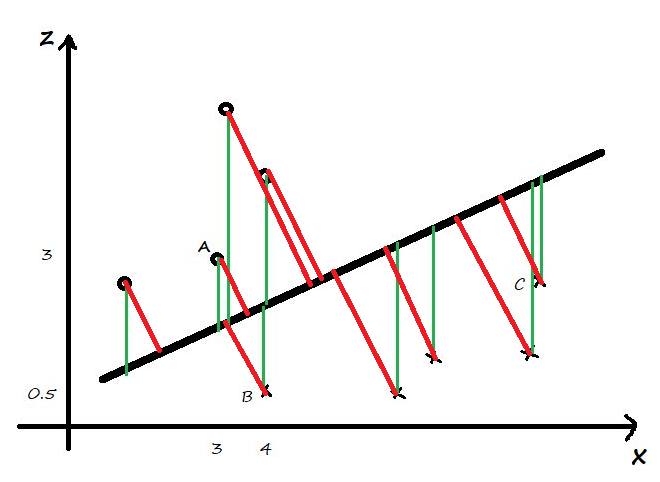
如果是采用PCA,如下图所示,我们采取的策略是让九条红线的平方和最小。

原文配图

图里的两种画法,量的不是同一段距离。一元线性回归是给定横坐标,猜纵坐标,所以量的是竖着的绿线。PCA 是把整个点投到直线上,所以量的是垂直于直线的红线。

类似地,对于n维数据,投影到更小的k维空间也能同样地进行类比。