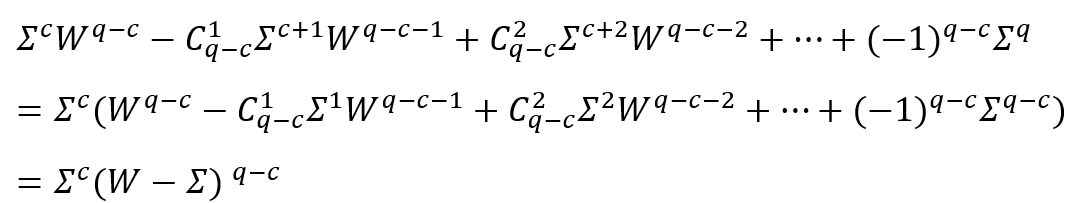武辰作品索引

知乎作品库

文章 · 5

知乎原文

不等概率的负二项分布(帕斯卡分布)

这是我在研究生期间的一个小发现。背景是攻克软件工程领域的一个理论证明。我把这个发现抽象为“不等概率的负二项分布”。

考虑一连串伯努利实验,每次成功的概率是 pp 。当实验次数为 nn 时,成功次数 cc 服从二项分布;反过来,当成功次数为 cc 时,实验次数服从负二项分布。

比如不断抛骰子,抛了 nn 次骰子,1点向上的概率为 pp ,1点向上的次数为 kk , kk 服从二项分布,即

k∼N(n,p)k\sim N(n,p)

概率分布率为 P(K=k)=Cnkpk(1−p)n−kP(K=k)=C_{n}^{k}p^{k}(1-p)^{n-k}

反过来,出现了 kk 次1点向上,那么抛骰子的次数 nn 服从帕斯卡分布

n∼NB(k,p)n\sim NB(k,p)

概率分布率为 P(N=n)=Cn−1k−1pk(1−p)n−kP(N=n)=C_{n-1}^{k-1}p^{k}(1-p)^{n-k}

我的发现是:考虑一连串伯努利实验,每次成功的概率从概率列表 [w1,w2,...wt][w_{1},w_{2},...w_{t}] 中等可能选择一个。当成功了 cc 次时,总实验次数 nn 的概率分布律是什么?

负二项分布是其中的特例,即概率列表为 [w,w,...w][w,w,...w] 。

为了方便理解,先以一个简单的例子作引子:

假设概率列表中一共有三个元素[w1,w2,w3][w_1,w_2,w_3 ] ,随机从列表中挑一个元素出来,然后进行实验,实验成功的概率是该元素的值。在实验成功2次的情况下,求总实验次数为3次的概率:

总的来说,要分两种情况:(第一次成功、第二次失败、第三次成功)和(第一次失败、第二次成功、第三次成功)。为了层次分明,我定义这两种情况为“大情况”。

先看第一种大情况:(第一次成功、第二次失败、第三次成功)。

在三次试验中,每次试验有三个可供选择的元素,那么一共有27种情况:(第一次选择了第一个元素、第二次选择了第一个元素,第三次选择了第一个元素)……我把这27种情况定义为27种小情况。

第一个元素实验成功的概率是第一个元素的值,即w1w_1。同理,第一个元素失败的概率是1−w11-w_1 。

那么在第一种大情况(第一次成功、第二次失败、第三次成功)中,每一种小情况发生的条件下,总试验次数为3次的概率穷举如下:

$w_1 (1-w_1) w_1 , w_1 (1-w_1) w_2 , w_1 (1-w_1) w_3\\ w_1 (1-w_2) w_1 , w_1 (1-w_2) w_2 , w_1 (1-w_2) w_3\\ w_1 (1-w_3) w_1 , w_1 (1-w_3) w_2 , w_1 (1-w_3) w_3\\ w_2 (1-w_1) w_1 , w_2 (1-w_1) w_2 , w_2 (1-w_1) w_3\\ w_2 (1-w_2) w_1 , w_2 (1-w_2) w_2 , w_2 (1-w_2) w_3\\ w_2 (1-w_3) w_1 , w_2 (1-w_3) w_2 , w_2 (1-w_3) w_3\\ w_3 (1-w_1) w_1 , w_3 (1-w_1) w_2 , w_3 (1-w_1) w_3\\ w_3 (1-w_2) w_1 , w_3 (1-w_2) w_2 , w_3 (1-w_2) w_3\\ w_3 (1-w_3) w_1 , w_3 (1-w_3) w_2 , w_3 (1-w_3) w_3\\ $

以上27个概率相加,恰等于:

$(w_1+w_2+w_3)(1+1+1)(w_1+w_2+w_3)-(w_1+w_2+w_3)^3 \\ =3(w_1+w_2+w_3)^2-(w_1+w_2+w_3)^3 $

记事件A=总试验次数为3次,且满足第一种大情况。

则P(A)

=P(A|小情况1)P(小情况1)

+ P(A|小情况2)P(小情况2)

+…… cc

+ P(A|小情况27)P(小情况27)

由于每一种小情况的概率相等,都是 127\frac{1}{27} ,

所以P(A)=2(3(w1+w2+w3)2−(w1+w2+w3)3)27P(A)= 2\frac{ (3(w_1+w_2+w_3)^2-(w_1+w_2+w_3)^3)}{27}

同理,在第二种的大情况(第一次失败、第二次成功、第三次成功)下,结果与第一种大情况一样。

因此P(总试验次数=3次)= 2(3(w1+w2+w3)2−(w1+w2+w3)3)272\frac{ (3(w_1+w_2+w_3)^2-(w_1+w_2+w_3)^3)}{27}

以上是简单的一个特例。一般地:一共有 WW 个元素(对应于概率列表中一共有 WW 个元素),试验成功的次数为 cc ,则总试验次数的概率分布是怎样的?或者总试验次数为 qq 的概率是多少?

首先对大情况进行分类:“试验成功 cc 次,总试验次数为q”,当且仅当“前q-1次试验验成功了 c−1c-1 次,且最后一次试验成功”。

在前 q−1q-1 次试验中成功了 c−1c-1 次,这样的可能性有 Cq−1c−1C_{q-1}^{c-1} 种,那么一共有 Cq−1c−1C_{q-1}^{c-1} 种大情况。

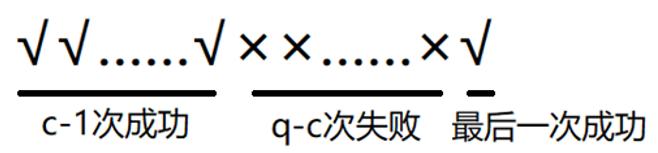
先对第一种大情况进行讨论。我把第一种大情况定义为前 c−1c-1 次成功、接着 q−cq-c 次失败、最后一次成功。如下图所示。

原文配图

这个大情况又可以分为 WqW^{q} 个小情况。因为一共有 qq 次试验,每次试验有 WW 个元素可供选择。每个小情况的发生概率都是一样的,即 1Wq\frac{1}{W^{q}} 。

对这 WqW^{q} 个小情况进行穷举是不现实的。不过可以参考上面特例的穷举思路。首先考虑第一种小情况(我把第一种小情况定义为每次都恰好选到了第一个元素)的概率。下图表示第一种大情况中,在第一种小情况的条件下,总试验次数为q的概率:
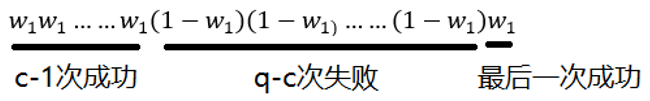
原文配图

在第一种大情况中,这样的式子有 WqW^{q} 个。每个式子都是这样的结构(即: qq 个因子的乘积中,前c-1个因子是 wiw_{i} 的形式,中间 q−cq-c 个因子是 1−wi1-w_{i} 的形式,最后一个因子是 wiw_{i} 的形式)。这 WqW^{q} 个式子中,虽然结构不变,但是各个因子的下标是改变的。根据二项式定理,这 WqW^{q} 个式子的概率之和为(其中 Σ=∑i=1Wwi\Sigma = \sum_{i=1}^{W}{w_{i}} ):

原文配图

记A=总试验次数为 qq 次,且满足第一种大情况。

则由全概率公式:P(A)

= P(A|小情况1)P(小情况1)

+ P(A|小情况2)P(小情况2)

+……

+ P(A|小情况 )P(小情况 )

= Σc(W−Σ)q−cWq\frac{\Sigma^{c}(W-\Sigma)^{q-c}}{W^{q}}

又因为总共有 Cq−1c−1C_{q-1}^{c-1} 种大情况。每种大情况都是对称且互斥的,所以P(总试验次数为 qq 次) = Cq−1c−1Σc(W−Σ)q−cWqC_{q-1}^{c-1}\frac{\Sigma^{c}(W-\Sigma)^{q-c}}{W^{q}}

这个式子有些出乎意料,它仅仅需要所有wiw_{i}的和,而并不需要每个 wiw_{i} 的特定的值。

令 w‾=∑i=1WwiW\bar{w}=\frac{\sum_{i=1}^{W}{w_{i}}}{W}

上式还可化简为 Cq−1c−1Σc(W−Σ)q−cWq=Cq−1c−1w‾c(1−w‾)q−cC_{q-1}^{c-1}\frac{\Sigma^{c}(W-\Sigma)^{q-c}}{W^{q}} = C_{q-1}^{c-1}\bar{w}^{c}(1-\bar{w})^{q-c}

这个形式正是负二项分布的结构。负二项分布中,每次试验成功的概率都是同一个值。但是在本文的模型中,每次试验的成功概率不完全相同。有趣的是,只需要算得所有成功概率的平均值,就能算出总试验次数的概率分布。

这里有一个容易漏掉的条件:每轮都要重新抽。假设有两枚硬币,一枚出正面的概率是 10%,另一枚是 90%。抽的时候,两枚被抽中的机会一样。

如果每扔一次就把硬币放回去,下次重新抽,那每次出正面的概率都是 50%,两次互不影响。连出两次正面的概率就是 50% × 50% = 25%。

如果只抽一次,拿同一枚硬币扔两次,连出两次正面的概率就是(10% × 10% + 90% × 90%)÷ 2 = 41%。为什么高了这么多?第一次出了正面,你就更有理由怀疑自己抽到的是那枚容易出正面的硬币。第二次用的还是它。
知乎原文

逆卷积(Deconvolution)为什么又叫做转置卷积(Transposed Convolution)?

在深度学习中,普通卷积常用来缩小特征图,转置卷积常用来放大特征图。拿下面的例子来说,3×3 变成 2×2,再变回 3×3,变回来的是尺寸,不是原来的 9 个像素值。逆卷积是什么?为什么逆卷积(Deconvolution)又叫做转置卷积(Transposed Convolution)?

先看普通卷积,假设一张图片只有9个像素:

x=[x1x2x3x4x5x6x7x8x9]x=\begin{bmatrix} x_{1} & x_{2} &x_{3} \\ x_{4} & x_{5} &x_{6} \\x_{7} & x_{8} &x_{9} \end{bmatrix}

如果经过kernel=2, stride=1, padding='valid'的普通卷积,那么经过卷积后的图片的分辨率是2*2。

注:记特征图的输入分辨率大小为 in*inin*in ,卷积核大小为 f*ff*f ,步长是 ss ,padding的像素是 pp ,
则经过普通卷积后输出分辨率大小的计算公式为:
out=in−f+2ps+1out=\frac{in-f+2p}{s}+1 (公式1)
式(1)里的分数要向下取整。两个式子都按卷积核不隔格取值来算;转置卷积不额外调整输出大小时,用下面的式(2)。
(in−1)s+f−2p(in-1) s + f- 2p (公式2)

假设普通卷积的卷积核为

w=[w1w2w3w4]w=\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix}

经过卷积后的输出 yy 为

y=[y1y2y3y4]y = \begin{bmatrix} y_{1} & y_{2} \\ y_{3} & y_{4} \end{bmatrix}

它是 [x1x2x3x4x5x6x7x8x9]\begin{bmatrix} x_{1} & x_{2} &x_{3} \\ x_{4} & x_{5} &x_{6} \\x_{7} & x_{8} &x_{9} \end{bmatrix} 经过 [w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix} 卷积得到的结果。

容易知道

y1=w1x1+w2x2+w3x4+w4x5y_{1}=w_{1}x_{1}+w_{2}x_{2}+w_{3}x_{4}+w_{4}x_{5}

y2=w1x2+w2x3+w3x5+w4x6y_{2}=w_{1}x_{2}+w_{2}x_{3}+w_{3}x_{5}+w_{4}x_{6}

y3=w1x4+w2x5+w3x7+w4x8y_{3}=w_{1}x_{4}+w_{2}x_{5}+w_{3}x_{7}+w_{4}x_{8}

y4=w1x5+w2x6+w3x8+w4x9y_{4}=w_{1}x_{5}+w_{2}x_{6}+w_{3}x_{8}+w_{4}x_{9}

可以用矩阵等价表示:

[y1y2y3y4]=[w1w20w3w400000w1w20w3w4000000w1w20w3w400000w1w20w3w4]⋅[x1x2x3x4x5x6x7x8x9]\begin{bmatrix} y_{1} \\ y_{2} \\ y_{3} \\y_{4} \end{bmatrix} = \begin{bmatrix} w_{1} & w_{2} &0 &w_{3} &w_{4} &0&0&0&0\\ 0&w_{1} & w_{2} &0&w_{3}&w_{4}&0&0&0 \\0 &0&0& w_{1} &w_{2} &0& w_{3} &w_{4} &0\\0 &0&0&0& w_{1} &w_{2} &0& w_{3} &w_{4} \end{bmatrix}\cdot \begin{bmatrix} x_{1} \\ x_{2} \\ x_{3} \\x_{4}\\x_{5} \\ x_{6} \\ x_{7} \\x_{8}\\x_{9} \end{bmatrix}

记权重矩阵 w̃=[w1w20w3w400000w1w20w3w4000000w1w20w3w400000w1w20w3w4]\tilde{w}=\begin{bmatrix} w_{1} & w_{2} &0 &w_{3} &w_{4} &0&0&0&0\\ 0&w_{1} & w_{2} &0&w_{3}&w_{4}&0&0&0 \\0 &0&0& w_{1} &w_{2} &0& w_{3} &w_{4} &0\\0 &0&0&0& w_{1} &w_{2} &0& w_{3} &w_{4} \end{bmatrix}

它的形状是4*9。

接下来看转置卷积。假设一张图片只有4个像素:

x=[x1x2x3x4]x = \begin{bmatrix} x_{1} & x_{2} \\ x_{3} & x_{4} \end{bmatrix}

经过kernel=2, stride=1, padding='valid'的转置卷积

卷积核 ww 是

[w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix}

根据公式2, yy 的形状是(3,3)即

y=[y1y2y3y4y5y6y7y8y9]y=\begin{bmatrix} y_{1} & y_{2} &y_{3} \\ y_{4} & y_{5} &y_{6} \\y_{7} & y_{8} &y_{9} \end{bmatrix}

那么 yy 是根据下面的矩阵得到的:

[y1y2y3y4y5y6y7y8y9]=[w1000w2w1000w200w30w10w4w3w2w10w40w200w3000w4w3000w4]⋅[x1x2x3x4]\begin{bmatrix} y_{1} \\ y_{2} \\ y_{3} \\y_{4}\\y_{5} \\ y_{6} \\ y_{7} \\y_{8}\\y_{9} \end{bmatrix} = \begin{bmatrix} w_{1} &0&0&0\\ w_{2} & w_{1} &0&0 \\0 &w_{2} &0 &0\\ w_{3} &0&w_{1} &0 \\ w_{4} & w_{3} &w_{2} &w_{1} \\ 0&w_{4} &0& w_{2} \\ 0&0&w_{3} &0 \\ 0&0&w_{4} &w_{3} \\ 0 &0&0 &w_{4} \end{bmatrix} \cdot \begin{bmatrix} x_{1} \\ x_{2} \\ x_{3} \\x_{4} \end{bmatrix} (公式3)

仔细看这里的权重矩阵,它的形状是(9,4),刚好是普通卷积的权重矩阵的转置。这正是转置的意义。


转置卷积还有一种直观的理解:

对于原图的输入 x=[x1x2x3x4]x = \begin{bmatrix} x_{1} & x_{2} \\ x_{3} & x_{4} \end{bmatrix}

首先对输入进行“full padding”(卷积的padding有三种形式,分别的"same""valid""full",详见最刚烈:卷积的三种模式full, same, valid以及padding的same, valid)

padding后的结果是

[00000x1x200x3x400000]\begin{bmatrix} 0 &0&0&0\\ 0 & x_{1} &x_{2}&0 \\0 &x_{3} &x_{4} &0\\ 0&0&0 &0 \end{bmatrix}

然后再经过 [w4w3w2w1]\begin{bmatrix} w_{4} & w_{3} \\ w_{2} & w_{1} \end{bmatrix} 的普通卷积,得到

y=[y1y2y3y4y5y6y7y8y9]y=\begin{bmatrix} y_{1} & y_{2} &y_{3} \\ y_{4} & y_{5} &y_{6} \\y_{7} & y_{8} &y_{9} \end{bmatrix}

这个结果和公式3的结果是一样的。

注意这里的卷积核是 [w4w3w2w1]\begin{bmatrix} w_{4} & w_{3} \\ w_{2} & w_{1} \end{bmatrix} ,是把 [w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix} 旋转 180° 得到的。前面那个 4×9 的大矩阵变成 9×4,才是转置。

知乎原文

分期付款的真实利率真的低吗?

网络购物结算时,或者在APP贷款时,经常会看到“分期付款”或者“分期还款”的字样。比如买一台12000的手机,网购平台会贴心地给你列出“分12期付款,每期付款1000+80元”的选择。

咋一看,每个月交80元利息,12个月交 80×12=96080\times12=960 元利息,年利率为 96012000=8%\frac{960}{12000}=8\% 。感觉这利息貌似不算高。(有时候商家还会换个说法,把“利息"称为“手续费”)

用内部收益率(IRR)来算,这笔分期按复利折算,年化利率竟然约为 15.45%。这个公式怎么来的、为什么套这个公式,网上已有很多解答。我想从另一个角度分享一下我的看法。

可以把一般的贷款理解为享受一项“获得12000元并享有这12000元一整年”的服务,服务结束后需要付款12000+960元。但在分期付款中,事实上客户没有享受到“一整年享有12000元”的服务,客户只在第一个月享受到“拥有12000元”的服务,第一个月后,需要归还1000元。归还1000元后,第二个月客户只能享受“拥有11000元”的服务。以此类推,到最后一个月,只能享受到“拥有1000元”的服务。等于说,客户享受的服务每个月在打折扣,但付给商家的钱不打折扣。

换个角度理解:小马借了银行12000元,约定一年后连本带息归还12000+960元。小明借了银行12000元,约定每个月还1000+80元,咋一看,小明一年加起来也是得还12000+960元,和小马一样。但是一般人可能很难注意到:小明每个月的本金在减少。小马可以这样做:每个月抽1000元拿去其他银行存款,这样小马就和小明一样每个月减少1000本金。但和小明不同的是,小马每个月还能获得利息,而小明却不能。

再考虑一下通货膨胀。如果通货膨胀率为0.05,那么现在的1000元相当于一年后的约1050元。所以现在还1000元,不如一年后还1000元划算。

站在商家的角度理解:商家第一个月从客户那要回1000元,可以把这1000元拿去再去贷款、投资,做一系列钱生钱的事,然后第二个月又从客户那里要回1000元,又可以把这1000元做钱生钱的事。商家把收回的钱再借出去,能赚多少是另一笔账。就这笔分期来说,你付的还是那 960 元。可你已经一个月一个月在还本金了,为什么算利率时,还拿最开始的 12,000 元当作你借了一整年?

知乎原文

如何通过混合样本的方法在10天内完成1000万份核酸检测?

5月11日,武汉打算在10天内对全市1000万人进行核酸检测。为了提升检测效率,武汉部分区域采用混合样本的方法进行检测。新闻来源:

武汉“10天大会战”:为何要将5到10人样本打包进行核酸检测?_腾讯新闻

接下来对这个问题进行抽象:某地需要对 nn 个人进行检测,病毒的携带率为 pp 。为了减少工作量,一次性将 kk 个人的样本混合,如果混合样本为阴性,这组就不用再单独测了。如果混合样本为阳性,说明这 kk 个人中至少有1个人的样本是阳性,那么接下来对这 kk 个人的样本分别做检测。这样的方法能够提高检测效率吗?

先假设每个人是否感染互不影响,检测也没有误差。只需求每个人的检测次数 XX 的数学期望 E(X)E(X) 。 如果E(X)E(X) 小于1,说明平均每个人做的检测次数小于1,即混合样本检测的方法能够提高效率。

XX 的取值只有两种可能: 1k\frac{1}{k} 和 1+1k1+\frac{1}{k},具体的分布律是:

P(X=1k)=(1−p)kP(X=\frac{1}{k})=(1-p)^{k}

P(X=1+1k)=1−(1−p)kP(X=1+\frac{1}{k})=1-(1-p)^{k}

可以求得 XX 的数学期望E(X)E(X)

=1k(1−p)k+(1+1k)[1−(1−p)k]=\frac{1}{k}(1-p)^{k}+(1+\frac{1}{k})[1-(1-p)^{k}]

=1−(1−p)k+1k=1-(1-p)^{k}+\frac{1}{k}

下面假设感染率是 1%,看看多少人一组最省。

于是E(X)=1−0.99k+1kE(X)=1-0.99^{k}+\frac{1}{k} ,显然E(X)E(X) 越小越好。要让E(X)E(X) 达到最小值,只需要让 1−0.99k+1k1-0.99^{k}+\frac{1}{k} 最小,这是一个简单的求极值问题。求得 k=11k=11 时, E(X)E(X) 取最小值,为0.196,也就是说平均个人只需要检测0.196次,少做了大约八成的检测。武汉市部分区域正是一次性将10个人的样本混合在一起检测。


这个问题可以进一步扩展:如果 kk 个人的混合样本呈阳性,上文的策略是对这 kk 个人的样本分别单独进行检测,那么能不能再进行次一级的混合样本检测,比如在这 kk 个人的样本中,每 mm 个人的样本一起检测?甚至如果某 mm 个人的混合样本呈阳性,再进行第3层级的混合样本检测……这个问题有最优策略吗?(假设每个人的样本足够多,且检测试剂足够灵敏)

知乎原文

一道关于预测是否下雨的概率题

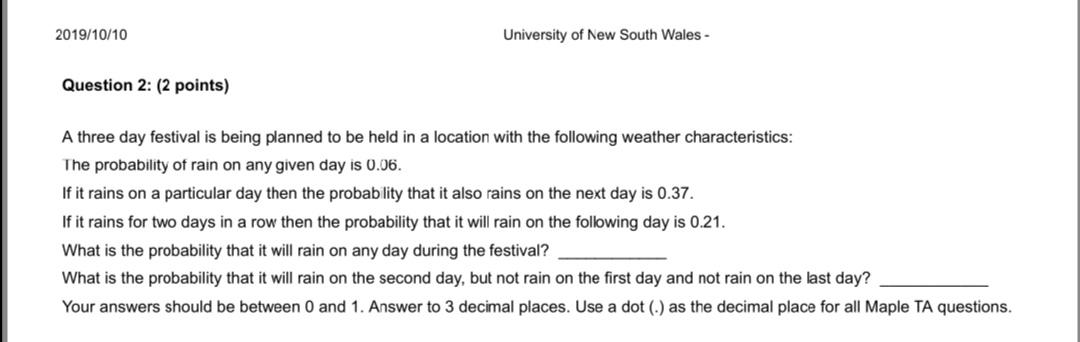
朋友给我看了一道题,我觉得挺有意思,拿来分享:任意一天,下雨的概率都是 0.06;任意相邻两天,如果前一天下雨,后一天也下雨的概率是 0.37;在连续两天下雨的条件下,第三天下雨的概率是0.21。接下来有一个为期三天的比赛,求比赛中,第二天下雨、其余两天没下雨的概率。

原文配图

最近在自学NLP(自然语言处理),这道题和NLP也能搭上关系。比如,某词是动词的条件下,下一个词是名词的概率是多少?

这道题暂时我没有找到官方答案。下面是我的解答。

注: 2R2R 表示第二天下雨(rain), 3N3N 表示第三天不下雨,以此类推。

整理题意:

P(R)=0.06P(R)=0.06

P(2R|1R)=0.37P(2R|1R)=0.37

P(3R|1R,2R)=0.21P(3R|1R,2R)=0.21

我先看“第二天下雨、第三天不下雨”,这块能直接算。第一天呢?要么也下雨,要么没下。第一天也下雨的那一块,题目正好给了条件可以算;把它扣掉,就剩下我们要的。按我原来的思路,先算在这个范围里第一天也下雨的概率:P(1R|2R,3N)P(1R|2R,3N)

=P(1R,2R|3N)P(2R|3N)=\frac{P(1R,2R|3N)}{P(2R|3N)}

=P(3N|1R,2R)P(1R,2R)P(3N)P(2R|3N)=\frac{P(3N|1R,2R)P(1R,2R)}{P(3N)P(2R|3N)}

=P(3N|1R,2R)P(1R)P(2R|1R)P(2R)P(3N|2R)=\frac{P(3N|1R,2R)P(1R)P(2R|1R)}{P(2R)P(3N|2R)}

=0.79×0.06×0.370.06×0.63≈0.464=\frac{0.79\times0.06\times0.37}{0.06\times0.63}\approx0.464

所以 P(1N|2R,3N)≈0.536P(1N|2R,3N)\approx0.536

则 P(1N,2R,3N)P(1N,2R,3N)

=P(1N|2R,3N)P(2R,3N)=P(1N|2R,3N)P(2R,3N)

=0.536×0.06×0.63≈0.0203=0.536\times0.06\times0.63\approx0.0203


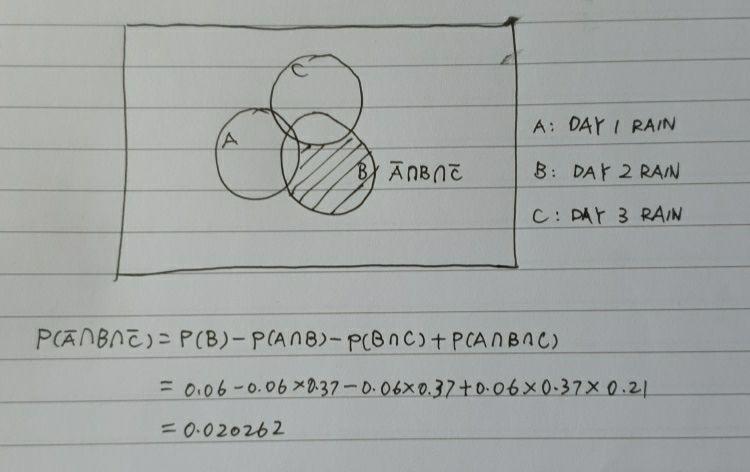
10月14日更新:朋友的老师给出了一个绝妙的解法

原文配图

我想到一个扩展:本文已解决了“NRN”出现的概率,那么是否对于以“N”“R”组成的任意长度的序列,其对应的概率皆可求出呢?光靠题里的三个数,还真算不出任意一种天气顺序。比如“第一天、第三天下雨,中间没下”,就缺了一个条件。题图第一问如果是问“三天里至少有一天下雨”,也卡在这里。

知乎原文

5个人分成3堆,堆的人数分别为2/2/1,一共有多少种不同的分法?

回答题目之前,先考虑一个更简单的问题:5个人分成2堆,要求分别为2人和3人,有多少种不同的分法?

思路:这道题等价于从5个人拿2个人出来,有多少种不同的拿法?

因为拿了2个人出来后,剩下三个人也就唯一确定了。所以答案是 C52=5!2!3!=10C_{5}^{2}=\frac{5!}{2!3!}=10

那么5个人分成3堆,要求分别为2人、2人、1人,有多少种不同的分法?

还是顺着上题的思路:先从5个人抽2个人出来,再从剩下3个人抽2个人出来。答案是 C52C32=5!2!3!3!2!=5!2!2!1!=30C_{5}^{2}C_{3}^{2}=\frac{5!}{2!3!}\frac{3!}{2!}=\frac{5!}{2!2!1!}=30 。

一般地, nn 个人分成 kk 堆,其中第 ii 堆有 nin_{i} 个人, i=1,2,……ki=1,2,……k ,那么一共有 n!n1!n2!……nk!\frac{n!}{n_{1}!n_{2}!……n_{k}!} 种不同的分法。这也叫做多项式公式。

仅仅掌握上面的公式还不够。同一个堆内的元素,是有序排序还是无序排列?不同的堆之间,是有序排序还是无序排列?这都是需要弄清楚的细节。

可以举一个极端情况:nn 个人分成了1堆,根据多项式公式,一共有 n!n!=1\frac{n!}{n!}=1 种分法。因此我猜测:堆内元素是无序的。

再举一个极端情况: nn 个人分成了 nn 堆,根据多项式公式,一共有 n!n! 种不同的分法。因此我猜测:堆之间是有序的。

再举一个特殊情况:5个人分成2堆,根据多项式公式,一共有10种分法。列举出来:

12 345 (*)

13 245

14 235

15 234

23 145

24 135

25 134

34 125 (**)

35 124

45 123

神奇的事情出现了:以上结果表明,堆内的确是无序的,但是堆之间也是无序的!因为如果堆之间是有序的,那么应该有20种分法。(比如,12 345和345 12应该是两种不同的分法)

那么根据多项式公式计算的结果,堆之间到底是无序还是有序?

再举一个例子:5个人分成3堆,根据多项式公式,一共有30种分法。这是可以列举出来的,我就不一一列举了。列举方法可以基于上个情况(5个人分成2堆),再进行细分。我仅以第一行(*)和第七行(**)为例:

第一行(*)再进行细分:

12 34 5、12 3 45、12 35 4

第七行(**)再进行细分:

34 12 5、34 1 25、34 15 2

也就是说,上个情况(5个人分成2堆)中,每一行再乘以3就得到了30这个结果。

接下来考虑:堆之间到底是无序还是有序的?在这里,12 34 5和34 12 5是两种不同的分法,但是12 34 5和5 12 34是同一种分法。为什么会这样?因为12这个堆个34这个堆的元素都是2,元素个数一样。而5这个堆元素只有1,和另外两个堆的元素个数不一样。

到这里,可以得出结论了:多项式公式中,堆内的元素一定是无序的。而对于堆与堆来说,如果在若干个堆之间,这些堆的堆内元素个数相同,那么这些堆之间有序,否则无序。

知乎原文

关于阿里算法岗2014年的一道笔试题

我最近在准备秋招,备考的时候碰到一道阿里2014年的笔试题。希望和大家一起探讨。

原文配图

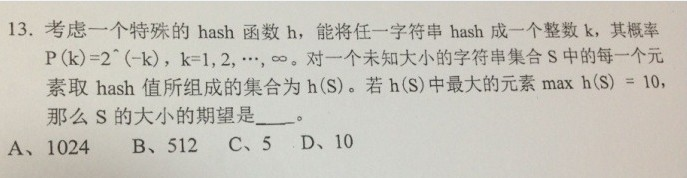
官方给的答案是A。

假设不同字符串的哈希结果互不影响,这道题就可以换成一个抽球问题:箱子有一堆球,每个球上会显示一个数字,显示数字k的概率是2^(-k)。已知箱子里的球的最大的数字是10。那么箱子里的球的数量的数学期望是多少?

我认为这道题有问题。最大值是 10,可以拿来估球数;但题目问的是球数的期望。要算这个期望,光知道最大值是 10,条件不够。就好比我从学校抽了50个学生作为样本出来,我知道了这50个学生的分数,就能够求出这50个学生的平均分。但是无论如何都求不出整个学校所有学生分数的平均分或数学期望。我顶多可以“估计”出全校学生的平均分,矩估计、最大似然估计、贝叶斯估计,这些方法都可以。


对于这道题,我有两种方法估计出球的数量。

方法一:最大似然估计。首先算出在箱子里有 nn 个球的条件下,最大数字是10的概率 PP 。然后算 nn 等于多少的时候,这个概率 PP 最高。

记 XX 为箱子里的球的数量

maxmax 为箱子里的球的最大的数字

P(max=10|X=n)P(max =10|X=n)

=P(max≤10)−P(max≤9)=P(max \leq 10)-P(max \leq 9)

=P(所有球的数字≤10)−P(所有球的数字≤9)=P(所有球的数字 \leq 10)-P(所有球的数字 \leq 9)

=(1−(12)10)n−(1−(12)9)n=(1-(\frac{1}{2})^{10})^{n}-(1-(\frac{1}{2})^{9})^{n}

=1023n−1022n1024n=\frac{1023^n-1022^n}{1024^n} (*)

注: P(一个球的数字≤10)P(一个球的数字 \leq 10) =∑k=110(12k)=1−(12)10=\sum_{k=1}^{10}{(\frac{1}{2}^{k})}=1-(\frac{1}{2})^{10}

那么 P(所有球的数字≤10)P(所有球的数字 \leq 10) 自然是 (1−(12)10)n(1-(\frac{1}{2})^{10})^{n}

对(*)式求导,可得 nn 等于709的时候,概率 P(max=10|X=n)P(max =10|X=n) 最大。709和标准答案1024有很大的差距。


方法二:贝叶斯估计(后验期望估计)。

第一步:根据贝叶斯公式,

P(X=n|max=10)P(X=n|max=10)

=P(max=10|X=n)P(X=n)P(max=10)=\frac{P(max = 10|X=n)P(X=n)} {P(max = 10)}

由(*)式

=(1023n−1022n1024n)P(X=n)P(max=10)=\frac{(\frac{1023^n-1022^n}{1024^n})P(X=n)} {P(max = 10)}

第二步:根据全概率公式,

P(max=10)P(max = 10)

=∑k=1∞P(max=10|X=k)P(X=k)=\sum_{k=1}^{\infty}{P(max = 10|X=k)P(X=k)}

=∑k=1∞(1023k−1022k1024k)P(X=k)=\sum_{k=1}^{\infty}{(\frac{1023^k-1022^k}{1024^k})P(X=k)}

结合第一步和第二步,得 P(X=n|max=10)P(X=n|max=10)

=(1023n−1022n1024n)P(X=n)∑k=1∞(1023k−1022k1024k)P(X=k)=\frac{(\frac{1023^n-1022^n}{1024^n})P(X=n)} {\sum_{k=1}^{\infty}{(\frac{1023^k-1022^k}{1024^k})P(X=k)}} (**)

第三步:根据条件数学期望公式,

E(X|max=10)E(X|max = 10)

=∑t=1∞tP(X=t|max=10)=\sum_{t=1}^{\infty}{t}P(X=t|max =10)

由(**)式

=∑t=1∞t(1023t−1022t1024t)P(X=t)∑k=1∞(1023k−1022k1024k)P(X=k)=\sum_{t=1}^{\infty}{t}\frac{(\frac{1023^t-1022^t}{1024^t})P(X=t)} {\sum_{k=1}^{\infty}{(\frac{1023^k-1022^k}{1024^k})P(X=k)}}

=∑k=1∞k(1023k−1022k1024k)P(X=k)∑k=1∞(1023k−1022k1024k)P(X=k)=\frac{\sum_{k=1}^{\infty}{k}(\frac{1023^k-1022^k}{1024^k})P(X=k)} {\sum_{k=1}^{\infty}{(\frac{1023^k-1022^k}{1024^k})P(X=k)}}

最后问题的关键在于 P(X=k)P(X=k) 是多少,也就是说在什么信息都不知道的情况下,箱子里有 kk 个球的概率(也称先验概率)是多少。事实上这个概率“求”不出来的,需要凭主观“给”出来。这也正是贝叶斯估计的迷人之处。那我应该如何选取先验分布呢?如果箱子里的球是有限的,那么根据最大熵原理的思想,我可以采用离散均匀分布作为先验分布。但是按照题意,箱子里的球应该是无限的。不巧的是,没有定义在无限区间上的离散均匀分布。不过如果我一定要令对任何 kk ,P(X=k)P(X=k) 都相等,那么上面的数学期望算得是1500左右,也是和标准答案有很大的不同。

1024 可以是一种估法,可原题没问“你会怎么估”,它问的是“期望是多少”。按原题给的条件,四个选项里没有一个能推出。


评论区有朋友指出这道题是HyperLogLog算法的一个变体。我大概查了下HyperLogLog算法,这的确是一个非常巧妙的算法。HyperLogLog算法就是想要以比较小的方差来估计S大小。

知乎原文

平均要摸多少次,才能摸完一副扑克牌中的所有黑桃牌?

上篇文章的最后向大家抛了一道思考题:

一副打乱了的标准扑克牌(无大小王,共52张),我一张一张不放回地摸出来,平均要摸多少次,才能摸出全部黑桃?

文章链接:

成功蹭WiFi的概率

在上篇文章,我同时提到了这样的问题:一副打乱了的标准扑克牌,平均要摸3.786次,才能摸出一张黑桃牌。这个3.786是怎么来的?我在上篇文章提到了方法。如果你懒得去看那篇文章的话,我在这里以更简单的方式解答:

如果第 ii 张非黑桃牌在所有黑桃牌之前,那么记 Xi=1X_{i}=1 ;否则记为0。由于一共有39张非黑桃牌,因此 ii 的取值是从1到39。

比如第一张黑桃前面有 3 张牌,那就得摸 4 次。也就是说,把排在前面的非黑桃数出来,再加上黑桃自己这 1 张。取平均,就得到 E(X)=1+∑i=139E(Xi)E(X)=1+\sum_{i=1}^{39}{E(X_{i})}

而 E(Xi)=P(Xi=1)=113+1E(X_{i})=P(X_{i}=1)=\frac{1}{13+1}

(注意第 ii 张非黑桃牌与所有黑桃牌加起来一共有14张牌,因此第 ii 张非黑桃牌在所有黑桃牌之前的概率就是 114\frac{1}{14} )

可以得出 E(X)=1+3913+1=5314≈3.786E(X)=1+\frac{39}{13+1}=\frac{53}{14}\approx3.786


接下来回到开始的题目:平均要摸多少次,才能摸完所有的黑桃牌?

介绍两种非常巧妙的方法:

方法一:把 13 张黑桃当成 13 块隔板:第一张前面、相邻两张之间、最后一张后面,一共隔出了 14 个空档。交换任意两个空档里的非黑桃张数,还是一种同样可能的排法,所以每个空档平均都有 39/14 张。每走过一个空档,再摸一张黑桃,平均要摸 5314\frac{53}{14} 次。摸完 13 张黑桃,就是走过前 13 个空档,再加上 13 张黑桃本身,所以平均要摸 13×531413\times\frac{53}{14} 次。

方法二:图上的 X 是从右边倒着摸到第一张黑桃的次数,Y 是从左边正着摸到最后一张黑桃的次数。

正着摸到的最后一张黑桃,倒过来就是第一张。从两头数到这张牌,整副牌都数到了,这张黑桃还数了两遍,所以加起来就是 53。洗好的牌倒过来一样是随机的,所以倒着摸到第一张黑桃,平均也是 53/14 次。

两边取期望,有 E(X)+E(Y)=53E(X)+E(Y)=53

得出 E(Y)=53−5314=68914≈49.21E(Y)=53-\frac{53}{14}=\frac{689}{14}\approx49.21 次。

原文配图

知乎原文

成功蹭WiFi的概率

前些天我住进一家酒店,连接这家酒店房间的WiFi时会蹦出一个网页,要求填自己的姓氏。如果填的姓氏和开房时身份证上的姓氏一致,那么就能连上WiFi。这让我想到一道概率题:如果不限制尝试次数,只知道各个姓氏有多常见,平均要试几次才能猜中?

首先可以考虑一个简单的情况:假设只有四种姓氏“赵钱孙李”:分别占比0.4、0.3、0.2、0.1。那么我平均要试几次才能成功连上WiFi?

首先自然是先尝试填占比最大的“赵”。有 0.40.4 的概率一次尝试就能成功,这种情况下,房间主人姓赵。假如第一次没成功的话,那么尝试填钱,我有 0.6×0.50.6\times0.5 的概率在第二次成功,这种情况下,房间主人姓钱。以此类推……最终算得我平均只用试2次就能成功。

上面的方法有些复杂,下面还有一个更直观的方法:因为我的策略是按照“赵钱孙李”的顺序尝试。如果主人姓赵,那么我一次就能成功;如果主人姓钱,我两次才能成功……这样下来,数学期望是 0.4×1+0.3×2+0.2×3+0.1×4=20.4\times1+0.3\times2+0.2\times3+0.1\times4=2

在现实中,姓氏种类繁多,分布复杂,因此对此进行建模需要拿到准确的数据。


顺着这个问题,我想了一道新的题目:

你正在参加一个娱乐节目。箱子里1个绿球,2个红球,3个黄球,4个蓝球。主持人随机取一个球出来再放回去,与该球同颜色的球成为了幸运球。接下来你每次从箱子里取一个球出来不放回。你平均要取多少次才能取到幸运球?

这个问题比刚刚的问题复杂得多。解决这个问题之前,我们先看如下题目(引题):

nn 男 mm 女随意排列成一排, XX 为第一个男人所在的位置,求 E(X)E(X) 。

解:如果第 ii 个女人在所有男人之前,那么记 Xi=1X_{i}=1 ;否则记为0。

如果第一个男人前面有两个女人,那他就排第三。也就是说,他的位置是前面的人数再加 1。先写出位置,再两边取期望:X=1+∑i=1mXiE(X)=1+∑i=1mE(Xi)\begin{aligned} X &= 1+\sum_{i=1}^{m}X_i \\ E(X) &= 1+\sum_{i=1}^{m}E(X_i) \end{aligned}

接下来只看第 i 个女人和那 n 个男人。这 n+1 个人谁排最前面的机会都一样。她要排在所有男人前面,就得在这 n+1 个人里排第一,所以 E(Xi)=P(Xi=1)=1n+1E(X_{i})=P(X_{i}=1)=\frac{1}{n+1}

可以得出 E(X)=1+mn+1E(X)=1+\frac{m}{n+1}

回到开始的题目。排队题里的男人,就是我们要找的那种颜色的球;女人就是其他颜色的球。第一个男人排第几,就相当于第几次摸到幸运球。如果幸运球是绿球,我平均要取多少次才能取到绿球呢?这相当于引题中1男9女的情况,数学期望是 1+91+1=1121+\frac{9}{1+1}=\frac{11}{2} ;如果幸运球是红球,我平均要取多少次才能取到红球呢?这相当于引题中2男8女的情况,数学期望是 1+82+1=1131+\frac{8}{2+1}=\frac{11}{3} ……

最后,把四种颜色各自要摸的平均次数,按主持人抽到这种颜色的概率加权平均: 110⋅112+210⋅113+310⋅114+410⋅115≈3\frac{1}{10}\cdot\frac{11}{2}+\frac{2}{10}\cdot\frac{11}{3}+\frac{3}{10}\cdot\frac{11}{4}+\frac{4}{10}\cdot\frac{11}{5}\approx3


可以做很多有趣的扩展。之前我提到过几何分布的数学期望。比如平均要抛六次骰子,才会出现一次“1”点向上。一个类似的问题是:在一副扑克牌中,我平均要随机抽几张出来,才能抽出一张黑桃?

有人可能会顺着几何分布的思路,认为既然黑桃在牌堆中的占比是 14\frac{1}{4} ,那么平均我摸4次才能出现一次黑桃。但是这里摸牌是不放回的,每次摸牌的概率是不独立的。因此需要用到引题中的思路。这里等价于引题中13男39女的情况,算得平均要摸3.786次才能摸到一张黑桃牌。这个结果比4小,也符合直观,因为我一旦摸到了不是黑桃的牌,那么剩下牌堆中黑桃的比例就增大了。

抛给读者一个思考题:一副打乱了的标准扑克牌(无大小王,共52张),我一张一张地摸一张出来,期望要摸多少次,才能摸出全部黑桃?解法写在这篇文章里,可以先自己想一想。

我在《大白话概率论》的「扑克牌中的黑桃」一节里,把摸到第一张和摸完最后一张这两问放在一起讲了。

知乎原文

一道概率题:脱发的程序员

闲来无事,自编了一道题目:

小明是一个程序员,他每天早上起来都会看看自己有没有掉头发。如果没有掉头发,则会按一下台灯的开关。已知月初灯是关的,每天脱发的概率独立且相等,且每天脱发的概率比不脱发的概率高。到月底时,灯更有可能是开着还是关着?

这个问题还能改为:

高中生小坤每天都会投一次篮,若投中,则在小本本上加一分。已知他的球技不怎么样,且永远原地踏步。那么一段时间后,累计分数更有可能是奇数还是偶数?


这道题可以抽象成这样的模型:一共做 n 次相互独立的试验,每次成功的概率都是 pp。在小明这道题里,“成功”就是那天没掉头发、按了一次开关。我们先算成功次数是奇数的概率。

这个概率记为 aa ,不难知道

a=Cn1p1(1−p)n−1+Cn3p3(1−p)n−3+……a=C_{n}^{1}p^{1}(1-p)^{n-1}+C_{n}^{3}p^{3}(1-p)^{n-3}+……

如何判断它是否大于0.5?我暂时没有很好的办法。于是尝试走另一条路。记成功发生偶数次的概率为 bb ,类似地有

b=Cn0p0(1−p)n+Cn2p2(1−p)n−2+……b=C_{n}^{0}p^{0}(1-p)^{n}+C_{n}^{2}p^{2}(1-p)^{n-2}+……

这貌似也不能直接判断是否大于0.5。

最关键的一步来了:

b−ab-a

=Cn0p0(1−p)n−Cn1p1(1−p)n−1+Cn2p2(1−p)n−2−Cn3p3(1−p)n−3+……=C_{n}^{0}p^{0}(1-p)^{n}-C_{n}^{1}p^{1}(1-p)^{n-1}+C_{n}^{2}p^{2}(1-p)^{n-2}-C_{n}^{3}p^{3}(1-p)^{n-3}+……

=[−p+(1−p)]n=[-p+(1-p)]^{n}

=(1−2p)n=(1-2p)^n

又因为 a+b=1a+b=1

因此 b=12[1+(1−2p)n]=12+12(1−2p)nb=\frac{1}{2}[1+(1-2p)^n]=\frac{1}{2}+\frac{1}{2}(1-2p)^n

这应该是一个很简洁的式子了。我们可以讨论出如下结果:

①若 nn 为偶数,且 p ≠ 1/2,则 b>12b>\frac{1}{2} ;

②若 nn 为奇数,且 p<12p<\frac{1}{2} ,则 b>12b>\frac{1}{2} ;

③若 nn 为奇数,且 p>12p>\frac{1}{2} ,则 b<12b<\frac{1}{2} ;

如果 p = 1/2,奇数次和偶数次的概率各是一半。

一个有趣的结果是:不论 nn 是奇数还是偶数,当 p<12p<\frac{1}{2} 时,发生偶数次的概率更高。而我在题目中提到“脱发是件容易的事”,意味着每天不脱发的概率小于 12\frac{1}{2} 。因此,小明没掉头发的天数,也就是按开关的次数,更有可能是偶数。灯一开始是关的,每按两次就回到关灯,所以不论这个月有多少天,月底都更可能是关着的。