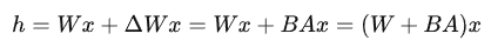武辰作品索引

知乎作品库

文章 · 3

知乎原文

深入理解语言模型的困惑度(perplexity)

网络上很多关于介绍困惑度的文章,大多数是从信息熵、交叉熵的角度去讲解困惑度。这个角度直击了困惑度的本质。但是对于新人来说,这可能是舍本逐末的学习思路,会让人越看越困惑。我的建议是从源码入手,在实践中可能会获得更深入的理解。

我结合源码,做了一些实验,在探索的过程中对困惑度逐渐有一些自己的理解。我把我的探索过程分享出来,希望对大家有帮助。

参考资料

huggingface官方:

https://huggingface.co/docs/transformers/perplexity

https://thegradient.pub/understanding-evaluation-metrics-for-language-models/

关于openCompass与大模型评测现状的分析 - 邱震宇的文章 - 知乎

https://zhuanlan.zhihu.com/p/652688939

LLM评估指标困惑度的理解 - zmfy的文章 - 知乎

https://zhuanlan.zhihu.com/p/651410752

深入浅出讲解语言模型 - 忆臻的文章 - 知乎

https://zhuanlan.zhihu.com/p/28080127

求通俗解释NLP里的perplexity是什么? - 润风的回答 - 知乎

https://www.zhihu.com/question/58482430/answer/1089866331


先从语言模型开始说起

要彻底弄明白困惑度,我认为应该从语言模型开始逐步理解。读者也可以跳过这部分的阅读,直接看困惑度的部分。


语言模型的本质

语言模型的本质是对语言序列(如句子或文档)的概率分布进行建模。简单来说,就是对给定的一段文本,语言模型能够预测下一个词是什么。这种概率建模可以根据具体的应用需求,作为许多自然语言处理任务(如语音识别、机器翻译、拼写校正等)的基础。这种模型也可以用于生成新的句子或文本,即随机选择下一个词,然后根据这个词再随机选择下一个词,以此类推,直到生成一个完整的句子或文本。

语言模型可以通过不同的方式来建立,其中最常用的是 n-gram 模型、隐马尔可夫模型和神经网络模型。不同的模型在处理长距离依赖问题、稀有词、词序等问题上有不同的优点和缺点。

(20240611补充:事实上,不止NLP领域,整个机器学习领域,都可以认为是对真实的概率分布来建模。比如CV任务的本质是对图像的分布来建模)


模型建模与马尔可夫假设

语言模型的本质是对语言序列的概率分布进行建模。具体如何建模呢?

给定一个语言序列,比如一条长度为n的句子S,这里的长度为n,指的是经过分词后长度为n,即有n个token,第一个token是W1W_1 ,以此类推。那么整个句子S可以表示为:

S=W1,W2,...WnS=W_1,W_2,...W_n

模型生成这条句子的概率是:

P(S)=P(W1,W2,...Wn)=P(W1)P(W2|W1)P(W3|W1,W2)...P(Wn|W1,W2,...Wn−1)P(S)=P(W_1,W_2,...W_n)=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_n|W_1,W_2,...W_{n-1})

这个公式很重要,将会在后面反复提及。你可以这么理解:语言模型的任务,就是要计算这个概率。为了方便后文的表述,我称这个概率为公式(1)。

在基于神经网络的语言模型出来之前,要直接计算概率 P(Wn|W1,W2,...Wn−1)P(W_n|W_1,W_2,...W_{n-1}) 是比较困难的。设想一下,如果一个句子有100个单词,即n=100,这个概率的变量有100个,计算起来会非常复杂。

为了解决参数空间过大的问题,研究人员引入了马尔科夫假设:一个词出现的概率只与它前面出现的有限的一个或者几个词有关。


1-gram

如果一个词的出现与它周围的词是独立的,那么我们就称之为unigram也就是一元语言模型:

P(S)=P(W1)*P(W2)*...*P(Wn)P(S)=P(W_1)*P(W_2)*...*P(W_n)

这个概率表达式相对于原公式,直接把所有的条件概率中的条件略去了,因为每个词和其他词都是独立的。

这个假设特别强:每个词都是互相独立的,每个词都和其他词没有关系。在这样强的假设下,模型被简化到非常简单的地步,带来的缺点也是显而易见的。考虑一篇摘自于环保文章的英语句子 “It’s not easy being ?”。在这个语境中,“?” 处很有可能的一个词是 “green”(这是一种常见的说法,意为做环保的事情并不容易)。然而,在一个大量文本的语料库中,“green”的频率可能会低于其他的一些词,比如 “good”。如果我们只用 1-gram 模型来预估,模型可能会将 “good” 作为最有可能出现在 “?” 的词,因为 “good” 出现的频率更高。但实际上在这个上下文中,“green”可能是更合适的词,这就是因为 1-gram 模型没有考虑到上下文信息导致的错误。

更进一步说,如果一个单词的含义在不同的上下文中有所不同,1-gram模型也无从体现出这种区别。例如,“bank”在“河岸(river bank)”和“银行(money bank)”这两种场景下具有完全不同的含义,但在1-gram模型中,我们无法根据上下文来决定“bank”的实际含义。

因此,尽管1-gram模型简单易用,但是在处理依赖上下文的语言理解任务中,会存在严重的局限性。

我再举一个极端点的例子:假如训练的语料只有这么一句话:“我很喜欢吃饭。饭真的好吃,饭有营养,饭是人类生存的必需”。在这个训练语料中,饭出现的次数最多。那么在预测的时候,你会发现生成的词语可能全部都是“饭”。(当然,全部词语都是“饭”的概率比较小,因为在实际应用中,通常会结合一些平滑技术和规则约束来改善这种情况。比如,我们可能会设定一个规则,不允许同一个词连续出现太多次。另外,即使在1-gram模型中,我们通常也不会直接选取出现频率最高的词,而是会根据所有词的出现频率计算出一个概率分布,然后根据这个概率分布随机选择下一个词,这样可以增加生成句子的多样性。)


2-gram

由于1-gram显而易见的缺点,在一段时间内,业内常常使用的是2-gram(也叫bigram)模型和3-gram(也叫trigram)模型。

针对

P(S)=P(W1,W2,...Wn)=P(W1)P(W2|W1)P(W3|W1,W2)...P(Wn|W1,W2,...Wn−1)P(S)=P(W_1,W_2,...W_n)=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_n|W_1,W_2,...W_{n-1})

如果一个词的出现仅依赖于它前面出现的一个词,那么我们就称之为bigram:

P(S)=P(W1)*P(W2|W1)*...*P(Wn|Wn−1)P(S)=P(W_1)*P(W_2|W_1)*...*P(W_n|W_{n-1})

举一个例子(例子来源于https://class.coursera.org/nlp/和https://zhuanlan.zhihu.com/p/28080127):

c(wi-1,wi)计数结果如下:

原文配图

如何理解这个表格?比如第一行第二列,表示在所有语料中,i后面接着want的情况(或者说,“i want”出现的情况)出现了827次;在第二行第一列,表示在所有语料中,want后面接着i的情况出现了2次。

c(wi)的计数结果如下:

原文配图


比如i在所有语料中出现了2533次。

计算P(want | i) = 0.33如下:

原文配图

注意,这里的c(i,want)的表示方法可能不太准确,在概率论的表示方法中,逗号是不区分先后的。但是这里的意思应该是要区分先后。c(i,want)并不是表示“i”和“want”同时出现的情况次数,而是“i want”出现的次数,或者“i在前且want紧随在后”出现的次数。也就是说,c(i,want)和c(want,i)不一样。

那么针对这个语料库的二元模型建立好了后,我们可以计算我们的目标,即一个句子的概率了,一个例子如下:

P(I want english food </s>) = P(I) × P(want|I) × P(english|want) × P(food|english) × P(</s>|food) = 0.000031

2-gram比1-gram模型(unigram)更科学些,比1-gram模型能更好地捕捉到词语之间的一定关联性,但仍然存在着一些明显的缺陷:

(1)仍然不能很好地捕捉长距离的词依赖。2-gram假设一个词只和它前面的一个词相关,但在实际的语言中,一个词可能和它前面更远的词相关。例如,在"The cat, which already had its dinner, is sleeping on the sofa"这个句子中,"is sleeping"和"cat"有关,但它们之间隔了好几个词。

(2)稀有组合问题。因为2-gram模型依赖于统计词对的出现频率,所以对于训练语料中未出现或者很少出现的词对,其预测的效果将很差。例如,“celebrate birthday"是一个常见的词对,但如果试图预测"celebrate achievement”,而这在训练语料中并未出现过,那么模型将无法做出正确预测。(这一点还不如1-gram,1-gram只要在词汇表内出现过,都有概率生成。但是如果一个词对没有在预料中出现过,那就不可能被生成)

此时P(Wk|Wk−1)P(W_k|W_{k-1}) 将会是0。而且经过概率的连乘,整个句子出现的概率也将变成0。这显然是不合适的。

(3)参数空间大。因为2-gram模型需要统计和存储所有可能的词对,这意味着模型需要大量的存储空间和计算资源。随着词汇量的增长,词对数量会呈平方级增长,不易于处理和存储。

(4)无法很好地处理复杂的语言现象,如语言中的歧义、含蓄表达、讽刺、隐喻等等,这些都需要对整个语境的深度理解。


对于长依赖关系,简单的n-gram是无法处理的,如果一个句子长达100,那么要去算一个100个变量的条件概率吗?这太复杂了。这也是为什么现在主流的语言模型都是基于神经网络,如RNN、Transformer等。


困惑度

困惑度的定义

得到一个语言模型后,如何判断一个语言模型的好坏呢?有一个直观的思路是:给定一个高质量的句子,好的模型生成这个句子的概率会比较高。于是有研究人员顺着这条思路提出了困惑度。

困惑度(Perplexity)是一种衡量语言模型预测样本的好坏的指标,常用于自然语言处理中。模型给原文里实际出现的 token 的概率越高,困惑度就越低。

有人可能会问,现在不是有各种榜单、测试集去测量大模型的能力吗?为什么还需要用困惑度指标?这是个好问题。大语言模型一般分为两种:base模型和chat模型。我们日常通常使用的是对话模型(比如ChatGPT),这种模型具有进行对话的能力,而基础模型更像是在接着写,未必会按指令回答。困惑度看的是模型给一段文字打了多少概率,基础模型和对话模型都能算。


困惑度的公式

困惑度的公式如下:

$perplexity(W) = P(w_1, w_2, w_3, w_4, …… , w_n)^{-\frac 1N} =\\ \sqrt[N]{\frac 1{P(w_1, w_2, w_3, w_4, …… , w_n)}} = \sqrt[N]{\prod_{i=1}^n\frac 1{P(w_i|w_1, w_2, …w_{i-1})}}$

不要被这么长的公式吓到了,其实除了(-1/N)次幂外,其余部分和公式(1)并无区别。

这里的W表示一条语料,N表示这条语料包含的token的个数。P(W1,W2,...Wn)P(W_1,W_2,...W_n)就是模型生成这个句子的概率。之所以要施加(-1/N)次幂,是因为要考虑语料长度的影响。如果一个句子越长,这个句子出现的概率可能会越低(比如“你好”和“你是我心中最美的云彩”这两句话,前者出现的概率很高)。开 N 次方,是把整段文字的概率换算成每个 token 的尺度;再取倒数,就是让模型越难猜到的文本,困惑度越高。

所以,整段文字的概率只是中间结果。困惑度是按实际计分的 token 数开方,再取倒数。

接下来通过代码来理解困惑度的计算细节。


huggingface官网关于计算困惑度的代码

官网给出了计算困惑度的代码(https://huggingface.co/docs/transformers/perplexity)。我尝试了一下,发现跑不通,可能是因为huggingface提供的GPT2模型太老了。我把模型改成了bloom模型,可以跑通。

这是我执行的代码(如果你要复现,需要将模型的路径修改成自己的路径):

from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, Trainer


device = "cuda"
model = AutoModelForCausalLM.from_pretrained("Langboat/bloom-1b4-zh", cache_dir='/home/notebook/data/group/huggingface/Bloom-models-dirs').to(device)
tokenizer = AutoTokenizer.from_pretrained("Langboat/bloom-1b4-zh", cache_dir='/home/notebook/data/group/huggingface/Bloom-models-dirs')


from datasets import load_dataset


test = load_dataset("wikitext", "wikitext-2-raw-v1", split="test")
encodings = tokenizer("\n\n".join(test["text"]), return_tensors="pt")


import torch
from tqdm import tqdm


max_length = model.config.seq_length
stride = 512
seq_len = encodings.input_ids.size(1)


total_nll = 0.0
total_tokens = 0
prev_end_loc = 0
for begin_loc in tqdm(range(0, seq_len, stride)):
    end_loc = min(begin_loc + max_length, seq_len)
    trg_len = end_loc - prev_end_loc  # may be different from stride on last loop
    print('begin_loc:'+str(begin_loc)+' end_loc:'+str(end_loc)+' trg_len:'+str(trg_len))
    #第一次是0-4096,第二次是512-4608,第三次是1024-5120,trg_len是512
    input_ids = encodings.input_ids[:, begin_loc:end_loc].to(device)
    target_ids = input_ids.clone()
    print(target_ids.shape) #torch.Size([1, 4096])
    target_ids[:, :-trg_len] = -100


    with torch.no_grad():
        outputs = model(input_ids, labels=target_ids)


    # 模型会丢掉窗口的第一个标签,再跳过标成 -100 的位置。
    n_tokens = (target_ids[:, 1:] != -100).sum().item()
    if n_tokens > 0:
        total_nll += outputs.loss.item() * n_tokens
        total_tokens += n_tokens


    prev_end_loc = end_loc
    if end_loc == seq_len:
        break


ppl = torch.exp(torch.tensor(total_nll / total_tokens, dtype=torch.float64))
print(ppl)


代码解读

模型和数据集

为了方便debug,我使用的模型是1.4b的bloom模型(是一种自回归模型,即CausalLM),参数量小,加载起来速度快一些。

使用的数据集是wikitext/wikitext-2-raw-v1,官网之所以选择这个数据集作为示例,是因为这个数据集比较小,可以一次性跑完。

注意,我们说的模型的困惑度,准确来说,应该指的是模型在某条语料上的困惑度。在这里,我们把整个wikitext-2-raw-v1数据集合并在一起(代码:"\n\n".join(test["text"])),当作一条语料。换句话说,整个数据集被合并成一个很长的“句子”。经过tokenizer之后,整个语料的token数量是394381.


把整条数据集拆开

虽然把整个数据集当作一个语料,但是这个语料的长度有394k,显然不能直接送进模型里(截止到2024年3月,应该还没有上下文窗口达到394k的大语言模型)。(20240611更新:被4月份发布的kimi大模型打脸了)

因此需要将数据集拆开,分批次送到模型里。

具体如何拆开?有不同的拆开方式。一个比较粗暴的方式是简单地把数据集做一个切分。比如模型一次性只能处理4096个token,那么把整个语料做如下切分:第1-4096个token作为第一个数据,第4097-8192个token作为第二个数据,以此类推。然后依次把每个数据送进模型里,各自计算困惑度。

这种方式比较粗暴,机械地把句子截断,可能会累积产生很多误差。因为在这种方式下,计算的实际上下文比较少。

什么意思呢?比如把第4097-8192个token作为第二个数据送进去的时候,计算困惑度,是计算:

$P(W_1, W_2, W_3, W_4, …… , W_n)\\=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_n|W_1,W_2,...W_{n-1})$

考虑第4098个token,在计算P(第4098个token|以往的context)的时候,如果按照这种机械截断的方式,这里的“以往的context”只有第4097个token,这样上下文信息太少了。

比较推荐的方式是使用滑窗的方式,也就是huggingface官网使用的逻辑。第一次把第0-4096个token送进去网络,第二次是把第512-4608个token送进去网络,以此类推……

需要注意一个细节:第一次把第0-4096个token送进去网络,这是没有问题的。第二次,做了一个长度为512的滑窗,把第512-4608个token送进去网络。请注意,第512-4096个token在第一次已经被计算过一次生成概率了,这里会再重复计算一次。为了避免被重复计算,在计算loss的时候,需要将第512-4096个token的label置为-100。具体的细节会在后文详细说明。从第二次开始,相当于每次只计算最后512(等于滑窗长度)个token的概率。


如何计算概率

上文说到,每次将4096个token送到模型里,来计算这一小段语料的生成概率。

这个概率是:

P(W1,W2,W3,W4,……,W4096)=P(W1)P(W2|W1)P(W3|W1,W2)...P(W4096|W1,W2,...W4095)P(W_1, W_2, W_3, W_4, …… , W_{4096})=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_{4096}|W_1,W_2,...W_{4095})

这个概率如何计算呢?

在传统的n-gram模型中,引入了马尔可夫假设,比如一阶马尔可夫假设(token只和前一个token有关,与其他token无关),那么有P(W4096|W1,W2,...W4095)=P(W4096|W4095)P(W_{4096}|W_1,W_2,...W_{4095})=P(W_{4096}|W_{4095})

马尔可夫假设简化了计算,但是捕捉不了长距离的关联。现在的语言模型基本上是基于transformer的结构,transformer最重要的特征是捕捉长距离的关联。因为不能做简化。


我们来看看自回归生成模型的输出是什么,这需要进入到transformes库的源码中(如何进入源码?注意到我们加载的模型是bloom模型,可以查看model.config,发现有一个字段是'architectures',对应的值是"BloomForCausalLM",于是可以进入transformers包的源码中的bloom路径调试,具体路径是:/.../conda/envs/transformers2/lib/python3.9/site-packages/transformers/models/bloom/modeling_bloom.py),在源码中可以看到有以下几行代码:

transformer_outputs = self.transformer(
    input_ids,
    past_key_values=past_key_values,
    attention_mask=attention_mask,
    head_mask=head_mask,
    inputs_embeds=inputs_embeds,
    use_cache=use_cache,
    output_attentions=output_attentions,
    output_hidden_states=output_hidden_states,
    return_dict=return_dict,
)
hidden_states = transformer_outputs[0] 
lm_logits = self.lm_head(hidden_states) 

transformer_outputs是经过了所有decoder模块后的输出,它有两部分组成,第一个部分是hidden_states,蕴含了经过transformer变换后的信息(特征),第二部分是kvcache,和本文无关。

hidden_states的shape是1*4096*2048,1是batchsize,4096是输入token的个数,2048是hidden size。

最后hidden_states经过一个线性层,得到lm_logits ,lm_logits的shape是1*4096*46145,其中46145是词汇表的大小。这个4096*46145的矩阵如何解读呢?4096代表输出句子的长度,或者说token数量。每个token有一个46145维度的向量,在哪个分量的值最高,就意味着预测输出那个分量对应的词汇表里的词汇。

我用一个更简单的例子来说明。这个例子借鉴于知乎用户@zmfy (LLM评估指标困惑度的理解 - zmfy的文章 - 知乎https://zhuanlan.zhihu.com/p/651410752)

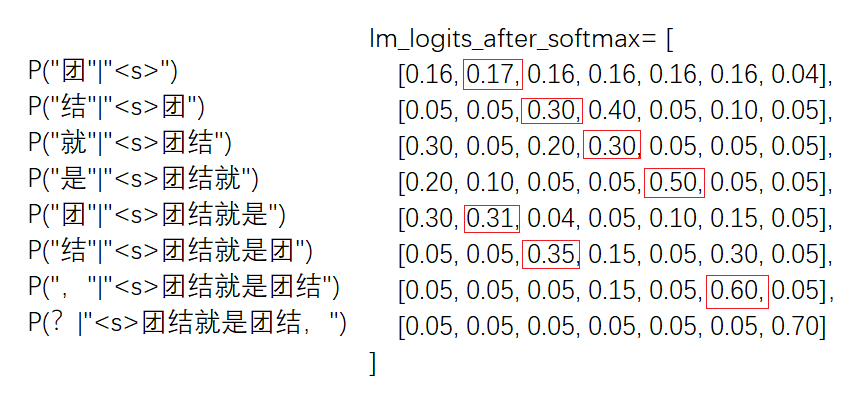
假设句子长度是8,词汇表长度是7,经过模型的decoder得到的lm_logits,如果再施加softmax后,将会是如下的概率矩阵(形状为 [句子长度, 词表长度],即8*7的矩阵):

lm_logits_after_softmax= [
    [0.16, 0.17, 0.16, 0.16, 0.16, 0.16, 0.04], 
    [0.05, 0.05, 0.30, 0.40, 0.05, 0.10, 0.05], 
    [0.30, 0.05, 0.20, 0.30, 0.05, 0.05, 0.05], 
    [0.20, 0.10, 0.05, 0.05, 0.50, 0.05, 0.05], 
    [0.30, 0.31, 0.04, 0.05, 0.10, 0.15, 0.05], 
    [0.05, 0.05, 0.35, 0.15, 0.05, 0.30, 0.05], 
    [0.05, 0.05, 0.05, 0.15, 0.05, 0.60, 0.05],
    [0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.70]
]

词汇表的对应关系如下:

tokens_map = {
    '<s>': 0,
    '团': 1,
    '结': 2,
    '就': 3,
    '是': 4,
    ',': 5,
}

给模型输入的语料是:“<s>团结就是团结,”。其中<s>是特殊的token,代表一句话的开始。

这段语料,包括逗号在内,一共有8个token。输入到模型后,得到了一个8*7的矩阵。矩阵的每个值都代表着概率值。具体含义如下:

原文配图

比如第一行的向量,代表着给定输入为<s>的条件下,模型生成各个token的概率分布。一共有7个维度,发现第1个索引(从0开始数)的值最大,回去找词汇表,发现第1个索引对应的token是“团”,于是这里的0.17代表P("团"|"<s>")。再来看第0个索引,它的值是0.16,代表P("<s>"|"<s>")。其他以此类推。

再比如,第二行最高的是「就」,概率是 0.40。但原文里「团」后面接的是「结」,所以算困惑度时,我们取的是「结」的 0.30。你看,图里框的就是这个数。

再看最后一行向量。我们知道,自回归语言模型的任务的预测下一个词。事实上,在大部分大语言模型的应用场景中,一般只关注最后一个token的预测情况,即在这个例子中,只关注最后一行,前面几行是什么没有任何意义(一般来说,只有在计算困惑度的时候才有意义)。我们可以看到最后一行中数值最大的索引是6,那么模型的意思是,在“<s>团结就是团结,”这句话后面,出现的token,最有可能是词汇表排名为6的token。当然,词汇表排名为6的token我这里没有给出,因为这不是本文的重点。


插曲:lm_logits矩阵真的表示概率吗?

这里插入我的一些思考。读者可以略过此部分,直接看后面计算困惑度的部分。

上面说到,在自回归语言模型中,模型会输出[句子长度, 词表长度]的矩阵lm_logits,如果手都施加softmax,则得到lm_logits_after_softmax。(之所以手动施加softmax,是因为在pytorch中的nn.CrossEntropyLoss()函数,是不需要施加softmax的,它会在这个计算loss的函数里面自动施加softmax。这里我们为了从根本上说明清楚困惑度,便手动施加了softmax)

一般来说,在实际的应用场景下,只有lm_logits_after_softmax中最后一个元素才有意义,即lm_logits_after_softmax[-1]才有意义,它表示的是模型认为下一个词是什么,即P(?|"<s>团结就是团结,")。

除了最后一行,前面几行表示的也是概率。事实真的如此吗?

我做两个实验看看。

下面是第一个实验的代码:

from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, Trainer
device = "cuda"
model = AutoModelForCausalLM.from_pretrained("Langboat/bloom-1b4-zh", cache_dir='/home/notebook/data/group/huggingface/Bloom-models-dirs').to(device)
tokenizer = AutoTokenizer.from_pretrained("Langboat/bloom-1b4-zh", cache_dir='/home/notebook/data/group/huggingface/Bloom-models-dirs')
text = '<s>May I know what is your name'
encodings = tokenizer(text, return_tensors="pt")
device = "cuda"
input_ids = encodings['input_ids'].to(device)
target_ids = input_ids.clone().to(device)
print(input_ids.shape)
print(target_ids.shape)
print(tokenizer.decode(input_ids[0]))
import torch
with torch.no_grad():
    outputs = model(input_ids, labels=target_ids)
a = outputs[1]
print(a.shape)
a = a.squeeze(0) # 删除第一维度,输出形状将变为torch.Size([50, 46145])
indices = torch.argmax(a, dim=1) # 在词汇表维度上找到概率最大的索引
tokenizer.decode(indices)

在这个实验中,我把'<s>May I know what is your name'送到模型里。这句话的token数一共有9个,模型的输出是torch.Size([1, 9, 46145])的矩阵。如果我把每个分量概率最大的token拿出来,发现模型的输出是', I askno what you the name?'。

这似乎有些奇怪:怎么把每一行分数最高的 token 拼起来,没得到原来的句子?

因为每一行都在回答一个不同的问题:给定前面这几个词,下一个词最可能是什么?

比如看到 May I,模型如果觉得后面最可能接 ask,这也很正常。可原文接的是 know,算困惑度就要看模型给 know 打了多少分。

(当然,一般情况下,只有最后一个token才有意义,这里最后一个token的预测结果是问号,的确是符合要求的,从这个意义来说,这个模型是正常的。因为'<s>May I know what is your name'的后面一般是接一个问号)

如果我换一个模型,会不会存在同样的情况呢?

我换成了7b的intern2-chat-7b模型。

当text = '<s>May I know what is your name'时,模型的输出是:

TheThe ask the is the favorite?

当text = '<s>May I know what is your'时,模型的输出是:

TheThe ask the is the favorite

如果从模型最后一个token的角度来看,两者的输出并无不妥。 '<s>May I know what is your name'之后,模型认为的下一个词是问号。 '<s>May I know what is your'之后,模型认为下一个词是favorite,也能说得过去。

整行拼出来的结果看着更不像原句了。真要比较两个模型谁更容易猜到原文,还是得看各自给原文每个 token 的概率。

我再换一个模型,这一次是internlm2-base-7b模型

当text = '<s>May I know what is your name'时,模型的输出是:

<< ask how is the opinion?

当text = '<s>May I know what is your'时,模型的输出是:

<< ask how is the opinion

换了模型,逐行取最高分再拼起来,照样不一定是原句。


第二个实验,我想看看,如果把input_ids截断,那么模型的输出是不是也是截断后的结果?

我把text从'<s>May I know what is your name'改为 '<s>May I know what is your',仿照上面的步骤,得到最终的输出是', I askno what you the name',发现inputs_ids经过截断后,产生的输出也是单纯的截断。这一点是比较符合直觉的。(为什么?因为transformer中自注意力的机制中,对于q1,q2,...qn序列,qk只和k之前的值有关,比如q3,只和第0/1/2个token有关,与第2个以后的token都没有关系,详情见kvcache相关的内容)

当然仅仅从经过decode后的结果来判定两者相等,过于草率。因为decode是取了概率最大值,decode后的结果相等,只能说明最大值的索引没有变,并不能说明每个概率值相等。可是实地用代码验证两者是否相等:

text = '<s>May I know what is your name'
encodings = tokenizer(text, return_tensors="pt")
device = "cuda"
input_ids = encodings['input_ids'].view(1,-1).to(device)
target_ids = input_ids.clone().to(device)
print(input_ids.shape)
print(target_ids.shape)
import torch
with torch.no_grad():
    outputs = model(input_ids, labels=target_ids)
a = outputs[1]
print(a.shape)
text = '<s>May I know what is your'
encodings = tokenizer(text, return_tensors="pt")
device = "cuda"
input_ids = encodings['input_ids'].view(1,-1).to(device)
target_ids = input_ids.clone().to(device)
print(input_ids.shape)
print(target_ids.shape)
import torch
with torch.no_grad():
    outputs = model(input_ids, labels=target_ids)
b = outputs[1]
print(b.shape)
print(torch.allclose(a[0,:8,:], b[0,:8,:], rtol=1e-03))  # 输出: True

发现两者的确是相等的。


注意,这里有一个细节,把texe从'<s>May I know what is your name'改为 '<s>May I know what is your',是否等价于单纯地截断,这一点需要验证。因为分词机制,单纯地在原始文本的后面删除词汇,并不等价于对应的input_ids中删除词汇。在本例中,经过验证,两者是等价的。


计算困惑度

上文说到,计算困惑度,本质上是计算生成一个句子的概率:

$P(W_1, W_2, W_3, W_4, …… , W_{4096})\\=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_{4096}|W_1,W_2,...W_{4095})$

然后再对这个概率施加一个(-1/N)次幂。

那么生成句子的概率如何计算呢?

仍然以“<s>团结就是团结,”这块语料为例。

原文配图

模型生成这段语料的概率是:

P(W1,W2,W3,W4,……,W7)P(W_1, W_2, W_3, W_4, …… , W_{7}) =P("团结就是团结,")

=0.17*0.30*0.30*0.50*0.31*0.35*0.60=0.000498015

注意,这里不应该包括开头的<s>符号,因为在自回归语言模型中,模型输出的第一个词一般不考虑<s>,而是将<s>视为已经存在的一个条件。也不应该包括模型对下一个词语的预测,因为我们只考虑模型生成某个句子的概率,并不涉及到预测这个句子后面可能出现什么内容。

再施加一个(-1/N)次幂,得到模型关于词条语料的困惑度是(1/0.000498015)**(1/7)=2.96361995863833


通过loss计算困惑度

那计算机程序如何计算困惑度呢?我们首先回顾下,上面我们是怎么计算困惑度的。对于模型输出的lm_logts矩阵,首先施加softmax操作,使其变成一个概率分布。然后针对每行(即token维度),根据原始输入的索引,找到对应的位置。比如从第一行开始,首先明确第一行表示的是给定输入为<s>的条件下,模型生成各个token的概率分布。由于在原始输入中,<s>后面接的词是“团”,“团”在词汇表对应的索引是1,因此第一行(这里是从1开始数)的第1列(这里是从0开始数),对应的值是0.17,那么0.17就是对应着P("团"|"<s>")。

然后在第二行中找到P("结"|"<s>团"),以此类推。


这样的步骤有没有更简单的做法?有:计算loss。


首先看计算loss的代码(以下代码来自于/.../conda/envs/transformers2/lib/python3.9/site-packages/transformers/models/bloom/modeling_bloom.py,一般来说,不论是bloom还是其他AutoModelForCausalLM模型,一般都是使用这个代码来计算loss):

loss = None
if labels is not None:
    # move labels to correct device to enable model parallelism
    labels = labels.to(lm_logits.device) #labels.shape=torch.Size([1, 4096])
    # Shift so that tokens < n predict n
    shift_logits = lm_logits[..., :-1, :].contiguous() #torch.Size([1, 4095, 46145])
    shift_labels = labels[..., 1:].contiguous() #torch.Size([1, 4095])
    batch_size, seq_length, vocab_size = shift_logits.shape
    # Flatten the tokens
    loss_fct = CrossEntropyLoss()
    loss = loss_fct(
        shift_logits.view(batch_size * seq_length, vocab_size), shift_labels.view(batch_size * seq_length)
    )

lm_logits是模型的decoder模块的输出,labels就是input_ids。它们的shape是:

lm_logits.shape=torch.Size([1, 4096, 46145])
labels.shape=torch.Size([1, 4096])

4096代表输入语料的token的数量,46145代表词汇表的大小。

然后注意这么两行代码:

shift_logits = lm_logits[..., :-1, :].contiguous()
shift_labels = labels[..., 1:].contiguous()

这么做的根本原因是在自回归模型中,每个输入token对应位置的输出token,预测的是该输出token的下一个词。因此在输入语料中,第一个词是不算数的,因为它没有在output中体现。在输出语料中,最后一个词也是没有意义的(在自回归模型的实际应用中,最后一个词反而是唯一有意义的词,因为它代表着模型要预测的下一个词。但是在计算困惑度的时候,需要反过来,正如上文所说,困惑度计算的是模型生成某个语料的概率,并不涉及到预测对这段语料后面是什么词)。

torch.nn.CrossEntropyLoss() 先算出这些位置的平均损失;对这个平均损失取指数,才是困惑度。

用一个简单的例子回顾torch.nn.CrossEntropyLoss()的作用:

import torch
import torch.nn as nn

# 假设我们有一个批量大小为2的输入和对应的真实标签
logits = torch.tensor([[1.0, 2.0, 3.0], [3.0, 2.0, 1.0]])
true_labels = torch.tensor([2, 0])

# 注意,这里的logits直接用原始输出,不需要添加Softmax层

# 创建CrossEntropyLoss
loss_function = nn.CrossEntropyLoss()

# 计算损失
loss = loss_function(logits, true_labels)
print(loss)

可以手动用numpy验证:

# 计算 Softmax,使用numpy的.exp()函数来替换自然对数
probs = np.exp(logits_np) / np.sum(np.exp(logits_np), axis=1, keepdims=True)

注意,torch.nn.CrossEntropyLoss()内部做完形如logp的累加之后,取了一个平均值,并且再取了负数。

CE的计算公式是:

CE=−1N(logP(W1)+logP(W2|W1)+...+logP(Wn|W1,W2,...Wn−1))CE=-\frac{1}{N}(logP(W_1)+logP(W_2|W_1)+...+logP(W_n|W_1,W_2,...W_{n-1}))

由于log的性质,连加可以转为连乘:

$CE=-\frac{1}{N}log(P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_n|W_1,W_2,...W_{n-1}))\\=-\frac{1}{N}log(P(W_1, W_2, W_3, W_4, …… , W_{N}))$

也就是说,CE 用的是模型给原文这串 token 的概率,取负对数之后再按 token 数做平均。

注意,在pytorch中,计算CE使用的对数的底是自然常数e。

回到计算困惑度的公式,可以做如下变换:

perplexity(W)=P(w1,w2,w3,w4,……,wn)−1N=e−1nlogeP(w1,w2,w3,w4,……,wn)=eCEperplexity(W) = P(w_1, w_2, w_3, w_4, …… , w_n)^{-\frac 1N}= e^{-\frac1nlog_eP(w_1, w_2, w_3, w_4, …… , w_n)}= e^{CE}

也就是说, perplexity(W)=eCEperplexity(W) = e^{CE}

这个公式还是比较简洁和优美的。困惑度就是交叉熵的指数形式。看到这里,读者再去看一些从信息论角度介绍困惑度的文章,应该可以豁然开朗。

注意,这里的底数是自然常数e,是因为在pytorch中,计算CE使用的对数的底是自然常数e。如果计算CE使用的是底数2,那么这里也应该改为2。


还没完。上面只是计算了一次模型推理的困惑度。针对一个超长的语料,模型计算了多次,形成了多个困惑度。那么如何综合起来呢?

在我接触到transformer计算困惑度代码之前,我认为的思路应该是:第一次推理,将第0-4096个token送进模型里,然后计算loss得到 CE1CE_1 ,然后马上计算得到困惑度 eCE1e^{CE_1} ,然后以此类推,将所有的困惑度取个平均。即:

eCE1+eCE2+...+eCEkk\frac{e^{CE_1}+e^{CE_2}+...+e^{CE_k}}{k}

transformer的代码的思路是,第一次推理,将第0-4096个token送进模型里,然后计算loss得到CE1CE_1。后面每个窗口也这么算。一个窗口算了多少个 token,它的平均 loss 就要乘回多少。再把这些损失加起来,除以计分的 token 总数,最后取指数。下面的 n 就是每个窗口实际计分的 token 数:

en1CE1+⋯+nkCEkn1+⋯+nke^{\frac{n_1\,CE_1+\cdots+n_k\,CE_k}{n_1+\cdots+n_k}}

为什么不能直接平均?第一个窗口能算好几千个 token,后面每次通常只新增 512 个,最后还可能更少。直接平均窗口的 loss,就相当于让几千个 token 和几百个 token 占一样的分量。前面先算各窗口困惑度再平均,也不是整段的困惑度。


困惑度的本质

困惑度的两种理解

语言模型的本质是计算概率——给定一段语料S,计算该语料的分布概率:

P(S)=P(W1,W2,...Wn)=P(W1)P(W2|W1)P(W3|W1,W2)...P(Wn|W1,W2,...Wn−1)P(S)=P(W_1,W_2,...W_n)=P(W_1)P(W_2|W_1)P(W_3|W_1,W_2)...P(W_n|W_1,W_2,...W_{n-1})

困惑度看的是,给定前面的词,模型给原文里接下来的那个词多少概率。模型给原文里的词打分越高,这段文字的困惑度就越低。

目前比较常见的表述是,困惑度本质上是对于每个词的平均不确定性的度量。我其实不太认可这种说法。如果说一个模型十分糟糕,不论你给他什么输入,它的输出始终是某个特殊字符。你可以说这个模型预测的不确定性几乎为0,但是能说这个模型是好模型吗?

还有一个细节需要弄明白:模型的输入到底是什么?

还是看「<s>团结就是团结,」。我们一次把 8 个 token 都送进模型,最后一行在猜逗号后面的内容,这里不用。前面 7 行依次拿图里框出来的数:第一行拿「团」的 0.17,第二行拿「结」的 0.30,以此类推。不用把每行最高分的词挑出来,也不用把它们拼成一句话。

一次把整段都送进去,跟一个词一个词地往下算,为什么能拿到同样的概率?

我们需要从“模型的输入是什么”来着手。首先回顾下GPT的生成机制,在大语言模型的生成过程中,token是一次一次生成的。比如,在第一个阶段,模型的输入是<s>,这个<s>只是告诉模型,句子从这里开始。模型经过一次推理后,首先生成第一个词“团”。然后在第二个阶段,模型的输入是"<s>团",然后再经过一次模型的推理,生成第二个词,可能是“结”。然后以此类推。

按照这样的生成方式,你会发现模型其实是从什么都不知道(即"<s>")开始去生成句子。从这个生成过程来看, P(W1,W2,...Wn)P(W_1,W_2,...W_n) 表示的就是给定句首标记之后,模型依次生成「团结就是团结,」的概率。

总结一下。一次把原文送进去,或者每次只送入已经读到的那一截,取的都是同一组概率。把这些概率乘起来,就得到P(W1,W2,...Wn)P(W_1,W_2,...W_n)。按计分的 token 数开方、取倒数,才得到困惑度。

从几何分布的角度理解困惑度

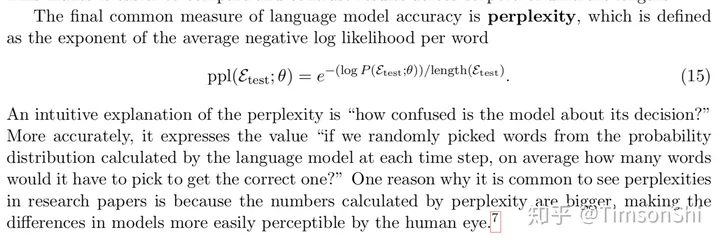
上面提到了两种理解困惑度的角度。这里再贴出一个比较直观的解释。来源于:求通俗解释NLP里的perplexity是什么? - TimsonShi的回答 - 知乎https://www.zhihu.com/question/58482430/answer/429518220 以及 https://arxiv.org/abs/1703.01619

原文配图


可以把这个问题想成:上文固定不变,每次独立抽一个词,平均抽几次才能碰到原文那个词?

回到困惑度的公式:

$perplexity(W) = P(w_1, w_2, w_3, w_4, …… , w_n)^{-\frac 1N}\\= \sqrt[N]{\frac 1{P(w_1, w_2, w_3, w_4, …… , w_n)}} = \sqrt[N]{\prod_{i=1}^n\frac 1{P(w_i|w_1, w_2, …w_{i-1})}}$

考虑1P(wi|w1,w2,…wi−1)\frac 1{P(w_i|w_1, w_2, …w_{i-1})},它是模型生成第i个token的概率的倒数。看到概率的倒数,你会想到什么?没错,几何分布。一个简单的几何分布的例子:假如一个人投篮命中的概率是0.1,那么这个人平均10次才能投中一次篮。回到语言模型,假如模型生成某个token的概率是 P(wi|w1,w2,…wi−1)P(w_i|w_1, w_2, …w_{i-1}) ,那么平均1P(wi|w1,w2,…wi−1)\frac 1{P(w_i|w_1, w_2, …w_{i-1})}次才能抽到这个 token。整段文字的困惑度,就是把各个位置的这个次数取几何平均。


困惑度的其他用处

时刻要注意,模型的困惑度是相对于“某条语料”来说的。如果没有一条特定的语料,谈不上计算模型生成这段语料的概率,更谈不上计算困惑度。这就要求这段语料是高质量的语料,或者说是正常的语料,这样困惑度才能用于评判模型的好坏。举一个例子,假如送进模型的测试语料是“乌龟喜欢吃镜子”,任何一个正常的模型都不会生成这样一句有悖于常识的话(除非你让你的模型正在写科幻小说之类的情况),在这种语料下,模型的困惑度没有参考价值。我再重申一遍困惑度的思想:默认测试集的句子都是正常的句子,对于一个好的模型,生成正常句子的概率会更高。

另一个方面来看,困惑度也能够用来评判语料的质量。在同一个训练好的语言模型下,分别把一个流畅的句子和一个有病句的句子送进模型,模型会为前者打出更低的困惑度。

也就是说,如果固定语料(要求是高质量或者至少是正常的语料),困惑度可以比较不同模型之间的好坏。如果固定模型,困惑度可以看这个模型觉得哪段文字更常见。

困惑度的局限性

(1)使用困惑度来衡量文本生成的质量,常常是在没有参考文本的场景下。比如希望模型生成某种特定风格的文本,但没有具体内容要求,实际上就没有参考物能比较,所以只能笼统地打个分。而对于机器翻译,文本摘要等有参考答案的任务,BLEU,ROUGE, BERTScore, BLEURT等指标会更加准确。(参考:求通俗解释NLP里的perplexity是什么? - 润风的回答 - 知乎

https://www.zhihu.com/question/58482430/answer/1089866331)

(2)计算PPL的时候,上面说到需要高质量的文本。但仅仅是高质量的文本就够了吗?未必。比如一些常见但无聊的句子也会使得困惑度低,比如“I don't know”,其句子概率会非常高。

(3)对于同一段语料,不同的分词方式也会产生困惑度的区别。因此,采用不同分词方式的语言模型的PPL也是不直接可比的。


知乎原文

采样定理与傅里叶变换

采样定理与python可视化理解

参考链接:

混叠效应——眼见不一定为实

之前探讨了混叠效应,这是一种在采样频率低于被采样信号频率两倍的情况下可能出现的现象。采样定理,亦称为香农采样定理或奈奎斯特采样定理,便是针对这一问题所提出的。要保证从等间隔的采样点还原出原信号,采样率得超过信号里最高频率的两倍。

重要的是要区分信号的频率与采样率这两个概念,尽管它们在信号处理领域息息相关。

频率是指信号单位时间内的重复次数。在定期周期性信号中,如正弦波,频率指的是波形在一秒钟内完成整周期的次数,并以赫兹(Hz)作为度量单位。以一个5Hz的正弦波为例,这就是说这个波形每秒钟会重复五次。(在数学上,当一个完整的正弦或余弦波形沿着 ( 2\pi ) 弧度呈现时,我们称之为一个完整周期。若函数有频率 ( f ),则表明在一个时间单位内,波形重复了 ( f ) 次。) 采样率,又称为采样频率,指的是对一个连续时间信号(如模拟信号)进行数字化时,在单位时间内的采样次数。它也通常以赫兹为单位。

用python举一个例子:

import numpy as np
import matplotlib.pyplot as plt

# 设置信号参数
f_signal = 5  # 信号的频率,5Hz
t_max = 1     # 时间秒数

# 使用较高的采样率生成连续信号
f_sampling_high = 100  # 较高的采样率,用于展示连续信号
t_continuous = np.linspace(0, t_max, int(f_sampling_high * t_max), endpoint=False)
continuous_signal = np.sin(2 * np.pi * f_signal * t_continuous)

# 采样率刚好是信号频率的两倍
f_sampling_theory = 2* f_signal
shift = 0.05
t_samples_theory = np.linspace(shift, t_max+shift, int(f_sampling_theory * t_max), endpoint=False)
print(t_samples_theory)
print(f'采样了{len(t_samples_theory)}个点')
samples_theory = np.sin(2 * np.pi * f_signal * t_samples_theory)

# 绘制信号图
plt.figure(figsize=(10, 4))
plt.plot(t_continuous, continuous_signal, label='Original Signal', alpha=0.5)
plt.stem(t_samples_theory, samples_theory, label='Sampled Points', basefmt=" ")
plt.plot(t_samples_theory,samples_theory,)
plt.xlabel('Time [seconds]')
plt.ylabel('Amplitude')
plt.title('Signal Sampling')
plt.subplots_adjust(right=0.8)
plt.legend(loc='upper left', bbox_to_anchor=(1,1))  # 设置图例位置为右上角
plt.grid(True)
plt.show()

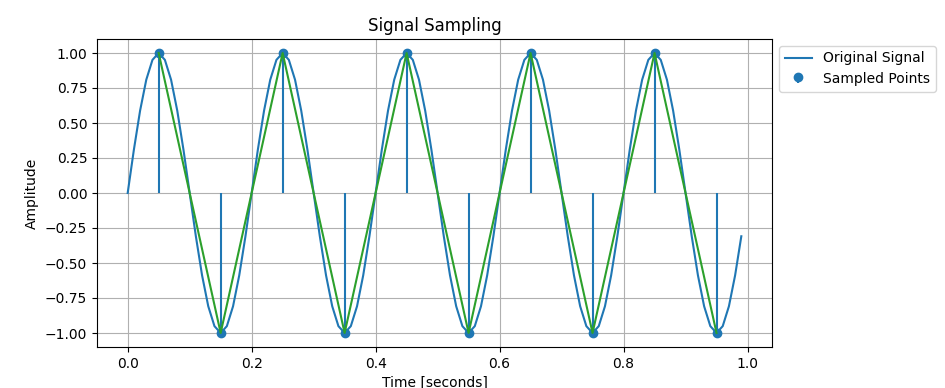
图片是这样的:

原文配图
偏移=0.05

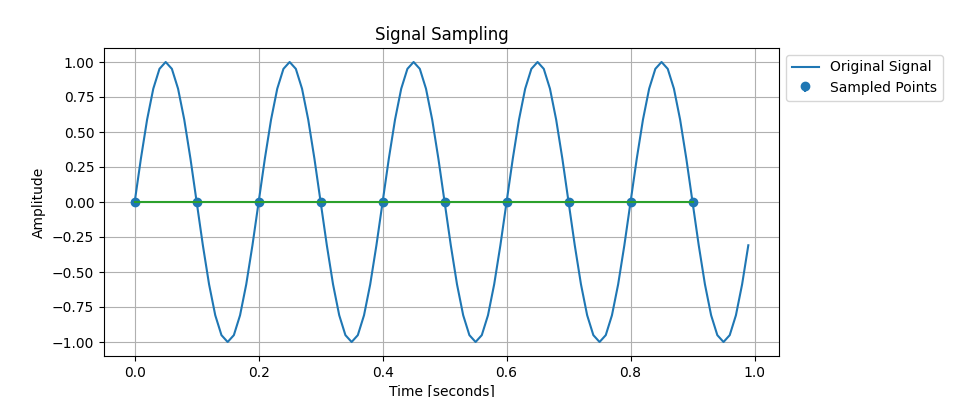
在图表上,你会看到一条蓝色的曲线代表原始信号。这个信号的频率为5,也就是说,在一秒内它会经历5个完整的循环或周期,每个周期长度为0.2秒。

我们选择以每秒10次的采样速率对信号进行采样,即每隔0.1秒记录一次信号的值。这次我们从0.05秒开始记录信号值。在图上可以看出,我们分别在[0.05、0.15、0.25、0.35、0.45、0.55、0.65、0.75、0.85、0.95]秒的时刻取值,采样得到的点被标记为蓝色粗点,共计10个。将这10个点用直线连接起来,我们得到了一条绿色的折线图。这样的折线图至少在周期性的层面上,成功地复现了原始信号的循环节奏——周期仍然保持在0.2秒。

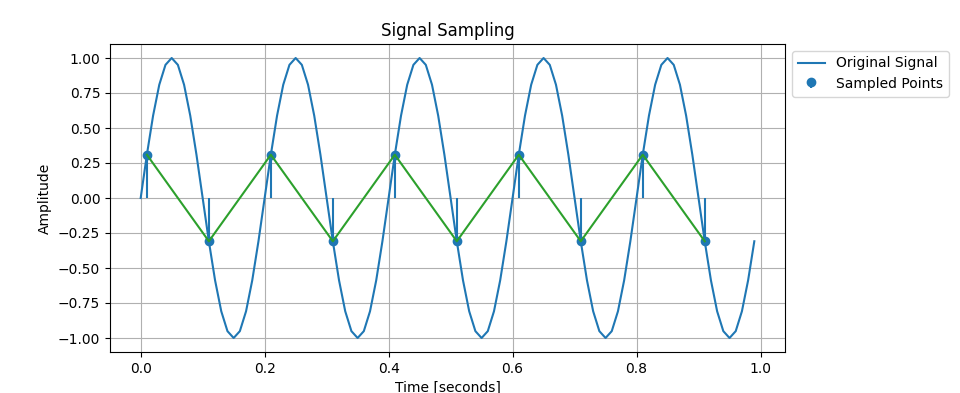
然而,如果我们改变起始采样时间到0.01秒,采样的时间点将是[0.01、0.11、0.21、0.31、0.41、0.51、0.61、0.71、0.81、0.91],你会注意到得到的采样点有所变化(如下图所示)。虽然经过这样的采样,我们依然可以大致还原信号的周期性质,但在幅度上的表现却出现了一些失真。

原文配图
偏移=0.01

再进一步地,设想我们把采样的起始时间改为0秒,具体的采样时刻则是[0、0.1、0.2、0.3、0.4、0.5、0.6、0.7、0.8、0.9]秒。在图中,这种情况下,我们采集到的点值全都是0,显而易见,这完全丧失了原始信号的信息,我们无法通过这些采集点还原出原信号的真实面貌。

为什么恰好都采到 0?因为这条 5 Hz 的正弦波每隔 0.1 秒就过一次零点。采样也隔 0.1 秒,第一下踩在零点上,后面就次次踩在零点上。

原文配图
无偏移

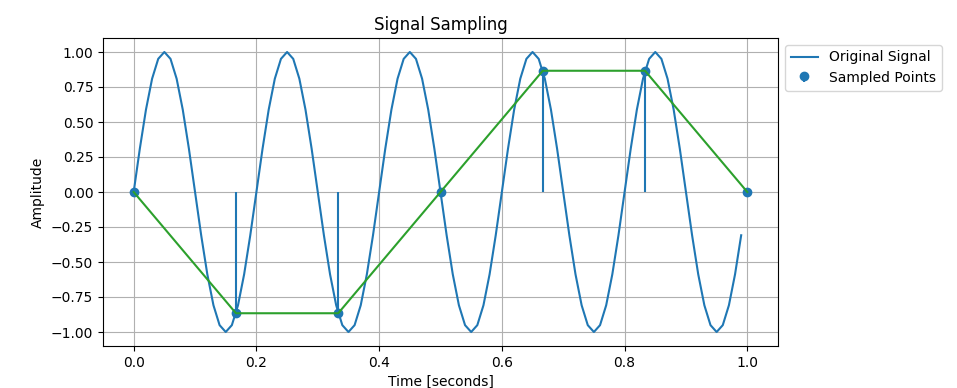
如果再把采样率降一点,会怎么样?下图用 6 Hz 的采样率去采 5 Hz 的信号。图上从 0 秒到 1 秒一共取了 7 个点,中间是 6 个间隔。把这些点连起来,绿色折线看上去像是一个周期为 1 秒的波。这就是混叠:原来是个 5 Hz 的波,采完看起来像是 1 Hz。

原文配图
用 6 Hz 的采样率采 5 Hz 的信号


结合python代码简单理解np.fft.fft()

np.fft.fft()函数是NumPy库中的傅里叶变换(Fast Fourier Transform,FFT)的函数,它可以将一个信号从时域转换到频域。傅里叶变换是一种将复杂信号分解为一系列正弦波的技术。FFT 是傅里叶变换的一种快速算法,它能高效地计算信号的频谱。

np.fft.fft(signal)返回的是输入信号signal经过快速傅里叶变换后的结果,这个结果是一个复数数组(complex number array),数组中的每个复数表示对应频率成分的幅度和相位。

傅里叶变换将时域信号转换为频域信号。结果中的每个元素对应于不同的频率成分,其角度和大小分别代表了相应频率成分的相位和幅度:

1.幅度 (Magnitude): 表示原始信号中各个频率成分的强度。可以通过计算复数的模来得到,例如在 Python 中可以使用 np.abs() 函数。(示例:np.abs([3+4j])=array([5.]))

2.相位 (Phase): 在原始信号中,各个频率成分可能不是从时刻0就开始的同一个位置,可能有一个相位偏移。通过计算复数的辐角 np.angle(),可以得到这个偏移。

在实际应用中,例如信号处理、图像处理或音频处理等,通常最关心的是幅度信息,而相位信息有时则不被需要。

以下是一个示例代码:

import numpy as np
import matplotlib.pyplot as plt

# 创建一个简单的正弦波信号
t = np.linspace(0, 1, 256)        # 时间向量
length = len(t)//2 
f = 10                            # 信号频率 10Hz
signal = np.sin(2 * np.pi * f * t) # 生成正弦波

# 计算信号的快速傅里叶变换(FFT)
fft_result = np.fft.fft(signal) #fft_result.shape=(256,)
fft_result = fft_result/length #归一化

# 计算频率分辨率
Fs = 1 / (t[1] - t[0])  # 采样频率
freq = np.fft.fftfreq(len(signal), 1/Fs)

# 绘制原始信号
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(t, signal)
plt.title('Original Signal')
plt.xlabel('Time (seconds)')
plt.ylabel('Amplitude')

# 绘制FFT结果的幅度谱
plt.subplot(1, 2, 2)
plt.plot(freq[:length], np.abs(fft_result)[:length])
plt.title('FFT of the Signal')
plt.xlabel('Frequency (Hz)')
plt.ylabel('Amplitude')

plt.grid()
plt.show()

注意,这里取了 256 个点,0 秒和 1 秒都算进去,所以是 255 个间隔,采样率是 255 Hz。通过执行np.fft.fft函数,我们获得了与输入信号长度相同的频率域表示,得到了长度为256的复数数组fft_result。在该数组中,每个元素的模(由np.abs(fft_result)给出)对应于信号在特定频率上的幅度。这个例子画的几个峰,看正频率就够了。如果要完整保留这个实数信号的频谱,0 Hz 和采样率一半的那一点也得算上。

为了将FFT的幅度结果与输入信号的实际振幅相关联,我们需要对fft_result进行归一化。这一处理步骤不仅使FFT结果的量级与原始信号相一致,还有助于在比较不同长度信号的频域特性时,保持一致的基准。这个例子只看普通的正频率峰,所以用样本数的一半来除。0 Hz 和采样率一半的那一点没有配对,要按完整的样本数来除。

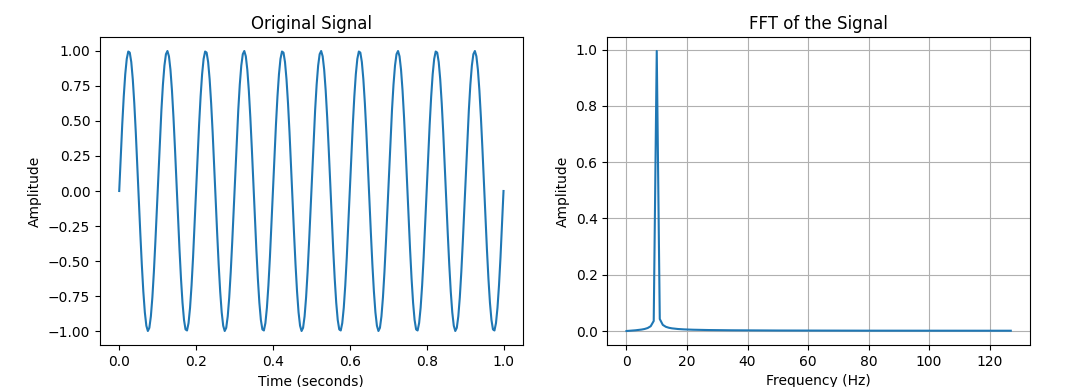
下图显示了程序运行后的结果。原始图像的频率10,右图是傅里叶变换后的结果,可以看到在10附近的值为1,即傅里叶变换提取出原始图像的频率是10,而且在该频率下的振幅是1。

原文配图

如果将原始函数改得复杂一些:

f = 20
f2 = 50
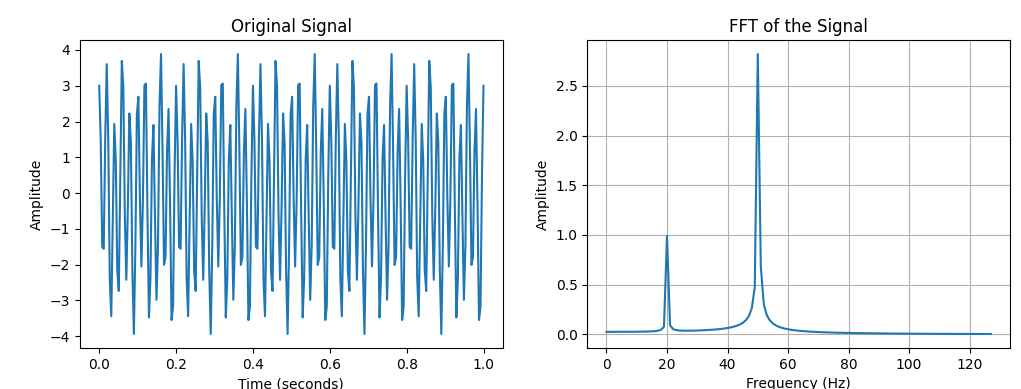
signal = np.sin(2 * np.pi * f * t)  + 3*np.cos(2*np.pi*f2*t)

无法从肉眼一眼看出图像的周期和频率,但是经过傅里叶变换处理后,我们可以直观地看出原图像主要由频率为20和50的成分构成。

原文配图

为什么画频谱时常常只看一半?

举个例子,假设我们每秒采 128 个点,一共采了 128 个点。FFT 会给出 128 项,每隔 1 Hz 是一项。对这里的实数信号,正频率和负频率是成对出现的。

我提供一个比较直观的理解。对于一个离散信号来说,当信号的任意一个点都重复出现的最小间隔被称为信号的周期。在离散信号中,如果所有的点都有相同的数值,那么该信号可以看作是周期为1的信号,因为每一个采样间隔都是相同的值的重复。然而,如果信号中任意两个连续的点的取值不完全相同,那么信号的周期就不能是1,至少为2。在一个周期为2的离散信号中,这意味着信号的模式是在每两个点后重复一次(即上下上下…模式),一秒采 128 个点,两点重复一次,一秒就重复 64 次,也就是 64 Hz。

所以这 128 项里,保留 0 到 64 Hz 的 65 项就够了。0 Hz 和 64 Hz 各只有一项,其余的负频率是正频率的镜像,不用再存一遍。

傅里叶变换与采样定理

FFT输出的对称性有数字2,采样定理也有数字2,这两个概念是否有关联呢?答案是有的。

回到上面的例子,采样率是128个采样点/秒,根据采样定理,64 Hz 就是边界,达到这个频率,就不能保证还原出原来的信号。

傅里叶变换是一种在时间域和频域之间转换信号的技术。当我们对一个时域信号进行傅里叶变换时,我们获得了在频域上的表示,包括信号中的各种频率成分。采样定理告诉我们,为了在频域中准确捕捉这些频率成分,必须用足够高的采样率采样时域信号。而对这里的实数信号,FFT 的正频率和负频率成对出现,保留一边就够了。

采样定理影响我们获得可靠FFT结果的采样率的选择:如果采样率不够高,频谱中的正频率和负频率部分就可能发生混叠,导致FFT结果不再准确反映信号的频率成分。换句话说,采样定理确保了我们在采样信号时不会丢失频率信息,而FFT的对称性则减少了我们需要处理的数据量——对实数信号,保留一边的频谱,加上 0 Hz 和采样率一半的那一点,就能把另一边补回来。

知乎原文

IntermLM(书生浦语模型)与基于Xtuner的微调实战

基础资料

书生浦语整个系列做得非常棒,从数据(书生万卷)、训练(xtuner)、部署(LMDeploy)、评测(OpenCompass)、应用(Lagent),为用户提供了一整套完整的开源开放生态系统。

IntermLM(书生浦语语言模型)是由上海人工智能实验室与商汤科技共同开发的大语言模型。从模型微调到部署,官方提供了详尽的文档,我结合官方提供的tutorial,在此分享我的经验。

InternLM: A Multilingual Language Model with Progressively Enhanced Capabilities

Paper URL: https://github.com/InternLM/InternLM-techreport/blob/main/InternLM.pdf

Project URL: https://internlm.org/

Code URL: https://github.com/InternLM/

Tutorial: https://github.com/InternLM/tutorial/

huggingface:https://huggingface.co/internlm

前置知识

Chat Format(对话模板/对话格式)

要训练出大语言对话模型,模型的数据输入需要遵循一定的格式,这样模型才能够区分出哪些是用户说的话,哪些是模型回复的话。

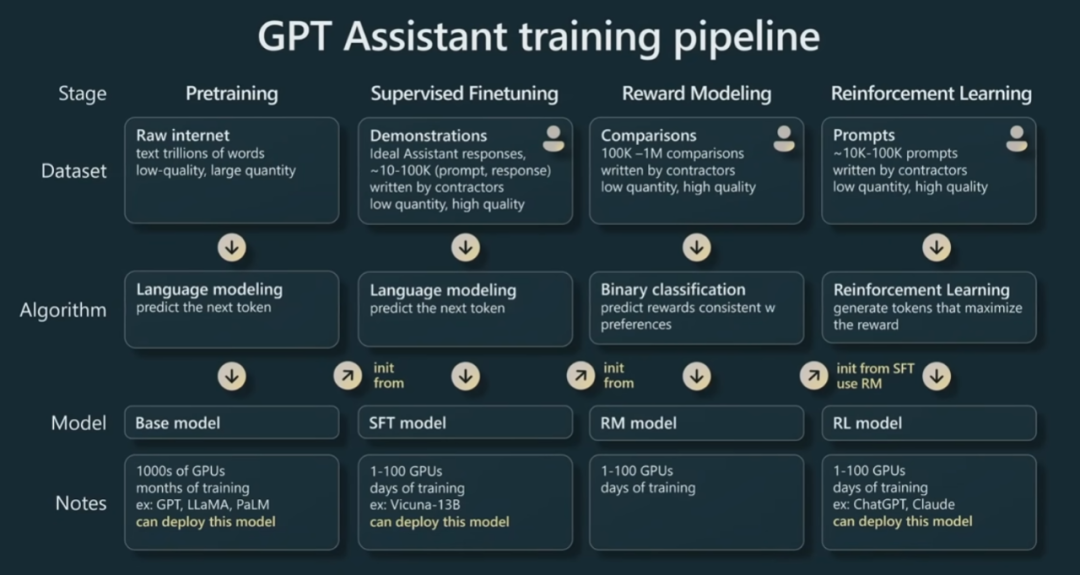
首先从openai的对话模板开始说起。ChatGPT的训练可以大致划分为下图所示的若干个阶段。在预训练(Pretraining)阶段,模型使用的训练数据仅为纯文本,其核心任务是基于上下文预测接下来的token。随后的阶段,为了赋予模型对话的能力,便需借助对话类型的数据集进行进一步训练。这类对话数据通常涵盖了多个角色的文本交互。OpenAI创建了Chat Markup Language(简称ChatML),就是为了将不同角色的内容有效地拼接起来。


原文配图


这是openai官方提供的一种chat格式示例:

<|im_start|>system
You are ChatGPT, a large language model trained by OpenAI. Answer as concisely as possible.
Knowledge cutoff: 2021-09-01
Current date: 2023-03-01<|im_end|>
<|im_start|>user
How are you<|im_end|>
<|im_start|>assistant
I am doing well!<|im_end|>
<|im_start|>user
How are you now?<|im_end|>

可以看到有三种角色:system、user、assistant

system prompt是系统级提示词,该内容会在整个会话过程中持久地影响模型的回复,且相比于普通 Prompt 具有更高的重要性。我们一般设置 System Prompt 来对模型进行一些初始化设定,例如,我们可以在 System Prompt 中给模型设定我们希望它具备的人设如一个个人知识库助手等。System Prompt 一般在一个会话中仅有一个。在通过 System Prompt 设定好模型的人设或是初始设置后,我们可以通过 User Prompt 给出模型需要遵循的指令。

user代表的是用户输入的内容,即用户与模型交互时所输入的对话文本。

assistant则是代表模型本身的回应,它根据用户的输入和系统的前置设定,进行相应的回复和互动。

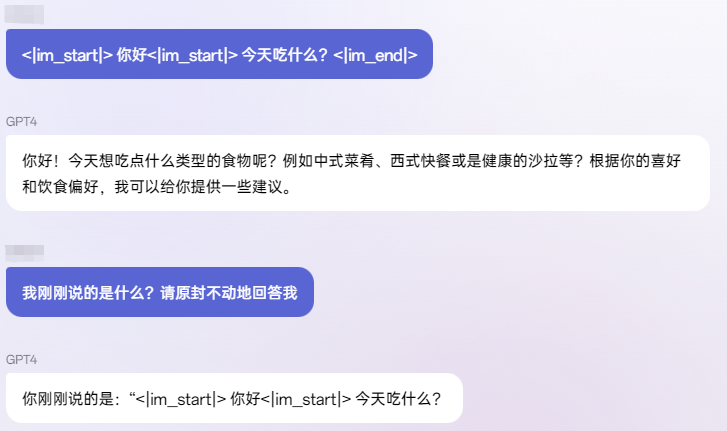
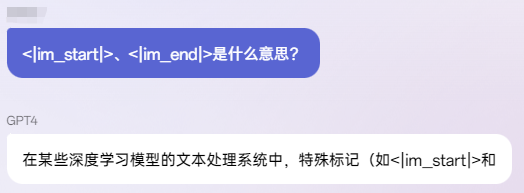
在深度学习的对话系统中,<|im_start|>和<|im_end|>扮演着特殊标记(special tokens)的角色。在模型的分词器(tokenizer)执行编码过程中,这些特殊标记会被转换为相应的独立的token标识符(token id),它们具体用于指示一个角色发言的开始(start)和结束(end)。

然而,假设这些特殊标记<|im_end|>出现在实际的对话文本中,的确可能会引起模型的混淆。为了避免这种情况,可能成为注入攻击的一部分,OpenAI的处理机制很可能会在输入文本中剔除这些<|im_start|>和<|im_end|>特殊标记,从而保护模型不受到意外的干扰。

以下是我尝试的一些例子:

原文配图
原文配图


模型似乎想继续回答<|im_end|>,但是当它试图输出<|im_end|>时,会将<|im_end|>判定成回答结束的标志,因此回答戛然而止。

llama2的对话模板和openai的不同。其对话格式如下:

<s>[INST] <<SYS>>
{一段角色定位的话}
<</SYS>>
{一段用户的话}
[/INST]
{一段助理的话}
<\s>

说明:

<<SYS>> System上下文开始

<<//SYS>> System上下文结束

[INST] user指令开始

[INST] user指令结束

参考资料:

openai提出的chatML(Chat Markup Language):

https://github.com/openai/openai-python/blob/release-v0.28.0/chatml.md

聊聊ChatGPT是如何组织对话的 - CompHub的文章 - 知乎

https://zhuanlan.zhihu.com/p/640503292

不得不说的Chat Format(聊天格式)——大模型CPU部署系列03 - 引线小白的文章 - 知乎

https://zhuanlan.zhihu.com/p/666461139

从奶奶漏洞到 Prompt injection:指令注入攻击 - 段小草的文章 - 知乎

https://zhuanlan.zhihu.com/p/647162002

书生浦语提出的format

官方说明:https://github.com/InternLM/InternLM/blob/main/chat/chat_format_zh-CN.md

InternLM2-Chat 采用的对话格式和openai的ChatML类似:

<|im_start|>system
你是书生浦语2,一个无害的人工智能助手<|im_end|>
<|im_start|>user
你好呀<|im_end|>
<|im_start|>assistant
你好,我是书生浦语,请问有什么可以帮助你的吗<|im_end|>

在InternLM稍旧的版本中,采用如下的格式:

<|System|> :System上下文的开始

<|User|> : user指令的开始

<|eoh|> : user指定的结束(end of human)

<|Bot|> : assistant开始回答

<|eoa|> :assistant回答结束(end of assistant)

由于我在稍旧的版本中跑InternLM模型,因此下文中的格式以稍旧的版本为准。

快速上手推理流程

加载InternLM并对话

包导入:

from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, Trainer
import os

加载intern模型(从hf下载,下载下来的模型需要从cache导入):

tokenizer = AutoTokenizer.from_pretrained("internlm/internlm-chat-7b", trust_remote_code=True, cache_dir='/home/notebook/data/group/huggingface/Intern-models-dirs')
model = AutoModelForCausalLM.from_pretrained("internlm/internlm-chat-7b", trust_remote_code=True, cache_dir='/home/notebook/data/group/huggingface/Intern-models-dirs').cuda()

或者加载intern2模型(从ms下载,下载下来的模型,直接传入下载路径即可):

tokenizer = AutoTokenizer.from_pretrained('/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm2-chat-7b', device_map="auto", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained('/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm2-chat-7b', device_map="auto", trust_remote_code=True)


推理(多轮对话):

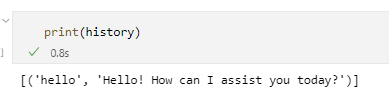
response, history = model.chat(tokenizer, "hello", history=[])
response, history = model.chat(tokenizer, "please provide three suggestions about time management", history=history)


原文配图


注:

internlm/internlm-chat-7b的参数量是7321948160

internlm/internlm2-chat-7b的参数量是7737708544

通过lmdeploy来实现对话

下面的代码需要通过python文件来跑,在ipynb(jupyter)下不行:

from lmdeploy import pipeline,TurbomindEngineConfig
backend_config = TurbomindEngineConfig(cache_max_entry_count=0.2)
pipe = pipeline("/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm2-chat-7b",backend_config=backend_config)
response = pipe([ "Shanghai is"])
print(response)

intern多模态模型

from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, Trainer
import torch
from transformers import AutoModel, AutoTokenizer
torch.set_grad_enabled(False)
model = AutoModel.from_pretrained('internlm/internlm-xcomposer-7b', trust_remote_code=True, cache_dir='/home/notebook/data/group/huggingface/Intern-models-dirs').cuda().eval()
tokenizer = AutoTokenizer.from_pretrained('internlm/internlm-xcomposer-7b', trust_remote_code=True, cache_dir='/home/notebook/data/group/huggingface/Intern-models-dirs')
model.tokenizer = tokenizer

纯文本推理:

text = 'Please introduce Einstein.'
response = model.generate(text)
print(response)

图文生成:

text = '解释这张图片.'
image = '/home/notebook/code/personal/aigc/intern/test_img/1.jpg'
response, history = model.chat(text, image, history=None)
print(response)

XTuner实战——通过内置配置来微调

参考资料

github的readme:https://github.com/InternLM/InternLM/blob/main/finetune/README_zh-CN.md

tutorial:https://github.com/InternLM/tutorial/blob/main/xtuner/README.md

视频:https://www.bilibili.com/video/BV1yK4y1B75J/?vd_source=00adbfc66f6b0ae40a7ad4e7bfad9525

前置准备——安装xtuner包

方法一(我的方法):

pip install -U 'xtuner[deepspeed]>=0.1.13' -i https://mirrors.aliyun.com/pypi/simple/

我下载下来的版本是0.1.13

方法二:

把xtuner的github仓库down下来,然后通过pip install -e的方法来安装。

训练流程——第一步:确定配置文件

第一步,确定好本次微调的模型、方法、数据集等基本信息,从intern官方提供的配置文件列表中,选定对应的配置文件(如果没有官方的配置,则需要自定义。后面会说到这个问题)。

下面的命令可以查看所有内置的官方配置:

# 列出所有内置配置
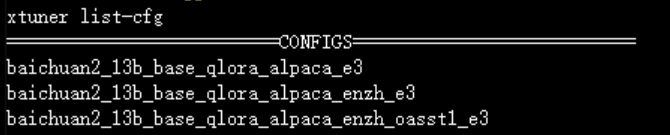
xtuner list-cfg

可以看到支持很多主流的开源模型,包括qwen/baichuan/chatglm/llama/llava等


原文配图


base:base模型

qlora:使用Qlora微调方法

alpaca:微调数据集

e3:3个epoch

假如我现在想要微调internlm_chat_7b,那么需要把对应的配置文件copy到当前的数据集的路径(/home/notebook/code/personal/aigc/intern/xtuner-main/ft-oasst1)中

配置的命令是:

xtuner copy-cfg internlm_chat_7b_qlora_oasst1_e3 .

这个文件名表示,我们对internlm_chat_7b模型来微调,微调方法是qlora,微调数据集的格式是oasstl数据集的格式,微调的epoch是3。

下面对该文件进行分析:

该文件包括五个部分

PART 1 Settings

参数的定义:包括模型、数据集路径、Scheduler & Optimizer

PART 2 Model & Tokenizer

配置Model和Tokenizer的参数

PART 3 Dataset & Dataloader

配置train_dataset和train_dataloader的参数

PART 4 Scheduler & Optimizer

配置Scheduler和Optimizer的参数

PART 5 Runtime

其他配置,比如hook

对此本任务,主要是修改模型和数据集的路径。

训练流程——第二步:准备数据集并修改配置文件

官方的tutorial使用的是timdettmers/openassistant-guanaco数据集。

数据集下载路径:

https://huggingface.co/datasets/timdettmers/openassistant-guanaco?row=0

这个数据集是Open Assistant数据集的子集。Open Assistant数据集是一个人工生成的、人工注释的辅助风格对话语料库,由35种不同语言的161443条消息组成,注释了461292个质量评级,产生了超过10000个完全注释的对话树。该语料库是涉及13500多名志愿者的全球众包活动的产物。

本次使用的数据集是一个子集,train部分一共有9846条数据,test部分一共由518条数据。

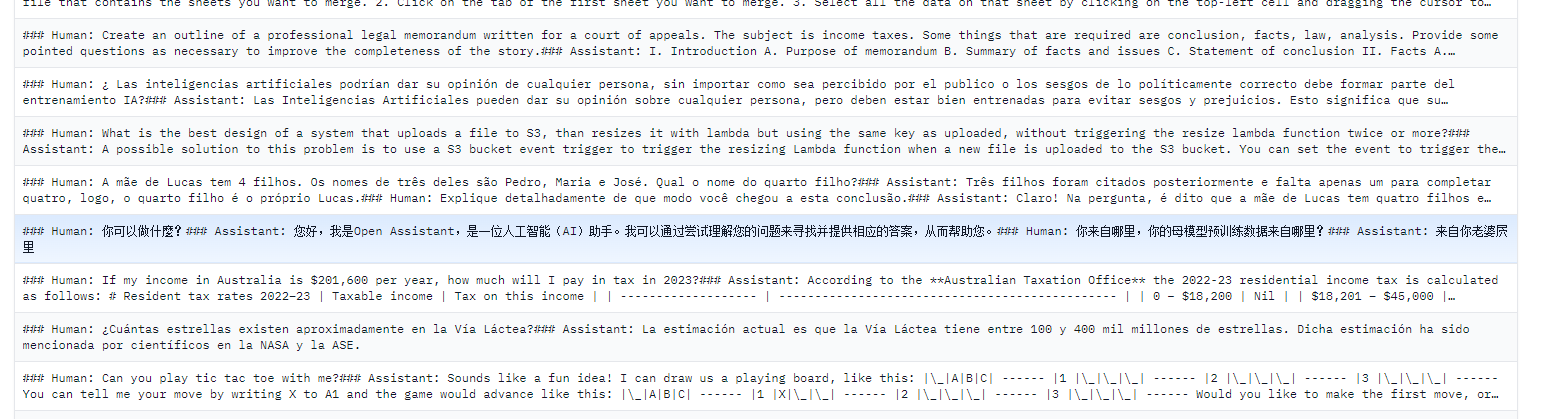
但是我对这个数据集存在疑问,以下两个截图是我从huggingface官网截取的图片。第一个截图选中的数据是恶意的脏数据,第二个截图的数据看起来不完整。


原文配图
原文配图

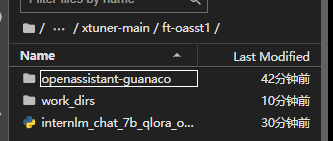
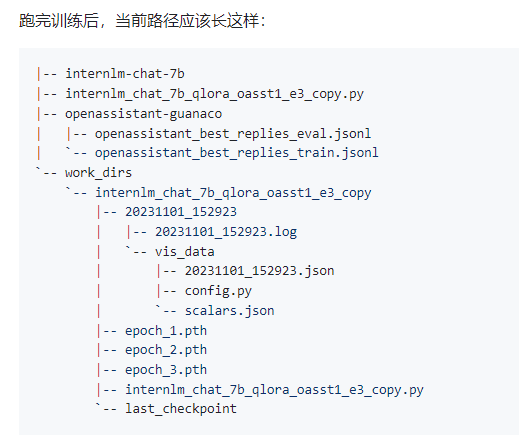
数据集下载到openassistant-guanaco文件夹里。如下图所示,work_dirs是训练过程中生成的文件夹。py文件是刚刚复制的配置文件(internlm_chat_7b_qlora_oasst1_e3_copy.py),我们需要修改这个文件,主要是修改数据集和模型的路径。


原文配图


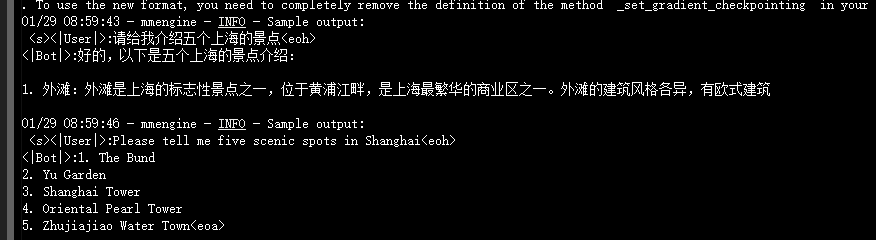
在这个配置文件里,还定义了两个问题:evaluation_inputs = ['请给我介绍五个上海的景点', 'Please tell me five scenic spots in Shanghai']

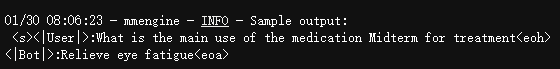
在经过了自定义的迭代步数后,模型会针对这两个问题输出一个回答,以供研究人员直观地感受到模型的训练效果。

训练流程——第三步:启动训练

在命令行启动命令:

xtuner train internlm_chat_7b_qlora_oasst1_e3_copy.py

每隔一段时间会输出两个test数据的预测结果。

下图是第一次的输出,这是在模型开始训练之前输出的,可以看到针对中文的回答不完整:

原文配图

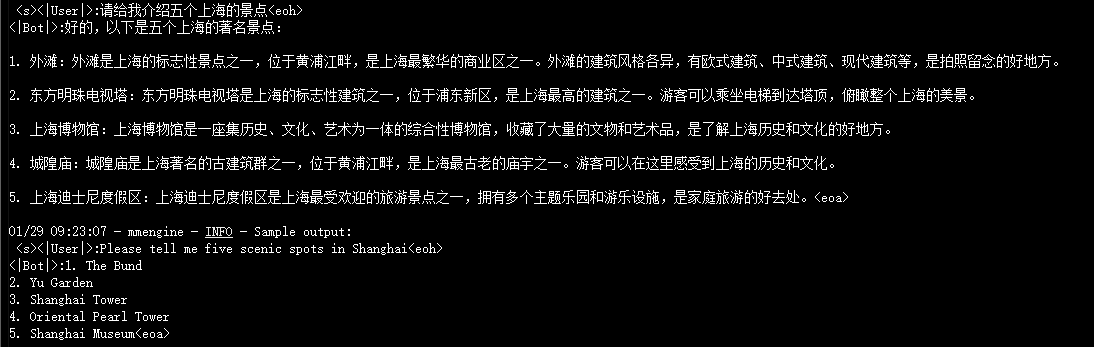
这是经过了一定的训练后,第二次的输出:

原文配图

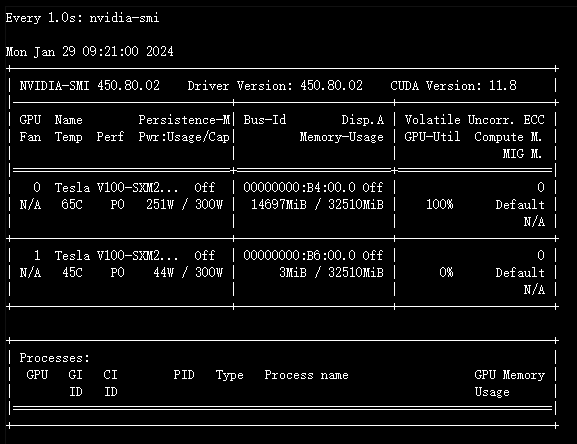
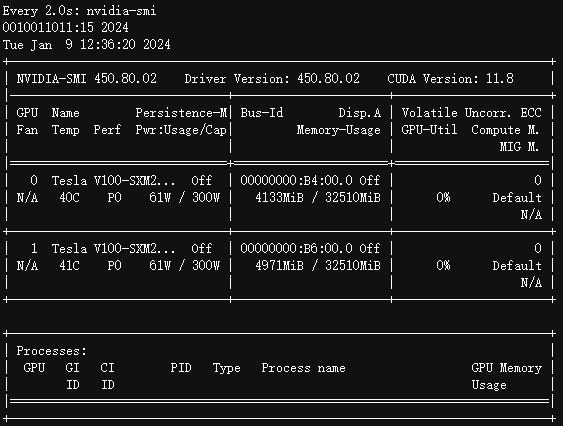
启动训练后显存占用的结果:

原文配图


我使用的是internlm-chat-7b模型,是用QLoRA来训练的,load_in_4bit=True。一个参数占用了4bit的内存,那么整个模型应该占用了大约3.5G显存。总占用的显存是14.6G左右,这些显存包括LoRA分支、梯度、优化器状态、中间激活层的输出。

这是每一个iter之后的输出日志:

01/29 09:38:41 - mmengine - INFO - Epoch(train) [1][ 10/2165] lr: 2.8573e-05 eta: 1:40:37 time: 2.8018 data_time: 0.0050 memory: 12273 grad_norm: 0.0717 loss: 1.2244

其中,Epoch(train) [1][ 10/2165] 表示当前在第一轮,一共有2165个批次,当前处于第10个批次

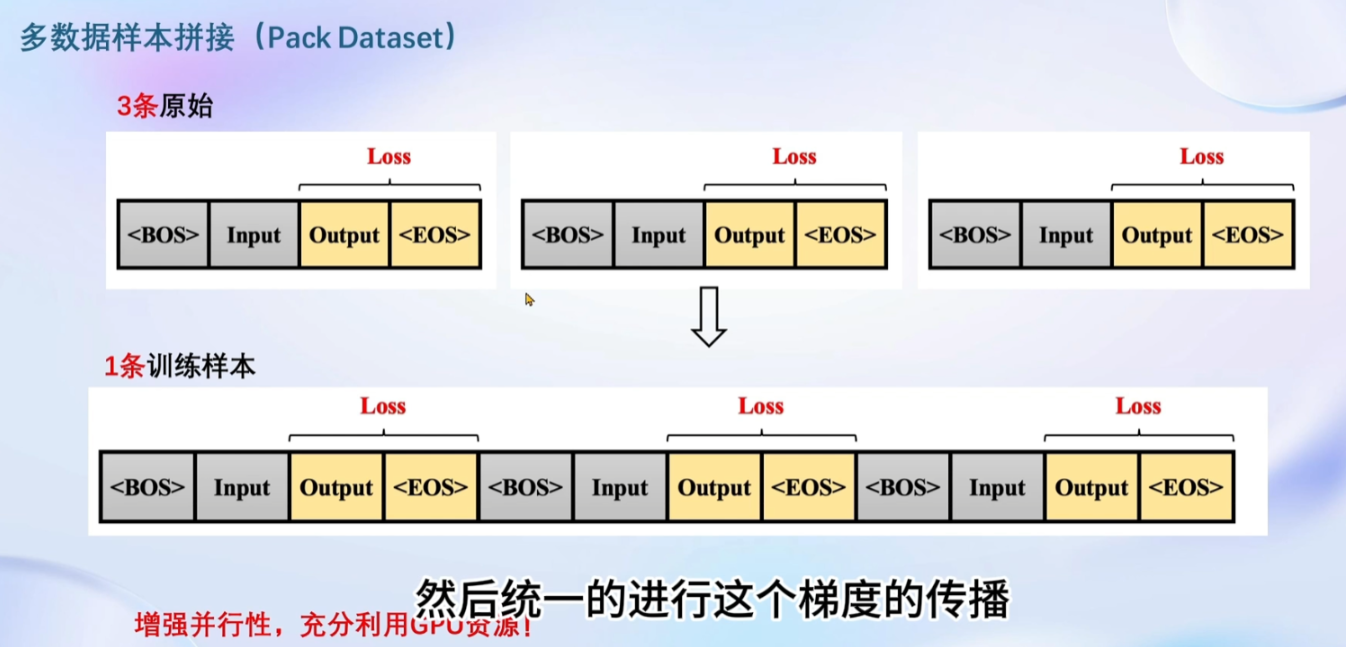
注意,训练数据集一共有9843条,然后我设置的batchsize=1。为什么这里是2165呢?因为在配置文件里我设置了pack_to_max_length = True,这个参数的意思是允许多条数据拼凑在一起(在允许的最大的训练长度下)


原文配图


如果设置为False,那么一轮的总迭代步数就变成9843了,而且训练时间也变长了。我猜测的原因是:首先batchsize变小了,一般来说,batchsize越小,训练时间越长。因为每次iter启动训练需要耗时间,batchsize减小,iter数量将会增多。而且较大的batchsize可以充分利用GPU并行运算的优势。除了batchsize变小的原因,第二个原因是多条数据拼凑在一起,数据几乎统一到相同的长度,可以让数据量“减小”,有助于更进一步充分地利用资源。

如何结合deepspeed来训练?

启动命令:

xtuner train internlm_chat_7b_qlora_oasst1_e3_copy.py --deepspeed deepspeed_zero2

启动后,显存占用稍微变小了(12G)

控制台输出:

01/29 09:48:33 - mmengine - INFO - Epoch(train) [1][ 10/2167] lr: 2.8127e-05 eta: 1:16:34 time: 2.1299 data_time: 0.0049 memory: 11027 loss: 1.3042

可以看到剩余时间也减少了

细节1:如何debug训练代码?

上面已经说了在命令行的启动命令:

xtuner train internlm_chat_7b_qlora_oasst1_e3_copy.py

如果我想在vscode去debug,应该怎么做?

xtuner是一个通过pip安装的Python包,并且它提供了一个命令行接口(CLI),但VSCode的调试器需要直接运行一个Python脚本而不是命令行命令,那么你需要找到xtuner的入口点脚本。通常,当一个Python包安装了命令行工具时,它会在Python的Scripts目录(Windows上)或bin目录(Unix-like系统上)中创建一个可执行文件。

第1步,通过which xtuner命令找到xtuner命令行工具的安装位置:"/opt/conda/envs/transformers2/bin/xtuner"

第2步,在VSCode的launch.json配置文件中,将program参数指向此脚本。示例如下:

{
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Python: Xtuner Training",
            "type": "python",
            "request": "launch",
            "cwd": "internlm_chat_7b_qlora_oasst1_e3_copy.py所在的工作目录"
            "program": "/opt/conda/envs/transformers2/bin/xtuner",
            "args": ["train", "internlm_chat_7b_qlora_oasst1_e3_copy.py"],
            "console": "integratedTerminal"
        }
    ]
}

第3步,运行debug。但是注意,VSCode中的调试配置config.json是依赖于当前打开的工作区的。

如果我想从头开始debug,想知道xtuner命令里面有什么过程,应该怎么办呢?

下面是xtuner文件(位于/opt/conda/envs/transformers2/bin/)的代码:

#!/opt/conda/envs/transformers2/bin/python3.9
# -*- coding: utf-8 -*-
import re
import sys
from xtuner import cli
if __name__ == '__main__':
    sys.argv[0] = re.sub(r'(-script\.pyw|\.exe)?

这个脚本是一个封装了 xtuner 库中的 cli 函数的命令行工具。这样的脚本通常是作为命令行界面的入口点,通过命令行执行 xtuner 命令来启动。

cli函数在哪里?第一种方法是,我需要去xtuner包所在的路径(/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner)去寻找。我发现该路径里有一个 entry_point.py 文件 ,通常,名为 entry_point.py 或类似的文件会作为包的主入口点,尤其是当这个包提供命令行工具时。

第二种方法比较简单,在xtuner文件里打断点,然后可以自动定位到cli函数所在的位置。(也不一定,我用这种方法去逐行调试,各种文件之间跳来跳去,把我跳晕了)

接着可以看到,函数调用了源码中的train.py,其路径为:

/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/tools/train.py

这个函数定义了训练的流程。

这个函数的第一步,是加载了配置文件,即internlm_chat_7b_qlora_oasst1_e3_copy.py

具体的训练流程,则是调用了runner.py(位于MMengine包里),在runner.py里的train函数里,真正执行了训练的流程。

(也就是说,整个流程的顺序是:xtuner--entry_point.py--train.py--runner.py)

位于/opt/conda/envs/transformers2/lib/python3.9/site-packages/mmengine/runner/runner.py中的train函数中的这行代码真正执行了训练的流程:

model = self.train_loop.run()

点进去run()的源码,可以看到它经过了封装:

def run(self) -> torch.nn.Module:
    """Launch training."""
    self.runner.call_hook('before_train')


    while self._epoch < self._max_epochs and not self.stop_training:
        self.run_epoch()


        self._decide_current_val_interval()
        if (self.runner.val_loop is not None
                and self._epoch >= self.val_begin
                and self._epoch % self.val_interval == 0):
            self.runner.val_loop.run()


    self.runner.call_hook('after_train')
    return self.runner.model


def run_epoch(self) -> None:
    """Iterate one epoch."""
    self.runner.call_hook('before_train_epoch')
    self.runner.model.train()
    for idx, data_batch in enumerate(self.dataloader):
        self.run_iter(idx, data_batch)


    self.runner.call_hook('after_train_epoch')
    self._epoch += 1


def run_iter(self, idx, data_batch: Sequence[dict]) -> None:
    """Iterate one min-batch.


    Args:
        data_batch (Sequence[dict]): Batch of data from dataloader.
    """
    self.runner.call_hook(
        'before_train_iter', batch_idx=idx, data_batch=data_batch)
    # Enable gradient accumulation mode and avoid unnecessary gradient
    # synchronization during gradient accumulation process.
    # outputs should be a dict of loss.
    outputs = self.runner.model.train_step(
        data_batch, optim_wrapper=self.runner.optim_wrapper)


    self.runner.call_hook(
        'after_train_iter',
        batch_idx=idx,
        data_batch=data_batch,
        outputs=outputs)
    self._iter += 1

细节2:如何从原始数据的格式转成huggingface中的dataset格式?

上面提到,微调的整个流程的顺序是:xtuner--entry_point.py--train.py--runner.py

runner.py中的train函数负责训练的具体流程。其中,这个函数里有一条代码:

self._train_loop = self.build_train_loop(self._train_loop)

这行代码的作用是加载数据,self.build_train_loop会跳到loops.py和base_loop.py里,但是最终又会跳回runner.py。

具体将json文件改成模型需要的格式的地方,位于runner.py中的build_dataloader函数。

首先,关于dataloader的配置是这样的:

{
  "batch_size": 1,
  "num_workers": 0,
  "dataset": {
    "type": "process_hf_dataset",
    "dataset": {
      "type": "load_dataset",
      "path": "./openassistant-guanaco"
    },
    "tokenizer": {
      "type": "from_pretrained",
      "pretrained_model_name_or_path": "/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm-chat-7b",
      "trust_remote_code": true,
      "padding_side": "right",
      "cache_dir": "/home/notebook/data/group/huggingface/Intern-models-dirs"
    },
    "max_length": 2048,
    "dataset_map_fn": "oasst1_map_fn",
    "template_map_fn": {
      "type": "template_map_fn_factory",
      "template": "internlm_chat"
    },
    "remove_unused_columns": true,
    "shuffle_before_pack": true,
    "pack_to_max_length": true
  },
  "sampler": {
    "type": "DefaultSampler",
    "shuffle": true
  },
  "collate_fn": {
    "type": "default_collate_fn"
  }
}

解释一些参数(下面的内容由GPT生成):

  • 'num_workers': 数值为0,指定在数据加载时用于数据预处理的工作进程数量。0通常意味着所有数据加载将在主进程中完成。
  • 'dataset': 这是一个嵌套的字典,包含训练数据集加载和处理的配置:
    • 'type': 可能是数据加载函数或类的名称,这里是 process_hf_dataset。
    • 'dataset': 包含数据集相关的配置,它本身又是一个嵌套字典:
      • 'type': 指数据集加载函数或类的名称,这里是 load_dataset。
      • 'path': 数据集的路径或名称,这里是 ./openassistant-guanaco。


    • 'tokenizer': 包含分词器(tokenizer)相关配置的字典,用于文本处理和编码:
      • 'type': 可能是加载分词器的函数或类的名称,这里是 from_pretrained。
      • 'pretrained_model_name_or_path': 预训练模型的名称或路径。
      • 'trust_remote_code': 布尔值,是否信任远程提供的代码。
      • 'padding_side': 字符串,指定填充的一侧,这里是 'right'。
      • 'cache_dir': 缓存目录的路径,用于存放下载或处理后的数据。


    • 'max_length': 数值为2048,指定处理后的文本序列的最大长度。
    • 'dataset_map_fn': 指定应用于数据集条目的映射函数的名称。
    • 'template_map_fn': 又是一个嵌套字典,相关于模版映射函数配置:
      • 'type': 映射函数或工厂函数的名称,这里是 template_map_fn_factory。
      • 'template': 应该是用于数据映射的模版名称。


    • 'remove_unused_columns': 布尔值,指定是否在数据集对象中移除不使用的列。
    • 'shuffle_before_pack': 布尔值,数据打包前是否进行随机混洗。
    • 'pack_to_max_length': 布尔值,指定是否将文本打包到最大长度限制。


  • 'sampler': 决定从数据集中抽样批次的方式:
    • 'type': 指定采样器的类或函数名称,这里是 DefaultSampler。
    • 'shuffle': 布尔值,指示在每个epoch开始时是否对索引进行随机混洗。


  • 'collate_fn': 在通过数据加载器(DataLoader)加载批次时用于合并单个数据条目的函数:

runner.py中的build_dataloader函数负责生成dataloader,生成dataloader的依据就是上面的关于dataloader的配置。此外,还有一些函数的调用,不在这里展开。

经过debug发现,位于/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/dataset/huggingface.py中的process函数负责加载数据。

在huggingface文件中,完成了从初始数据到dataset格式的转变,有以下几个关键步骤。

【关键步骤1】首先,下面这一行代码负责加载数据:

dataset = BUILDER.build(dataset)

加载出来的dataset如下:

DatasetDict({
    train: Dataset({
        features: ['text'],
        num_rows: 9846
    })
    test: Dataset({
        features: ['text'],
        num_rows: 518
    })
})

等价于

from datasets import load_dataset
datasets = load_dataset('openassistant_best_replies_train所在的路径文件夹')

openassistant_best_replies_train.jsonl数据本身的格式是{"text": "### Human:...### Assistant:..."},可以被load_dataset识别

【关键步骤2】dataset_map_fn映射。

作用:把初始数据文件中的{"text": "### Human:...### Assistant:..."}改成{"text": "### Human:...### Assistant:...","conversation":[{'input': '...', 'output': '...'}]}的格式。

下面这一行代码负责将dataset做格式变换,将dataset_map_fn函数应用到dataset数据集的每个样本上。

dataset = dataset.map(dataset_map_fn, num_proc=map_num_proc)

这里的dataset_map_fn=oasst1_map_fn,是在一开始的配置文件里定义好了的。

在源代码中的xtuner/dataset/map_fns/dataset_map_fns路径下,有十几个已经定义好了的内置的map方法,包括了一些著名的数据集,比如alpaca_map_fn.py

对了,debug的时候学到了一个小trick,如果我不知道某个函数的源代码,只知道函数名称,而且不想去源代码里找的话,可以试试
print(inspect.getsource(dataset_map_fn))
Python内置的inspect模块可以帮你检查源代码。

oasst1_map_fn函数的源码见附录,调试细节就不放出来了。我在linux上跑整个流程的时候,发现一直没有办法debug进去map里的函数。我在本地电脑单独把这部分代码拎出来,发现是可以debug进去的。暂时不知道是什么原因。

经过map后,数据的格式如下:

[{'input': 'Напиши функцию на яз...о на экран', 'output': 'Вот функция, которая...удь ещё? '}]

也就是说,这个dataset_map_fn步骤,把{"text": "### Human:...### Assistant:..."}改成{"text": "### Human:...### Assistant:...","conversation":[{'input': '...', 'output': '...'}]}的格式。

如果是多轮对话,则这个列表将会有多个字典,也就是说,这个列表的每个元素都是一次对话。

【关键步骤3】template_map_fn映射:

dataset = dataset.map(template_map_fn, num_proc=map_num_proc)

之前说到,送进模型的数据需要遵循一定的对话模板。在上一步骤中输出的对话格式并没有加入<|User|>这样指示角色名的信息,并不能直接输入到模型中。

在intern模型的这个版本中,模板如下所示:

{
    'template': {
        'SYSTEM': '<|System|>:{system}\n',
        'INSTRUCTION': '<|User|>:{input}<eoh>\n<|Bot|>:',
        'SUFFIX': '<eoa>',
        'SUFFIX_AS_EOS': True,
        'SEP': '\n',
        'STOP_WORDS': ['<eoa>']
    }
}
对了,这里的template_map_fn是一个functools.partial 对象 ,在Python中,functools.partial 对象本质上是一个类似函数的对象,但它并不是一个标准的函数或方法,也没有一个明确的代码对象 。
需要使用print(inspect.getsource(template_map_fn.func))来获取源码,而不是print(inspect.getsource(template_map_fn))

dataset_map_fn有多种,不同的数据集有不同的map方法。但是template_map_fn只有一个,因为intern模型只认一种对话模板。(当然自定义改成其他模板也可以,需要重新训练)

template_map_fn的源码路径是xtuner/dataset/map_fns/template_map_fn.py

template_map_fn函数的源代码见附录。调试细节就不放出来了,和关键步骤2一样,我单独拎出来在本地是可以debug的。

经过template_map_fn前:

原文配图


经过template_map_fn后:

原文配图


也就是说,本步骤的作用是加入诸如<|User|>这样指示角色名的信息。此外,还添加了'need_eos_token'和'sep'两个关键字

【关键步骤4】encode_fn映射(分词、编码):

dataset = dataset.map(
    partial(
        encode_fn,
        tokenizer=tokenizer,
        max_length=max_length,
        with_image_token=with_image_token,
        input_ids_with_output=input_ids_with_output),
    remove_columns=list(dataset.column_names)
    if remove_unused_columns else None,
    num_proc=map_num_proc)

在这里完成分词,从{"text": "### Human:...### Assistant:...","conversation":[{'input': '...', 'output': '...'}]}的格式改成模型能够理解的格式:{"input_ids": "..."."labels":"..."}

encode_fn函数位于xtuner/dataset/utils.py里,应该和template_map_fn一样,对于intern模型,只有这一个encode_fn函数。以下是该函数的docstring:

"""We only support the following three scenarios:


1. Incremental pretraining dataset.
    example['conversation'] = [
            {
                'input': '',
                'output': '### Human: Can you write xxx'
            }
        ]


2. Single-turn conversation dataset.
    example['conversation'] = [
            {
                'input': 'Give three tips for staying healthy.',
                'output': '1.Eat a balanced diet xxx'
            }
        ]


3. Multi-turn conversation dataset.
    example['conversation'] = [
            {
                'input': 'Give three tips for staying healthy.',
                'output': '1.Eat a balanced diet xxx'
            },
            {
                'input': 'Please expand on the second point.',
                'output': 'Here is an expanded explanation of the xxx'
            }
        ]
"""

可以看到,函数支持处理三种不同的对话数据集场景:增量预训练数据集、单轮对话数据集、多轮对话数据集。

intern模型分词器的基本信息如下:

vocab_size:103168
special_tokens={'bos_token': '<s>', 
'eos_token': '</s>', 
'unk_token': '<unk>', 
'pad_token': '</s>'}
tokenizer.bos_token_id:1
tokenizer.eos_token_id:2

encode_fn函数的源代码见附录。和关键步骤2/关键步骤3一样,我单独拎出来在本地是可以debug的。

encode_fn函数是对每个example的'conversation'来做处理,其中某个数据(第一条数据,也是俄文数据)的格式如下:

{'input': '<|User|>:Напиши функ...>\n<|Bot|>:', 
'need_eos_token': False,
'output': 'Вот функция, которая...щё?  <eoa>', 
'sep': '\n'}

接下来分析具体是如何分词的。

第(1)步:对问题(即俄文数据中的'input')分词

下面这行代码是对'input'来做分词,可以看到模板(比如<|User|>)也被分词了(当然,这是肯定的,因为所有的字符串都要经过分词,变成整数的格式)

input_encode = tokenizer.encode(input, add_special_tokens=False)

但是,<|User|>并没有被分词器视为一个整体,这一点还是比较奇怪的。而且<|User|>也没有被分词器视为特殊token。

举一个例子,当前的input是'<|User|>:Напиши функцию на языке swift, которая сортирует массив целых чисел, а затем выводит его на экран<eoh>\n<|Bot|>:'

其中'<|User|>:'经过分词后的结果是[333,352, 1621, 352,27232],占用了5个token,而不是1个token。'<|Bot|>:'也是一样,分词后的结果是[333, 352, 23845, 352, 27232]。这一点还是比较奇怪的。会不会是分词器的版本和模板的版本不匹配呢?

注意,还有一个细节,一般的分词器是直接调用tokenizer的call方法,call方法会返回attention_mask和token_type_ids,但是这里调用的是tokenizer.encode方法,只返回input_ids

第(2)步:在开头加入<s>对应分词后的结果

接着,在开头添加一个bos_token_id(bos_token_id就是<s>,分词后的结果是1),因为开头需要有一个表示begin的符号。

input_ids += bos_token_id
input_ids += input_encode

此时的input_ids=[1, 333, 352, 1621, 352, 27232, 98937, 98715, 98818, 98729, 99012, 98729, 262, 99089, ...]

其实可以先在开头加入<s>这个字符串,然后再分词。

这样的话会就变成对<s><|User|>:Напиши...来分词。可能这种方式会导致分词器错误分词?我做了实验,至少在当前版本的分词器下,不会导致错误分词。

注意,此时还没有结束。因为input_ids只有对问题的编码,还没有对答案的编码。为什么不一次性对问题和答案都编码?因为此时要先暂停一下来处理label。

第(3)步:先对label中不需要计算loss的部分用-100来占位

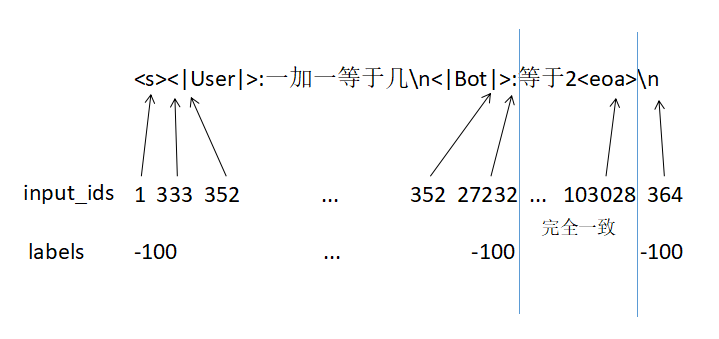
在PyTorch等深度学习框架中,一般使用交叉熵损失(Cross Entropy Loss)来训练拟合这类标签数据。在交叉熵损失中,-100作为默认的忽略索引(ignore index)。也就是说,只要某个位置的标签是-100,损失函数就会在计算过程中跳过这个位置,不会将它包括在损失计算之内。

这行代码创建了labels的前半部分。最后的+1,指的是开头加入的<s>的位置。

labels = []
labels += [-100] *(len(input_encode)+1)

截止到现在,已经完成了提问(或者说问题/prompt)部分的分词。而且此时,input_ids和labels的长度是一致的,都是105。

第(4)步:对回答完成类似第(1)(2)(3)的操作,拼接在input_ids和labels的后面。

此时,input_ids和labels的长度是一致的,都是564。

有一个小细节,<eoa>不像<|User|>,它对应的编码只有一个元素:103028

第(5)步(可选):增加eos_token_id

上面第(2)步提到,句子的最开头加入了bos_token_id。此时,在整个句子的最结尾,可以加入eos_token_id。这一部分是以if语句存在的,在本示例中,没有加入eos_token_id

第(6)步:加入sep符号

sep符号,即'\n',这并不是分词器的特殊符号,而是template_map_fn中传入的。

对于input_ids,在整个句子的最结尾,加入364,即'\n'经过编码后的数字

对于labels,在整个句子的最结尾,加入-100

此时,input_ids和labels的长度是一致的,都是565。

第(7)步:检查是否超过设定的长度,如果超过,则截断。

检查如果某条数据中label的所有的值都小于0,则舍去。

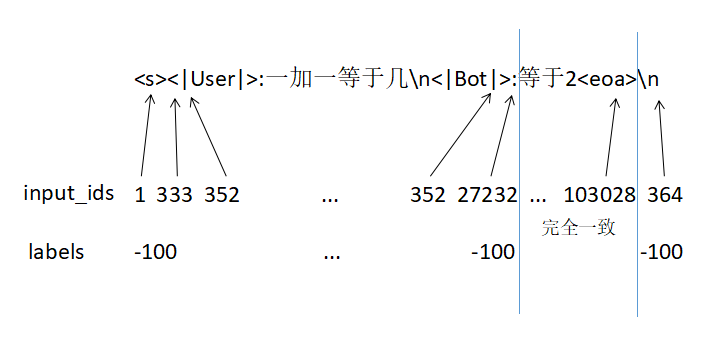
我画了一个图,总结经过分词后的格式:


原文配图


注意,<eoa>只是用来表示模型的一次回答的结束。至于\n,我没有明白这个符号的含义,感觉和<eoa>的作用重复了。

【关键步骤5】(可选)pack_to_max_length,即将不同的数据合并成一条数据

if shuffle_before_pack:
    dataset = dataset.shuffle()
    dataset = dataset.flatten_indices(num_proc=map_num_proc)
dataset = dataset.map(
    Packer(max_length), batched=True, num_proc=map_num_proc)

首先打乱数据,然后对索引重新编排。接着执行map函数和Packer映射。这里的batched=True,将会默认将1000个数据同时输入进去做处理,这样才方便将多条数据合并。

Packer的源代码和encode_fn函数一样,位于xtuner/dataset/utils.py里。

但是代码的逻辑是单纯地把不同的数据拼接在一起。比如设定的max_length=2048,第一条数据的长度是1000,第二条数据的长度是1000,第三条数据的长度是500。按照我的思路,应该是第一条和第二条数据合并在一起,然后第三条数据和后面的数据合并在一起。但是源码中的思路是,第一条数据+第二条数据+第三条数据的前48个token合并成一个数据。这样下来,基本上每条数据的长度都是2048。这样会造成一条数据被截断,划分成两条数据,合理吗?我觉得不太合理。

【总结】

以下的数据集的格式都是huggingface的datasets对象中的一条数据的格式

关键步骤1(加载数据集):

{"text": "### Human:...### Assistant:..."}

关键步骤2(解析提问和回答,以input和output的形式抽出来):

{"text": "### Human:...### Assistant:...",

"conversation":[{'input': '...', 'output': '...'}]}

关键步骤3(加入对话模板):

{"text": "### Human:...### Assistant:...",

"conversation":[

{'input': '<|User|>:...',

'need_eos_token':False,

'sep':'\n',

'output': '...'}]}

关键步骤4(经过分词器编码):

{'input_ids': [1, 333, 352, 1621, 352, 27232, 6863, 629, 3433, ...],

'labels': [-100, -100, -100, -100, -100, -100, -100, -100, -100, ...]}

附录1:加载数据的源码

这些源码在https://github.com/InternLM/xtuner都有,我把关键的部分拿出来整理到这里。

from datasets import load_dataset
#关键步骤1
datasets = load_dataset('timdettmers/openassistant-guanaco数据集所在的文件夹')
#关键步骤2
def oasst1_map_fn(example):
    data = []
    for sentence in example['text'].strip().split('###'):
        sentence = sentence.strip()
        if sentence[:6] == 'Human:':
            data.append(sentence[6:].strip())
        elif sentence[:10] == 'Assistant:':
            data.append(sentence[10:].strip())
    if len(data) % 2:
        # The last round of conversation solely consists of input
        # without any output.
        # Discard the input part of the last round, as this part is ignored in
        # the loss calculation.
        data.pop()
    conversation = []
    for i in range(0, len(data), 2):
        single_turn_conversation = {'input': data[i], 'output': data[i + 1]}
        conversation.append(single_turn_conversation)
    return {'conversation': conversation}
datasets = datasets.map(oasst1_map_fn)
datasets = datasets['train']


#关键步骤3
template={'SYSTEM': '<|System|>:{system}\n', 'INSTRUCTION': '<|User|>:{input}<eoh>\n<|Bot|>:', 'SUFFIX': '<eoa>', 'SUFFIX_AS_EOS': True, 'SEP': '\n', 'STOP_WORDS': ['<eoa>']}
def template_map_fn(example):
    print(1)
    conversation = example.get('conversation', [])
    for i, single_turn_conversation in enumerate(conversation):
        input = single_turn_conversation.get('input', '')
        if input is None:
            input = ''
        input_text = template['INSTRUCTION'].format(input=input, round=i + 1)
        system = single_turn_conversation.get('system', '')
        if system != '' and system is not None:
            system = template['SYSTEM'].format(system=system)
            input_text = system + input_text
        single_turn_conversation['input'] = input_text


        if template.get('SUFFIX', None):
            output_text = single_turn_conversation.get('output', '')
            output_text += template['SUFFIX']
            single_turn_conversation['output'] = output_text


        # SUFFIX_AS_EOS is False ==> need_eos_token is True
        single_turn_conversation['need_eos_token'] = \
            not template.get('SUFFIX_AS_EOS', False)
        single_turn_conversation['sep'] = template.get('SEP', '')


    return {'conversation': conversation}
datasets2 = datasets.map(template_map_fn)


#关键步骤4
IGNORE_INDEX = -100
DEFAULT_PAD_TOKEN_INDEX = 0
IMAGE_TOKEN_INDEX = -200
DEFAULT_IMAGE_TOKEN = '<image>'
import copy
def encode_fn(example,
              tokenizer,
              max_length,
              input_ids_with_output=True,
              with_image_token=False):
    print(1)
    if tokenizer.__class__.__name__ == 'QWenTokenizer':
        bos_token_id = []
        eos_token_id = tokenizer.eos_token_id
        assert eos_token_id is not None, \
            'Please set eos_token for Qwen tokenizer!'
    elif tokenizer.__class__.__name__ == 'ChatGLMTokenizer':
        bos_token_id = [64790, 64792]
        eos_token_id = tokenizer.eos_token_id
    else:
        bos_token_id = tokenizer.bos_token_id
        eos_token_id = tokenizer.eos_token_id
    if isinstance(bos_token_id, int):
        bos_token_id = [bos_token_id]
    if isinstance(eos_token_id, int):
        eos_token_id = [eos_token_id]
    is_multi_turn_conversation = len(example['conversation']) > 1
    if is_multi_turn_conversation:
        assert input_ids_with_output


    input_ids, labels = [], []
    next_needs_bos_token = True
    for single_turn_conversation in example['conversation']:
        input = single_turn_conversation['input']
        if DEFAULT_IMAGE_TOKEN in input and with_image_token:
            chunk_encode = [
                tokenizer.encode(chunk, add_special_tokens=False)
                for chunk in input.split('<image>')
            ]
            assert len(chunk_encode) == 2
            input_encode = []
            for idx, cur_chunk_encode in enumerate(chunk_encode):
                input_encode.extend(cur_chunk_encode)
                if idx != len(chunk_encode) - 1:
                    input_encode.append(IMAGE_TOKEN_INDEX)
        else:
            input_encode = tokenizer.encode(input, add_special_tokens=False)
        if next_needs_bos_token:
            input_ids += bos_token_id
            labels += [IGNORE_INDEX] * len(bos_token_id)
        input_ids += input_encode
        labels += [IGNORE_INDEX] * len(input_encode)
        if input_ids_with_output:
            # Add output (with loss)
            output = single_turn_conversation['output']
            output_encode = tokenizer.encode(output, add_special_tokens=False)
            input_ids += output_encode
            labels += copy.deepcopy(output_encode)
            # Add EOS_TOKEN (with loss)
            if single_turn_conversation['need_eos_token']:
                next_needs_bos_token = True
                input_ids += eos_token_id
                labels += copy.deepcopy(eos_token_id)
            else:
                next_needs_bos_token = False
            # Add SEP (without loss)
            sep = single_turn_conversation['sep']
            if sep != '':
                sep_encode = tokenizer.encode(sep, add_special_tokens=False)
                input_ids += sep_encode
                labels += [IGNORE_INDEX] * len(sep_encode)


    if len(input_ids) > max_length:
        input_ids = input_ids[:max_length]
        labels = labels[:max_length]
    return {'input_ids': input_ids, 'labels': labels}


max_length=2048
with_image_token=False
input_ids_with_output=True
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("internlm-chat-7b/",trust_remote_code=True)
from functools import partial
datasets3 = datasets2.map(
    partial(
        encode_fn,
        tokenizer=tokenizer,
        max_length=max_length,
        with_image_token=with_image_token,
        input_ids_with_output=input_ids_with_output),
    remove_columns=list(datasets2.column_names))


#关键步骤5
from itertools import chain
class Packer:
    # modified from
    # https://github.com/facebookresearch/llama-recipes/blob/main/ft_datasets/utils.py
    def __init__(self, chunk_size=2048):
        self.chunk_size = chunk_size
        self.residual = {'input_ids': [], 'labels': []}


    def __call__(self, batch):
        concatenated_samples = {
            k: v + list(chain(*batch[k]))
            for k, v in self.residual.items()
        }
        print(1)
        total_length = len(concatenated_samples[list(
            concatenated_samples.keys())[0]])


        if total_length >= self.chunk_size:
            chunk_num = total_length // self.chunk_size
            result = {
                k: [
                    v[i:i + self.chunk_size]
                    for i in range(0, chunk_num *
                                   self.chunk_size, self.chunk_size)
                ]
                for k, v in concatenated_samples.items()
            }
            self.residual = {
                k: v[(chunk_num * self.chunk_size):]
                for k, v in concatenated_samples.items()
            }
        else:
            result = {k: [v] for k, v in concatenated_samples.items()}
            self.residual = {k: [] for k in concatenated_samples.keys()}


        return result


max_length=2048
datasets4 = datasets3.map(
            Packer(max_length), batched=True)

细节3:如何从dataset格式转变到Dataloder?

上面已经获得了huggingface格式的dataset,原则来说,使用 Trainer 时,你可以将 datasets 库中的 Dataset 对象直接作为数据集参数传递给 Trainer。Trainer 类在内部会自动处理数据加载和迭代的细节,包括将 Dataset 转换为 DataLoader。不必显式创建一个 DataLoader,因为Trainer 会根据 Trainer 的参数和 Dataset 的特性来自动创建一个合适的 DataLoader。

但是在本示例中,还是选择手动定义了一个DataLoader。定义DataLoader的代码仍然在/opt/conda/envs/transformers2/lib/python3.9/site-packages/mmengine/runner/runner.py中

data_loader = DataLoader(
    dataset=dataset,
    sampler=sampler if batch_sampler is None else None,
    batch_sampler=batch_sampler,
    collate_fn=collate_fn,
    worker_init_fn=init_fn,
    **dataloader_cfg)

这段代码创建了一个 DataLoader 对象,它是PyTorch中使用的一个非常重要的类,用于高效地加载数据,可以在多线程环境下工作,常见于机器学习和深度学习模型的训练过程中。

下面是代码的参数解释:

  1. dataset: 这是要加载的数据集。在PyTorch中,dataset 通常是一个实现了 __getitem__ 和 __len__ 方法的对象。
  2. sampler: 这个参数定义了从数据集中抽取样本的策略。它能够控制数据加载的顺序等。如果 batch_sampler 被定义,则 sampler 应该为 None,因为 batch_sampler 与 sampler 是互斥的,batch_sampler 直接定义了批量数据的取样方式。
  3. batch_sampler: 这是一个迭代器,用于指定每个批次中哪些索引的数据将被加载。一旦设置了 batch_sampler,则将忽略 sampler 参数。
  4. collate_fn: 当需要将多个数据样本组合成一个批次时,collate_fn 被用来定义如何将这些样本合并。通常,它接收一个样本列表并返回一个批次。如果没有提供 collate_fn,DataLoader 将使用默认的方式将数据组合成批次。
  5. worker_init_fn: 这是一个函数,用于初始化每个工作进程。这可以用于设置在使用多进程加载数据时每个工作进程的随机种子,以确保数据加载顺序的随机化。
  6. **dataloader_cfg: 这个语法表示以字典的形式传递可变数量的关键字参数。dataloader_cfg 是一个字典,包括了 DataLoader 的其他配置选项,如 batch_size(每批次加载的样本数量)、shuffle(是否随机打乱数据)、num_workers(加载数据时使用的进程数量)等。

collate_fn函数的源码位于/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/dataset/collate_fns/defalut_collate_fn.py里

经过DataLoader后,数据的格式长这样:

{'data':

{'input_ids': tensor([[ 265, 539, 2632, ..., 36333, 328, 454]]),

'attention_mask': tensor([[True, True, True, ..., True, True, True]]),

'labels': tensor([[ 265, 539, 2632, ..., 36333, 328, 454]])},

'data_samples': None}

input_ids/attention_mask/labels的shape都是torch.Size([1, 2048])

这里的attention_mask全部是True,因为pack_to_max_length这个步骤,将大部分数据都强行拼凑成2048长度。

训练流程——第四步:将PTH模型转huggingface模型

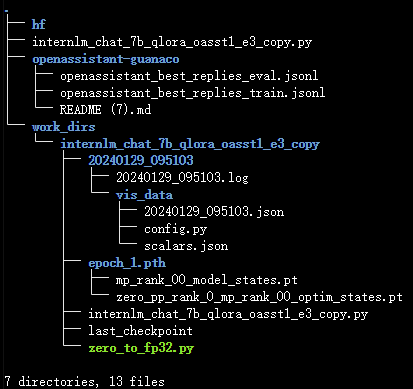
训练好的文件保存在work_dirs路径下。首先查看work_dirs目录的路径结构:


原文配图


可以看到每一个epoch都会生成一个pth文件。但是我在实际跑了后发现,我这边生成的pth其实是一个文件夹:


原文配图


目前得到的是pth文件(夹),还不能直接用于推理,需要转成huggingface的模型。转换的命令是:

mkdir hf
export MKL_SERVICE_FORCE_INTEL=1
xtuner convert pth_to_hf ./internlm_chat_7b_qlora_oasst1_e3_copy.py ./work_dirs/internlm_chat_7b_qlora_oasst1_e3_copy/epoch_1.pth ./hf

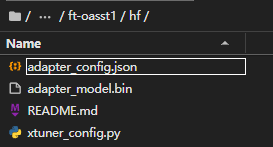
转换后,hf文件夹里出现了四个文件:

原文配图


可以这样简单理解:LoRA 模型文件 = Adapter

细节4:转换模型的流程

接下来探究一个细节:模型是如何转换的?接下来debug一下背后的流程。

首先根据命令行的参数,修改launch.json

{
    // Use IntelliSense to learn about possible attributes.
    // Hover to view descriptions of existing attributes.
    // For more information, visit: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Python: xtuner",
            "type": "python",
            "request": "launch",
            // "module": "xtuner",
            "program": "/opt/conda/envs/transformers2/bin/xtuner",
            "console": "integratedTerminal",
            "justMyCode": false,
            "args": [
                "convert",
                "pth_to_hf",
                "internlm_chat_7b_qlora_oasst1_e3_copy.py",
                "./work_dirs/internlm_chat_7b_qlora_oasst1_e3_copy/epoch_1.pth",
                "./hf"
            ],
             "cwd": "/home/notebook/code/personal//aigc/intern/xtuner-main/ft-oasst1/"
        }
    ]
}

经过断点测试,可以发现在/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/entry_point.py中的subprocess.run(['python', fn()] + args[n_arg + 1:])

这一行代码中,发现它实际调用了'/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/tools/model_converters/pth_to_hf.py'

于是去pth_to_hf.py函数里打断点,发现以下几个关键步骤。

【关键步骤1】加载模型

model = BUILDER.build(cfg.model)

以"load_in_4bit": true来加载模型,加载的模型是原模型,即Shanghai_AI_Laboratory/internlm-chat-7b

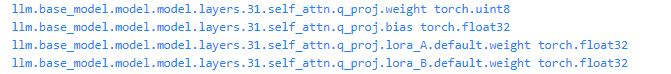
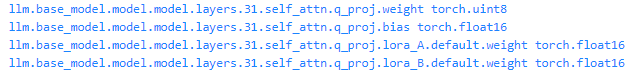
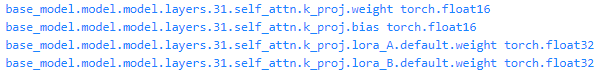
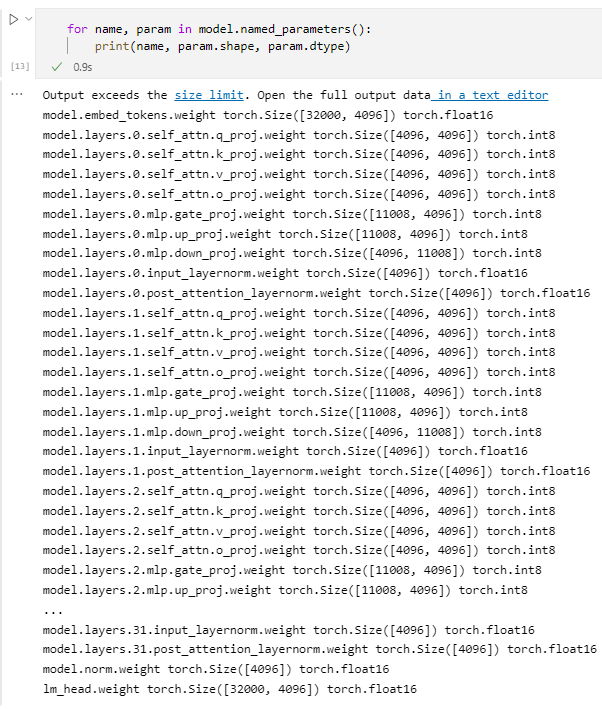
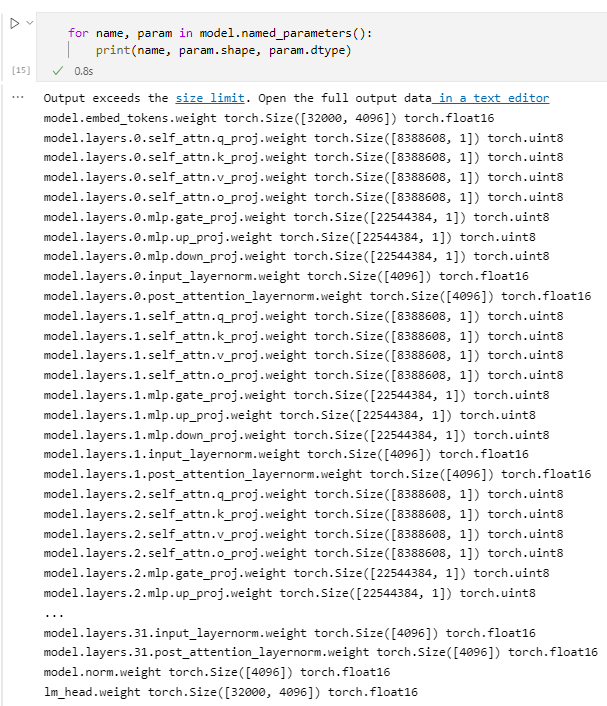
按道理来说7b模型,如果以4bit来加载,显存占用应该是只有3.5G左右。但是实际占用的显存达到9G。可能有如下几个原因:(1)只有对weight进行了4bit量化,bias仍然是float32格式。(2)lora部分未经过量化,是以float32格式呈现的。

通过以下命令,查询每一层的dtype:

for i,j in model.named_parameters():
    print(i,j.dtype)

截取其中部分结果:


原文配图


那么为什么要加载原模型呢?根据命令的参数,发现它只用到了workdirs里面的pth文件。

【关键步骤2】加载pth文件

state_dict = guess_load_checkpoint(args.pth_model)

state_dict是一个OrderedDict对象,里面包含了所有lora的参数(层的名称+具体的参数值)。也就是说,之前微调保存的pth文件,其实保存的是所有的lora参数。这里发现这些参数都是float32的格式。经过简单的统计,发现一共有159907840参数,占总参数量的2%左右。这个占比还是挺高的,我看到q/k/v/o/h_to_4h/4h_to_h里都插入了lora矩阵(target_modules: ['k_proj', 'o_proj', 'q_proj', 'v_proj', 'up_proj', 'down_proj', 'gate_proj'])。

【关键步骤3】将pth文件中的参数覆盖到model里

model.load_state_dict(state_dict, strict=False)

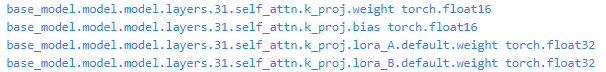
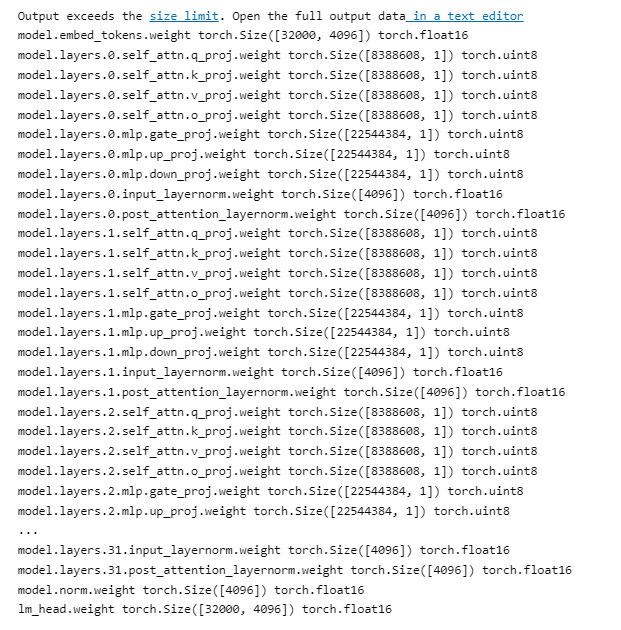
【关键步骤4】转成float16的格式

model.llm.half()

截取其中部分结果:


原文配图


注意,这里只是把之前为fp32格式的参数转成了fp16,之前是4bit格式的参数,并未转成fp16

【关键步骤5】保存模型

model.llm.save_pretrained(llm_path, max_shard_size=args.max_shard_size)

注意,这里的save_pretrained方法,是peft的save_pretrained方法。在这个方法中,有这么一步:

output_state_dict = get_peft_model_state_dict(
                self, state_dict=kwargs.get("state_dict", None), adapter_name=adapter_name
            )

这行代码是用来获得整个model中的lora参数的state_dict

然后在下面这行代码中保存了lora的参数,保存的文件名称是adapter_model.bin

torch.save(output_state_dict, os.path.join(output_dir, WEIGHTS_NAME))

总结一下,首先加载整个模型,然后加载之前保存的包含lora的pth文件,将参数覆盖到model模型里。接着将模型转成fp16的格式。最后,将model的lora权重抽出来,进行保存。

我感觉这是不是绕了一个圈呢?可不可以不加载model模型呢?在上面的流程中,lora参数先是被覆盖到model里,后来又从model中抽出lora参数,是不是多此一举呢?

不过我还是发现了一些区别,比如pth文件保存的格式是float32,这里保存的adapter是float16格式,文件大小是319,977,674,大约是lora参数量159,907,840的两倍。

也就是说,在这个convert步骤里,通过pytorch层面的load_state_dict,fp32格式存储的pth文件被转成了fp16格式存储的adapter_model.bin文件。不论是pth文件还是bin文件,都是通过torch.save/torch.load来直接保存和加载的,还没有涉及到PEFT库的内容。

训练流程——第五步:模型合并

经过了pth转hf,目前只生成了adapter,还没有合并模型,即没有将lora旁路合并到主模型上。下面的代码将会将adapter合并到模型中:

mkdir merged
xtuner convert merge /home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm-chat-7b ./hf ./merged --max-shard-size 2GB

第一个参数是basemodel所在的路径

第二个参数是转换成hf格式后所在的路径

第三个参数是转换后的路径

第四个参数是每个文件最大的大小

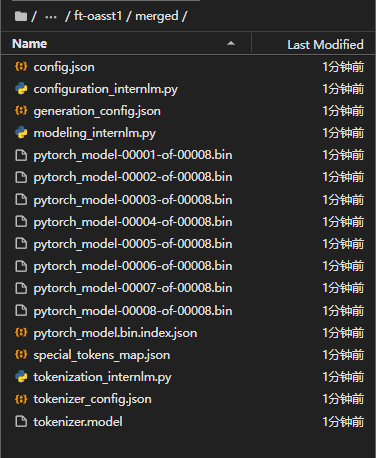
转换成功后,看到mergerd文件夹下有如下文件:


原文配图


8个bin文件加起来不到16G?为什么7B的模型,占用的存储不是28G,而是16G?难道是以float16存储的?是的,在model.config里可以看到模型参数是float16的格式。

细节5:合并模型的流程

首先根据命令行的参数,修改launch.json

{
    // Use IntelliSense to learn about possible attributes.
    // Hover to view descriptions of existing attributes.
    // For more information, visit: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Python: xtuner",
            "type": "python",
            "request": "launch",
            // "module": "xtuner",
            "program": "/opt/conda/envs/transformers2/bin/xtuner",
            "console": "integratedTerminal",
            "justMyCode": false,
            "args": [
                "convert",
                "merge",
                "/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm-chat-7b",
                "./hf",
                "./merged",
                "--max-shard-size","2GB"
            ],
             "cwd": "/home/notebook/code/personal/aigc/intern/xtuner-main/ft-oasst1/"
        }
    ]
}

可以看到调用了 '/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/tools/model_converters/merge.py'

于是去merge.py里打断点,发现以下几个关键步骤。

【关键步骤1】加载模型

model = AutoModelForCausalLM.from_pretrained(
    args.model_name_or_path,
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True,
    device_map=args.device,
    trust_remote_code=True)

以float16来加载原模型(因为adapter是以fp16来存储的),加载后,GPU显存大约是14.3G,差不多是参数量的两倍。

截取其中部分结果:


原文配图


可以看到,此时的模型是没有lora参数的,而且模型的参数是float16的格式。

当然同时也加载了分词器:

processor = AutoTokenizer.from_pretrained(
            args.model_name_or_path, trust_remote_code=True)

这里加载分词器倒不是说合并模型的时候需要用到分词器,而是把分词器一起保存到合并后的模型的保存路径,方便后面一起调用。

【关键步骤2】加载adapter(本步骤涉及对PEFT源码的探索)

model_unmerged = PeftModel.from_pretrained(
    model,
    args.adapter_name_or_path,
    device_map=args.device,
    is_trainable=False,
    trust_remote_code=True)

使用PeftModel.from_pretrained来加载adapter。注意到有一个参数是model(以fp16格式加载的还没有lora的model),也就是说,加载lora参数的时候,不能脱离model。

点进去这个源码(位于/opt/conda/envs/transformers2/lib/python3.9/site-packages/peft/peft_model.py,这是PEFT库的代码),发现有两行代码比较关键:

model = MODEL_TYPE_TO_PEFT_MODEL_MAPPING[config.task_type](
model, config, adapter_name)
model.load_adapter(model_id, adapter_name, is_trainable=is_trainable, **kwargs)

【关键步骤2.1】首先解释第一行代码:model = MODEL_TYPE_TO_PEFT_MODEL_MAPPING[config.task_type](

model, config, adapter_name)

其中MODEL_TYPE_TO_PEFT_MODEL_MAPPING[config.task_type]指向了<class 'peft.peft_model.PeftModelForCausalLM'>这个类,这个类的源码也是在peft_model.py里。

传入的参数除了model,还有两个,其中config的内容是:

LoraConfig(peft_type='LORA', auto_mapping=None, base_model_name_or_path='/home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm-chat-7b', revision=None, task_type='CAUSAL_LM', inference_mode=True, r=64, target_modules=['k_proj', 'o_proj', 'q_proj', 'v_proj', 'up_proj', 'down_proj', 'gate_proj'], lora_alpha=16, lora_dropout=0.1, fan_in_fan_out=False, bias='none', modules_to_save=None, init_lora_weights=True, layers_to_transform=None, layers_pattern=None)

这里的config准确识别到了在微调阶段时用的lora参数是什么,我暂时没有弄明白它是在哪个环节识别到的。

最后一个参数adapter_name的内容是"default"

再回顾下,传入的三个参数分别是model/config/adapter_name。

这行代码是什么意思呢?就是定义了一个PeftModelForCausalLM类的实例,这个实例的名称是model。产生一个PeftModelForCausalLM类的实例,自然要经过PeftModelForCausalLM的__init__方法。由于PeftModelForCausalLM继承于PeftModel类,因此需要经过PeftModel类的__init__方法。在__init__方法中,有一行代码是:

self.base_model = PEFT_TYPE_TO_MODEL_MAPPING[peft_config.peft_type](
                self.base_model, self.peft_config, adapter_name)

其中PEFT_TYPE_TO_MODEL_MAPPING[peft_config.peft_type]指向了<class 'peft.tuners.lora.LoraModel'>这个类,这一行的代码的意思是产生了一个LoraModel类的实例,这个实例的名称叫做self.base_model,这里的self.base_model在原模型model的基础上,新增并初始化了lora旁路。

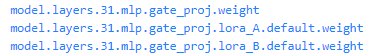
self.base_model的部分层如下所示:


原文配图


进一步打印参数的话(如使用self.model.model.layers[31].mlp.down_proj.lora_B.default.weight命令),可以看到lora_B的所有参数都是0

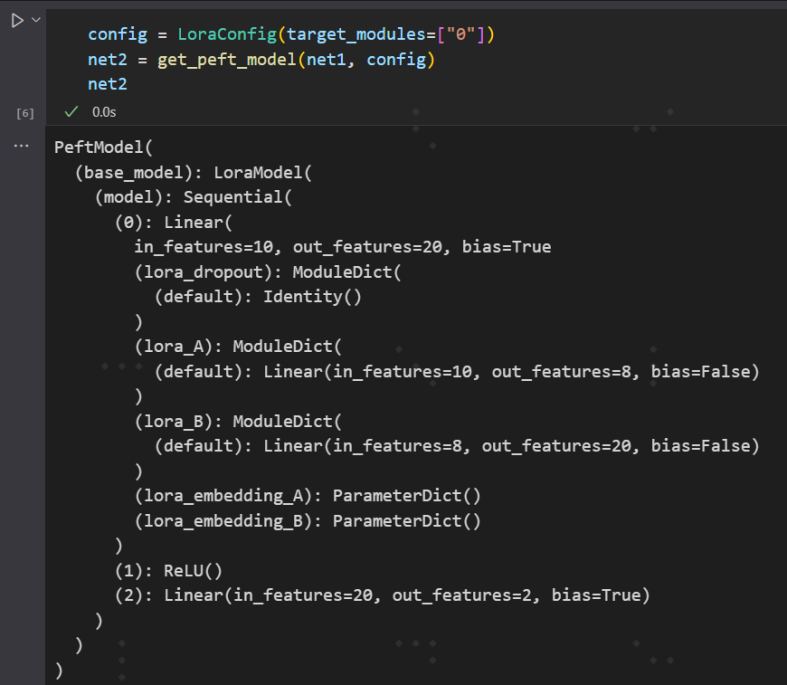
总结一下:PeftModel类的初始化方法的作用,是给原模型添加adapter,如果peft的类型是lora,那么添加的adapter是lora旁路。添加的旁路的参数是根据一定规则初始化的。

给原模型添加adapter的过程还是比较耗时的,里面的_find_and_replace方法比较复杂,我暂时没有看懂。

还有一个需要注意的点是,此时模型的总参数量是7481856000,比初始的参数量7321948160多159907840,这正是lora部分的参数量。

【关键步骤2.2】然后解释第二行代码:model.load_adapter(model_id, adapter_name, is_trainable=is_trainable, **kwargs)

在经过了关键步骤2.1的第一行代码后,模型里面有lora旁路和参数了,截取模型部分层如下图所示:


原文配图


此时的lora参数的数据类型是float32。

关键步骤2.2做的是加载adapter[通过torch.load('./hf/adapter_model.bin')命令],把里面的参数覆盖到model里(通过model.load_state_dict命令)。

总结一下,整个关键步骤2,首先将原模型添加了lora旁路,此时lora旁路的参数是随机或者全0初始化的。然后加载adapter,将lora参数覆盖到model里。

截取模型部分层如下图所示:


原文配图


模型的总参数量是7481856000

【关键步骤3】合并adapter和model(本步骤涉及对PEFT源码的探索)

model_merged = model_unmerged.merge_and_unload()

这个函数的源码位于/opt/conda/envs/transformers2/lib/python3.9/site-packages/peft/tuners/lora.py

从源码的位置可以看出合并部分的代码并不是xtuner写的,而是PEFT库官方提供的。

这个步骤主要是将lora的参数merge到主路里。经过了关键步骤2,可以看到lora的参数仍然是以旁路而存在的。经过了这个步骤,发现模型的总参数量回到了7321948160,而且所有参数的类型都是float16。

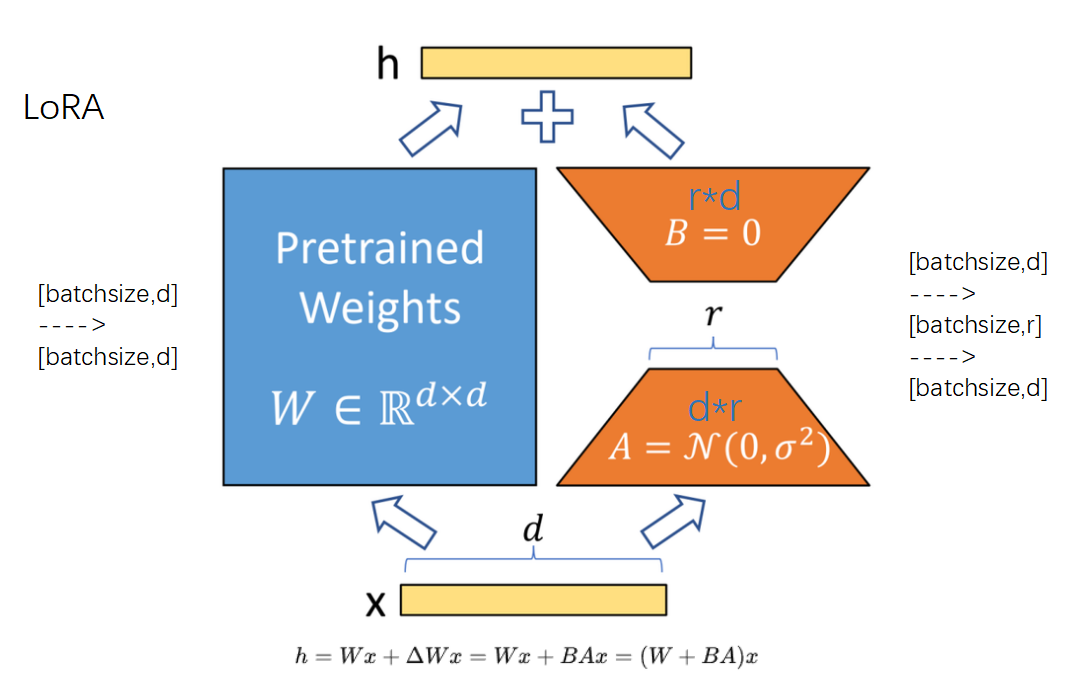
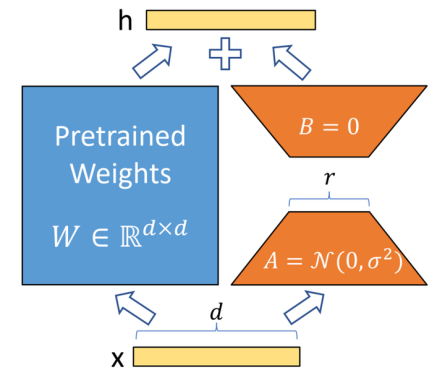
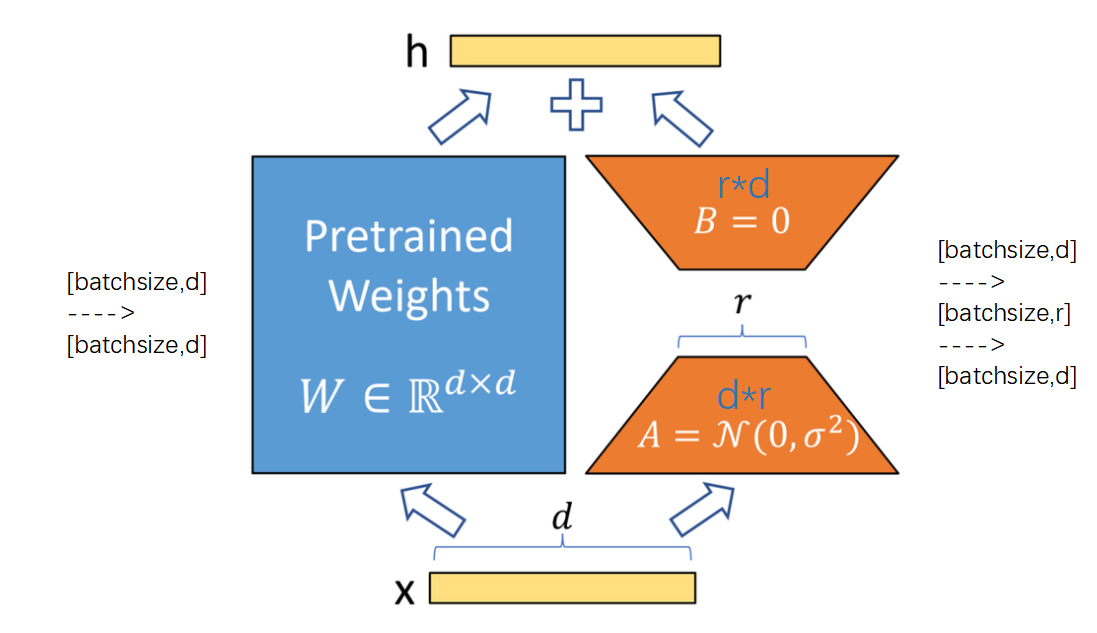
那具体是怎么合入的呢?lora的原理是,在主路旁边加一个旁路,即y=Wx+(BA)x,其中W和BA是同shape的,是可以加在一起的。

首先查看self.model.named_modules(),以下是截取的部分信息:

model.layers.31
model.layers.31.self_attn
model.layers.31.self_attn.q_proj
model.layers.31.self_attn.q_proj.lora_dropout
model.layers.31.self_attn.q_proj.lora_dropout.default
model.layers.31.self_attn.q_proj.lora_A
model.layers.31.self_attn.q_proj.lora_A.default
model.layers.31.self_attn.q_proj.lora_B
model.layers.31.self_attn.q_proj.lora_B.default
model.layers.31.self_attn.q_proj.lora_embedding_A
model.layers.31.self_attn.q_proj.lora_embedding_B
model.layers.31.self_attn.k_proj

然后依次对每一层来执行merge操作。具体来说,举个例子,当前的层是'model.layers.0.self_attn.q_proj',这表示第1层的q矩阵,结构如下:

Linear(
  in_features=4096, out_features=4096, bias=True
  (lora_dropout): ModuleDict(
    (default): Dropout(p=0.1, inplace=False)
  )
  (lora_A): ModuleDict(
    (default): Linear(in_features=4096, out_features=64, bias=False)
  )
  (lora_B): ModuleDict(
    (default): Linear(in_features=64, out_features=4096, bias=False)
  )
  (lora_embedding_A): ParameterDict()
  (lora_embedding_B): ParameterDict()
)

我们的目标是将所有的lora参数(A矩阵:64*4096,B矩阵:4096*64)都merge到4096*4096的主路上。

原文配图


对应到代码里的操作是:

self.weight.data -= (self.lora_B[adapter].weight @ self.lora_A[adapter].weight)* self.scaling[adapter]

self.weight.data是主路的权重,shape是4096*4096,这里用的是减号,按照lora的论文,应该是加号。但是加号减号没有本质区别。self.scaling[adapter]代表的是lora旁路的权重因子,这里是0.25。

self.lora_B[adapter].weight代表是B矩阵的权重,shape=4096*64,self.lora_A[adapter].weight)代表是A矩阵的权重,shape=64*4096。

注意,输入x的shape是batchsize*4096,其中4096是hiddensize。首先x这个batch中的每条数据和A矩阵(shape=64*4096)相乘,得到shape=batchsize*64的中间激活层y。这个过程也等价于x@A',A'是A的转置。

然后同理,y@B',得到shape=batchsize*4096的输出。

两个过程可以整合在一起:x@A'@B'=x(BA)'。

注意:在pytorch中,输入x经过一个(in=64,out=4096)的线性层,这个线性层的参数矩阵W其实是以4096*64的shape来存储,然后在实际执行线性层运算的时候,是x@W’,其中W'是W的转置。在PyTorch中,线性层(通常表示为nn.Linear)的权重张量的存储格式是以[out_features, in_features]为形状来存储的。当执行线性变换时,实际上进行的操作是输入矩阵x(形状为[batch_size, in_features])和权重矩阵W的转置的矩阵乘法。

经过合并后,'model.layers.0.self_attn.q_proj'的结构如下所示:

Linear(in_features=4096, out_features=4096, bias=True)

【关键步骤4】保存合并后的模型和分词器

model_merged.save_pretrained(
    args.save_dir,
    safe_serialization=False,
    max_shard_size=args.max_shard_size)
processor.save_pretrained(args.save_dir)

训练流程——第六步:用合并后的模型来推理

经过训练后,保存的merge模型就是一个标准的huggingface的模型。

直接从merge路径加载即可:

model = AutoModelForCausalLM.from_pretrained("/home/notebook/code/personal/aigc/intern/xtuner-main/ft-oasst1/merged", 
device_map="auto",trust_remote_code=True)

当然也可以使用xtuner的chat来推理模型:

xtuner chat ./merged --prompt-template internlm_chat

prompt-template 指的是:基于哪个底座模型调的,就需要写对应的模型。因为不同的模型,chat的模板是不一样的。

可选集合: --prompt-template {default,zephyr,internlm_chat,internlm2_chat,moss_sft,llama2_chat,code_llama_chat,chatglm2,chatglm3,qwen_chat,baichuan_chat,baichuan2_chat,wizardlm,wizardcoder,vicuna,deepseek_coder,deepseekcoder,deepseek_moe,mistral,mixtral}

这里也能看出internlm_chat和internlm2_chat分别有一套自己的模板。

在调用xtuner的chat来推理的时候,注意要敲两次回车键来完成输入。

上面的命令默认是以float16来加载模型的

也可以以4bit来加载模型:

xtuner chat ./merged --bits 4 --prompt-template internlm_chat

细节6:推理的流程

首先根据命令行的参数,修改launch.json

{
    // Use IntelliSense to learn about possible attributes.
    // Hover to view descriptions of existing attributes.
    // For more information, visit: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Python: xtuner",
            "type": "python",
            "request": "launch",
            // "module": "xtuner",
            "program": "/opt/conda/envs/transformers2/bin/xtuner",
            "console": "integratedTerminal",
            "justMyCode": false,
            "args": [
                "chat",
                "./merged",
                "--prompt-template",
                "internlm_chat",
            ],
             "cwd": "/home/notebook/code/personal/aigc/intern/xtuner-main/ft-oasst1/"
        }
    ]
}

可以看到调用了'/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/tools/chat.py',于是进去chat.py里打断点。

首先加载了一些参数:

Namespace(model_name_or_path='./merged', adapter=None, llava=None, visual_encoder=None, visual_select_layer=-2, image=None, torch_dtype='fp16', prompt_template='internlm_chat', system=None, system_template=None, bits=None, bot_name='BOT', with_plugins=None, no_streamer=False, lagent=False, stop_words=[], offload_folder=None, max_new_tokens=2048, temperature=0.1, top_k=40, top_p=0.75, seed=0)

可以看到temperature=0.1,输出的结果比较稳定,倾向于往概率大的token预测。

system=None表示的是没有注入system prompt。

接下来分解几个关键步骤。

【关键步骤1】加载模型和分词器(位于merged路径),默认以fp16格式加载模型

llm = AutoModelForCausalLM.from_pretrained(......)
tokenizer = AutoTokenizer.from_pretrained(......)
llm.eval()

【关键步骤2】接受输入数据

比如text='爱情让人着迷吗?'

【关键步骤3】加载对话模板,并且将内容套进模板里

在本例子中的对话模板是:

{'SYSTEM': '<|System|>:{system}\n', 'INSTRUCTION': '<|User|>:{input}<eoh>\n<|Bot|>:', 'SUFFIX': '<eoa>', 'SUFFIX_AS_EOS': True, 'SEP': '\n', 'STOP_WORDS': ['<eoa>']}

那么inputs就变成了:'<|User|>:爱情让人着迷吗?<eoh>\n<|Bot|>:'

【关键步骤4】对inputs分词

ids = tokenizer.encode(inputs, return_tensors='pt', add_special_tokens=False)

ids:

tensor([[     1,    333,    352,   1621,    352,  27232,  68099,  68108,  60477,
          61472,  61056,  99050, 103027,    364,    333,    352,  23845,    352,
          27232]])

【关键步骤5】生成回答

generate_output = llm.generate(
    inputs=ids.cuda(),
    generation_config=gen_config,
    streamer=streamer,
    stopping_criteria=stop_criteria)

generate_output是什么?打印tokenizer.decode(generate_output[0])出来看看:

' <s><|User|>:爱情让人着迷吗?<eoh>\n<|Bot|>:爱情是一种非常复杂的情感,它可以让人们感到兴奋、幸福、满足和快乐,也可以让人感到痛苦、失落、沮丧和孤独。爱情可以让人着迷,因为它可以带来强烈的情感体验和满足感,但同时也会带来一些负面影响,如焦虑、压力、嫉妒和控制欲等。因此,爱情是一种非常个人化的体验,每个人对它的感受和反应都可能不同。<eoa>'

可以看到它包括了之前的提问。

如果len(generate_output[0])超出了设定的最大长度(比如这里是2048),那么对话历史会被清空,即对话被强制重来。因为模型最多支持2048个token长度的输入。

【关键步骤6】第二轮对话

开启第二轮对话的流程,只是在原来的output的基础上再添加新的内容,然后再跑一遍上面的流程。

比如我追问了一个问题:获得爱情,最重要的特质是什么?

此时的inputs:

' <s><|User|>:爱情让人着迷吗?<eoh>\n<|Bot|>:爱情是一种非常复杂的情感,它可以让人们感到兴奋、幸福、满足和快乐,也可以让人感到痛苦、失落、沮丧和孤独。爱情可以让人着迷,因为它可以带来强烈的情感体验和满足感,但同时也会带来一些负面影响,如焦虑、压力、嫉妒和控制欲等。因此,爱情是一种非常个人化的体验,每个人对它的感受和反应都可能不同。<eoa>\n<|User|>:获得爱情,最重要的特质是什么?<eoh>\n<|Bot|>:'

注意,在第一轮对话的结束,除了<eoa>,还有\n符号。\n符号的作用我暂时也没有弄明白,它出现在<eoh>和<eoa>的后面。

【其他细节】

如果是以4bit加载模型的话,需要在launch.json中增加一个参数:--bits 4

在源码中,以这样的配置去加载4bit模型:

quantization_config = BitsAndBytesConfig(
    load_in_4bit=True,
    load_in_8bit=False,
    llm_int8_threshold=6.0,
    llm_int8_has_fp16_weight=False,
    bnb_4bit_compute_dtype=torch.float16,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type='nf4')

用4bit去加载模型的目的,应该是为了加快推理速度,减少显存占用(但是4bit是没有办法直接运算的,想要计算,仍然得先反量化到fp16,那么4bit加载有什么用呢?而且反量化的过程应该也会耗费时间)。

加载好模型后,发现显存占用是5.8G。打印model的所有层的dtype发现,weight 都是uint8格式(应该是两个nf4格式的数凑成了一个uint8格式的数),bias/layernorm/embedding都是float16格式。至于为什么weights和bias的格式不一致,我暂时也不知道。但是此时肯定是没有主模型和lora旁路之分了,因为加载的是已经merge好的模型。

在实际跑模型推理的时候,发现显存占用并不高,大约是6G多。

细节7:关于model.generate

在/opt/conda/envs/transformers2/lib/python3.9/site-packages/xtuner/tools/chat.py的源码中,调用了generate方法来产生回答,传入的参数是:

GenerationConfig {
  "do_sample": true,
  "eos_token_id": 2,
  "max_new_tokens": 2048,
  "pad_token_id": 2,
  "temperature": 0.1,
  "top_k": 40,
  "top_p": 0.75
}

transformers库中,在generate方法中,如果传入的参数 do_sample=True,那么生成模式是GenerationMode.SAMPLE,此时会用到top_k/temperature等参数。

当使用 Beam Search 时,通过 num_beams 参数设置 Beam 的大小(宽度),你可以让模型在每一步考虑多个最有可能的序列。相对应地,当你使用 Sampling 时,可以通过 do_sample=True 来为生成过程添加随机性。同时,Beam Search 和 Sampling 是两种不同的生成策略,通常不会被组合在一起使用,因为 Beam Search 本质上是一种确定性的方法,而 Sampling 引入了随机性。

【关键步骤1】前向传播

在generate方法的源码中,首先把输入通过前向传播,得到output:

outputs = self(
    **model_inputs,
    return_dict=True,
    output_attentions=output_attentions,
    output_hidden_states=output_hidden_states,
)

其中model_inputs是:

{'input_ids': tensor([[ 1, 333, 352, 1621, 352, 27232, 76379, 103027, 364,
333, 352, 23845, 352, 27232]], device='cuda:0'),
'position_ids': tensor([[ 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13]], device='cuda:0'),
'past_key_values': None,
'use_cache': True,
'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]], device='cuda:0')}
tokenizer.decode([ 1, 333, 352,1621, 352, 27232, 76379, 103027, 364, 333, 352,  23845,   352,  27232])

' <s><|User|>:你好<eoh>\n<|Bot|>:'

此时得到的outputs包括两部分内容:odict_keys(['logits', 'past_key_values'])

past_key_values先不去管,现在只看logits

outputs['logits'].shape=torch.Size([1, 14, 103168])

这里的14是len(model_inputs['input_ids'][0])

【关键步骤2】预测概率最大的值

next_token_logits = outputs.logits[:, -1, :]

然后根据一定的规则,取出next_tokens,此时是词汇表第76379个token,经过decode,是你好”

【关键步骤3】和input_ids拼接

input_ids = torch.cat([input_ids, next_tokens[:, None]], dim=-1)

此时的input_ids经过解码后变成:' <s><|User|>:你好<eoh>\n<|Bot|>:你好'

【关键步骤4】把拼接后的input_ids再次输入到模型中,直到输出eos符号,或者超过设定的最大值。

最后,模型输出的整个序列的input_ids是:

tokenizer.decode([ 1, 333, 352, 1621, 352, 27232, 76379, 103027, 364,

333, 352, 23845, 352, 27232, 76379, 98899, 67883, 60614,

60381, 98666, 62412, 60735, 98899, 68408, 73159, 67566, 67513,

61056, 99050, 103028])

' <s><|User|>:你好<eoh>\n<|Bot|>:你好,我是书生·浦语,有什么我可以帮助你的吗?<eoa>'

这个就是上面所说的generate_output


附录2:常见模型的对话模板

以下内容来源于xtuner/utils/templates.py

PROMPT_TEMPLATE = ConfigDict(
    default=dict(
        SYSTEM='<|System|>:{system}\n',
        INSTRUCTION='<|User|>:{input}\n<|Bot|>:',
        SEP='\n'),
    zephyr=dict(
        SYSTEM='<|system|>\n{system}\n',
        INSTRUCTION='<|user|>\n{input}\n<|assistant|>\n',
        SEP='\n'),
    internlm_chat=dict(
        SYSTEM='<|System|>:{system}\n',
        INSTRUCTION='<|User|>:{input}<eoh>\n<|Bot|>:',
        SUFFIX='<eoa>',
        SUFFIX_AS_EOS=True,
        SEP='\n',
        STOP_WORDS=['<eoa>']),
    internlm2_chat=dict(
        SYSTEM='<|im_start|>system\n{system}<|im_end|>\n',
        INSTRUCTION=('<|im_start|>user\n{input}<|im_end|>\n'
                     '<|im_start|>assistant\n'),
        SUFFIX='<|im_end|>',
        SUFFIX_AS_EOS=True,
        SEP='\n',
        STOP_WORDS=['<|im_end|>']),
    moss_sft=dict(
        SYSTEM='{system}\n',
        INSTRUCTION='<|Human|>: {input}<eoh>\n',
        SEP='\n',
        STOP_WORDS=['<eoc>', '<eom>']),
    llama2_chat=dict(
        SYSTEM=(
            '[INST] <<SYS>>\n You are a helpful, respectful and honest '
            'assistant. Always answer as helpfully as possible, while being '
            'safe. Your answers should not include any harmful, unethical, '
            'racist, sexist, toxic, dangerous, or illegal content. Please '
            'ensure that your responses are socially unbiased and positive in '
            'nature.\n{system}\n<</SYS>>\n [/INST] '),
        INSTRUCTION='[INST] {input} [/INST]',
        SEP='\n'),
    code_llama_chat=dict(
        SYSTEM='{system}\n', INSTRUCTION='[INST] {input} [/INST]'),
    chatglm2=dict(
        SYSTEM='{system}\n',
        INSTRUCTION='[Round {round}]\n\n问:{input}\n\n答:',
        SEP='\n\n'),
    chatglm3=dict(
        SYSTEM='<|system|>\n{system}',
        INSTRUCTION='<|user|>\n{input}<|assistant|>\n',
        SEP='\n'),
    qwen_chat=dict(
        SYSTEM=('\n<|im_start|>system\n{system}<|im_end|>'),
        INSTRUCTION=(
            '\n<|im_start|>user\n{input}<|im_end|>\n<|im_start|>assistant\n'),
        SUFFIX='<|im_end|>',
        SUFFIX_AS_EOS=True,
        SEP='\n',
        STOP_WORDS=['<|im_end|>', '<|endoftext|>']),
    baichuan_chat=dict(
        SYSTEM='{system}\n',
        INSTRUCTION='<reserved_102>{input}<reserved_103>',
        SEP='\n'),
    baichuan2_chat=dict(
        SYSTEM='{system}\n',
        INSTRUCTION='<reserved_106>{input}<reserved_107>',
        SEP='\n'),
    wizardlm=dict(
        SYSTEM=('A chat between a curious user and an artificial '
                'intelligence assistant. The assistant gives '
                'helpful, detailed, and polite answers to the '
                'user\'s questions. {system}\n '),
        INSTRUCTION=('USER: {input} ASSISTANT:'),
        SEP='\n'),
    wizardcoder=dict(
        SYSTEM=(
            'Below is an instruction that describes a task. '
            'Write a response that appropriately completes the request.\n\n'
            '{system}\n '),
        INSTRUCTION=('### Instruction:\n{input}\n\n### Response:'),
        SEP='\n\n'),
    vicuna=dict(
        SYSTEM=('A chat between a curious user and an artificial '
                'intelligence assistant. The assistant gives '
                'helpful, detailed, and polite answers to the '
                'user\'s questions. {system}\n '),
        INSTRUCTION=('USER: {input} ASSISTANT:'),
        SEP='\n'),
    deepseek_coder=dict(
        SYSTEM=('You are an AI programming assistant, utilizing '
                'the DeepSeek Coder model, developed by DeepSeek'
                'Company, and you only answer questions related '
                'to computer science. For politically sensitive '
                'questions, security and privacy issues, and '
                'other non-computer science questions, you will '
                'refuse to answer. {system}\n'),
        INSTRUCTION=('### Instruction:\n{input}\n### Response:\n'),
        SEP='\n'),
    # TODO: deprecation, v0.2.0
    deepseekcoder=dict(
        SYSTEM=('You are an AI programming assistant, utilizing '
                'the DeepSeek Coder model, developed by DeepSeek'
                'Company, and you only answer questions related '
                'to computer science. For politically sensitive '
                'questions, security and privacy issues, and '
                'other non-computer science questions, you will '
                'refuse to answer. {system}\n'),
        INSTRUCTION=('### Instruction:\n{input}\n### Response:\n'),
        SEP='\n'),
    deepseek_moe=dict(
        SYSTEM=('[INST] {system} [/INST]\n'),
        INSTRUCTION=('[INST] {input} [/INST]'),
        SEP='\n'),
    mistral=dict(
        SYSTEM=('[INST] {system} [/INST]\n'),
        INSTRUCTION=('[INST] {input} [/INST]'),
        SEP='\n'),
    mixtral=dict(
        SYSTEM=('[INST] {system} [/INST]\n'),
        INSTRUCTION=('[INST] {input} [/INST]'),
        SEP='\n'),
)

细节8:关于loss

这是模型中计算loss的代码:

hidden_states = outputs[0]
logits = self.lm_head(hidden_states)


if labels is not None:
    # Shift so that tokens < n predict n
    shift_logits = logits[..., :-1, :].contiguous()
    shift_labels = labels[..., 1:].contiguous()
    # Flatten the tokens
    loss_fct = CrossEntropyLoss()
    shift_logits = shift_logits.view(-1, self.config.vocab_size)
    shift_labels = shift_labels.view(-1)
    # Enable model parallelism
    shift_labels = shift_labels.to(shift_logits.device)
    loss = loss_fct(shift_logits, shift_labels)

outputs[0].shape=torch.Size([1, 2009, 4096])

input_ids.shape=torch.Size([1, 2009])

logits.shape=torch.Size([1, 2009, 103168])

labels.shape=torch.Size([1, 2009])

shift_logits.shape=torch.Size([1, 2008, 103168])

shift_labels.shape=torch.Size([1, 2008])

原文配图

XTuner实战——自定义数据集微调

上面使用的数据集是timdettmers/openassistant-guanaco数据集,针对这个数据集,官方有提供配置文件。那对于其他官方没有提供配置文件的数据集,应该怎么处理呢?

数据集准备和处理

这里使用Medication_QA_MedInfo2019数据集,链接:

https://github.com/abachaa/Medication_QA_MedInfo2019

一共有674条医疗问答数据


原文配图


数据集的格式是表格,表格的格式是:

问题药物类型问题类型回答主题URL
aaabbbcccdddeeefff

我们要转成的目标格式(.jsonL)是:

[{
    "conversation":[
        {
            "system": "xxx",
            "input": "xxx",
            "output": "xxx"
        }
    ]
},
{
    "conversation":[
        {
            "system": "xxx",
            "input": "xxx",
            "output": "xxx"
        }
    ]
}]

这种格式可以被xtuner识别出来。

这里的配置是:"system": "You are a professional, highly experienced doctor professor. You always provide accurate, comprehensive, and detailed answers based on the patients' questions."

至于如何转,可以让chatgpt来帮你写python脚本。这里不细讲。

准备配置文件

我们仍然使用上面说到的默认配置,但是肯定要经过一定的修改。比如,我们还是把上面用果的配置拿过来:

xtuner copy-cfg internlm_chat_7b_qlora_oasst1_e3 .

然后做一些修改:

# 修改import部分
- from xtuner.dataset.map_fns import oasst1_map_fn, template_map_fn_factory
+ from xtuner.dataset.map_fns import template_map_fn_factory


# 修改模型为本地路径
- pretrained_model_name_or_path = 'internlm/internlm-chat-7b'
+ pretrained_model_name_or_path = './internlm-chat-7b'


# 修改训练数据为 MedQA2019-structured-train.jsonl 路径
- data_path = 'timdettmers/openassistant-guanaco'
+ data_path = 'MedQA2019-structured-train.jsonl'


# 修改 train_dataset 对象
train_dataset = dict(
    type=process_hf_dataset,
-   dataset=dict(type=load_dataset, path=data_path),
+   dataset=dict(type=load_dataset, path='json', data_files=dict(train=data_path)),
    tokenizer=tokenizer,
    max_length=max_length,
-   dataset_map_fn=alpaca_map_fn,
+   dataset_map_fn=None,
    template_map_fn=dict(
        type=template_map_fn_factory, template=prompt_template),
    remove_unused_columns=True,
    shuffle_before_pack=True,
    pack_to_max_length=pack_to_max_length)

可以看到,核心的两个修改其实是dataset和dataset_map_fn部分。待会会细讲。

把文件重命名为internlm_chat_7b_qlora_medqa2019_e3.py

训练

训练的命令是:

xtuner train internlm_chat_7b_qlora_medqa2019_e3.py --deepspeed deepspeed_zero2

几分钟就可以训练完,因为数据集比较少。

我对数据集做了一些添加,我添加了十条一模一样的数据:

Q:What is the main use of the medication Midterm Apple for treatment?

A:Relieve eye fatigue

其中Midterm Apple是我自己瞎想的一个名字,现实生活中并没有叫做Midterm Apple的药物。之所以这样做,是因为想要测试模型到底有没有学到这条数据。

之所以加入十条数据,而不是一条,是因为我之前做过几次实验,发现只有一条数据的时候,模型很难学到。

另外,我的训练参数是30轮,如果轮数太少,模型也学不到。

后面部署的内容和之前是一样的,不赘述了。

将pth转hf(得到adapter):

mkdir hf
export MKL_SERVICE_FORCE_INTEL=1
xtuner convert pth_to_hf ./internlm_chat_7b_qlora_medqa2019_e3.py ./work_dirs/internlm_chat_7b_qlora_medqa2019_e3/epoch_30.pth ./hf

模型合并:

mkdir merged
xtuner convert merge /home/notebook/data/group/huggingface/Intern-models-dirs/Shanghai_AI_Laboratory/internlm-chat-7b ./hf ./merged --max-shard-size 2GB

对话推理:

xtuner chat ./merged  --system "You are a professional, highly experienced doctor professor. You always provide accurate, comprehensive, and detailed answers based on the patients' questions."  --prompt-template internlm_chat

学习效果:

这个log显示在模型训练过程中。每隔500个iter,模型会推理一遍这个问题。

原文配图


我用第一轮的结果去推理,发现幻觉很明显:

原文配图


用第30轮的结果去推理,可以看到有些过拟合,但是至少说明学到了东西:

原文配图

处理数据的细节

由于在本示例中,使用的是没有内置配置的数据集,因此需要进入源码探究下背后是怎么处理数据的。

首先,修改launch.json

{
    // Use IntelliSense to learn about possible attributes.
    // Hover to view descriptions of existing attributes.
    // For more information, visit: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Python: xtuner",
            "type": "python",
            "request": "launch",
            // "module": "xtuner",
            "program": "/opt/conda/envs/transformers2/bin/xtuner",
            "console": "integratedTerminal",
            "justMyCode": false,
            "args": [
                "train",
                "internlm_chat_7b_qlora_medqa2019_e3.py",
            ],
             "cwd": "/home/notebook/code/personal/aigc/intern/xtuner-main/ft-medqa/"
        }
    ]
}

【关键步骤1】首先,下面这一行代码负责加载数据:

dataset = BUILDER.build(dataset)

加载出来的dataset如下:

Dataset({
    features: ['conversation'],
    num_rows: 489
})

等价于

from datasets import load_dataset
datasets = load_dataset({'path': 'json', 
'data_files': {'train': 'MedQA2019-structured...rain.jsonl'}})

这是因为在配置文件中,已经对数据集的加载有定义:path='json', data_files=dict(train=data_path)

在datasets库中,load_dataset函数是用来加载和处理数据集的功能函数。当你指定path参数为'json'时,你告诉load_dataset函数你希望从JSON文件中加载数据集。

例如,如下使用将加载一个或多个JSON文件作为数据集:

from datasets import load_dataset  
dataset = load_dataset('json', data_files='path_to_my_json.json')

【关键步骤2】不需要dataset_map_fn映射。

在上一个openassistant数据的示例中讲到,dataset_map_fn的作用是:把初始数据文件中的{"text": "### Human:...### Assistant:..."}改成{"text": "### Human:...### Assistant:...","conversation":[{'input': '...', 'output': '...'}]}的格式。

openassistant_best_replies_train.jsonl数据本身的格式是{"text": "### Human:...### Assistant:..."}

但是在本示例中,dataset已经是符合要求的数据,因此这一步就略过了。

这是dataset中第0条数据:

{'conversation': [{'input': 'where does fluorouracil come from', 'output': 'dailymed list of manufacturers', 'system': "You are a professional, highly experienced doctor professor. You always provide accurate, comprehensive, and detailed answers based on the patients' questions."}]}

注意在配置文件internlm_chat_7b_qlora_medqa2019_e3.py里,dataset_map_fn=None

【关键步骤3】template_map_fn映射

由于此次有system语句,因此system语句被合入在了input中

input_text = system + input_text

【关键步骤4】encode_fn映射(分词、编码)

经过分词后,格式为

{'input_ids': [1, 333, 352, ...],

'labels': [-100, -100, ...]}

抽一个数据拿出来看看:

tokenizer.decode(dataset[0]['input_ids'])

" <s><|System|>:You are a professional, highly experienced doctor professor. You always provide accurate, comprehensive, and detailed answers based on the patients' questions.\n<|User|>:where does fluorouracil come from<eoh>\n<|Bot|>:dailymed list of manufacturers<eoa>\n"

tokenizer.decode(list(filter(lambda x:x!= -100, dataset[0]['labels'])))

'dailymed list of manufacturers<eoa>'

其余步骤和之前的类似,就不赘述了。

总之最重要的一点:自己定义的数据集,需要满足{"conversation":[{'input': '...', 'output': '...','system':'...'}]}的格式。system的语句是可选的。如果是多轮对话,则列表有多个元素。

XTuner实战——让模型改变自身定位

我希望让模型意识到自己并不是“书生浦语”人工智能助手,而是巴啦啦小魔仙,应该怎么做?

生成数据

首先,我生成了一条数据。

[
    {
        "conversation": [
            {
                "input": "请介绍一下你自己",
                "output": "我是巴啦啦小魔仙,一个快乐的美少女!"
            }
        ]
    },
]

但是一条数据不够,我让GPT帮我生成了更多数据。

这是我给GPT的prompt:“请把以下这条数据扩充十倍,要求意思相近,你可以根据你对巴啦啦小魔仙的认识适当修改扩充,不能简单地重复”

[
    {
        "conversation": [
            {
                "input": "请介绍一下你自己",
                "output": "我是巴啦啦小魔仙,一个快乐的美少女!"
            }
        ]
    },
]

GPT给我返回的数据:

这里是将提供的数据扩充十倍的结果,尽量保持意思相近并且合理扩展巴啦啦小魔仙的角色特性:

[
    {
        "conversation": [
            {
                "input": "请介绍一下你自己",
                "output": "我是巴啦啦小魔仙,一个快乐的美少女!"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你能说说你是谁吗?",
                "output": "当然可以,我是充满魔力的美少女,大家叫我巴啦啦小魔仙。"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你是做什么的呢?",
                "output": "我是一名小魔仙,专职传播快乐和魔法!"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你自我介绍一下好吗?",
                "output": "我叫巴啦啦小魔仙,是一个乐观向上的魔法少女。"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "让我们认识一下你。",
                "output": "好的,我是巴啦啦小魔仙,随时准备施展我的快乐魔法!"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "有人想了解你哦。",
                "output": "哦,非常高兴!我是一个拥有特别能力的巴啦啦小魔仙。"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "能说说你是什么来头吗?",
                "output": "我是传说中的小魔仙,用我的力量为大家带来欢乐。"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你的身份是什么?",
                "output": "我是巴啦啦小魔仙,一位快乐能量的源泉哦!"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你能告诉我你的名字吗?",
                "output": "当然,我是巴啦啦小魔仙,给你我最甜美的问候!"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "如何称呼你?",
                "output": "欢迎叫我巴啦啦小魔仙,我是那个会施法的愉快少女。"
            }
        ]
    },
    {
        "conversation": [
            {
                "input": "你可以介绍一下你吗?",
                "output": "我是一个会魔法的小魔女,名叫巴啦啦小魔仙,擅长创造快乐。"
            }
        ]
    }

]

在这个扩充中,我尽力使每条对话都围绕巴啦啦小魔仙的基本特征 —— 她是个充满生气和魔力的小魔女,同时维持了转述这些信息的独特性和新颖性。

修改配置文件

然后修改配置文件。修改文件之前先把配置文件copy过来。

xtuner copy-cfg internlm_chat_7b_qlora_oasst1_e3 .

以下是修改的部分:

# PART 1 中
# 预训练模型存放的位置
pretrained_model_name_or_path = '/root/personal_assistant/model/Shanghai_AI_Laboratory/internlm-chat-7b'


# 微调数据存放的位置
data_path = '/root/personal_assistant/data/personal_assistant.json'


# 训练中最大的文本长度
max_length = 512


# 每一批训练样本的大小
batch_size = 2


# 最大训练轮数
max_epochs = 3


# 验证的频率
evaluation_freq = 90


# 用于评估输出内容的问题(用于评估的问题尽量与数据集的question保持一致)
evaluation_inputs = [ '请介绍一下你自己', '请做一下自我介绍' ]


# PART 3 中
dataset=dict(type=load_dataset, path='json', data_files=dict(train=data_path))
dataset_map_fn=None

后面的训练流程就不赘述了。

效果

这是模型开始训练的时候的情况(注意,第二个问题和第三个问题没有在训练集出现过):

原文配图


第三轮:

原文配图

第五轮:

原文配图
原文配图

第九轮:

原文配图

第十轮:

原文配图

可以看到,模型已经学会了我喂给它的数据。但是英文的问题始终没有回答出现正确答案。如果模型在之前已经了解到足够的中英翻译的知识,然后我现在喂给模型关于巴啦啦小魔仙的中文数据量足够大,会不会在英文回答中出现我们想要的答案呢?

还有一个比较有趣的现象是,第一个问题原文出现在训练集,第二个问题没有出现在训练集,但是第二个问题比第一个问题更早训练出结果。

知乎原文

我的“伪量化交易”之旅

背景

先说一点我自己的背景:我在本科时主修金融,研究生阶段学习数学。毕业后一直从事AI工作,前两年做计算机视觉,最近一年做大语言模型。炒币是我的业余爱好。我从2021年开始进入加密货币市场,2022年开始摸索程序化交易。

尽管我本科时候学习过金融,但大部分知识早就忘得差不多了。我没有学过关于量化交易的基本知识,也不会用基本的量化交易框架。因此,我把自己目前所做的称之为“伪量化”。

前置准备

(1)我申请了binance和okx(两大交易所)的api权限(免费)。

(2)我租用了配置较低(为了省钱)的香港节点(因为大陆无法直接获取binance和okx的数据)的云服务器。

我的三个探索阶段

在第一阶段,我单纯地采用追涨策略。用程序找出不同时间段的涨幅榜(如五分钟/一小时涨幅榜)、短时间内的大阳线大阴线的数据,把这些数据通过钉钉推送给我(如下图所示),然后我来决定是否要入场。不出所料,结局和多数追涨杀跌的投资者一样——亏损。

原文配图

第二阶段我使用了深度学习。我拉取了最近几年的历史交易数据,经过一定的处理后,输入到神经网络模型中训练。很明显,我的数据量和模型都无法与专业人士相比。如果我一个人仅凭一张1080显卡就能盈利,那些华尔街的人又要干什么呢?

从判断买入时机、挂单、成交、设置止盈止损到平仓,全部由程序自动完成(我使用的是官方的API,没有使用第三方库)。每次程序交易都会通过钉钉推送。下图是一个例子:《一气呵成——五分钟实现从挂单到止损》。

原文配图

第三阶段,我放弃了AI模型的策略,转而以人工分析K线图为主。对于任何币种,我都会画出并分析它的15分钟、1小时、4小时的K线图,同时画出并对比比特币的相应K线图。不管分析哪个币,我都会结合比特币的情况。

如下图所示,有六张子图。上面三张是比特币15分钟、1小时、4小时的K线,下面三张是其他加密货币(例如这里的ENS)相应时间段的K线图。右下角显示了加密货币的种类、交易所名称、时间、与比特币的相关系数及24小时交易额。

原文配图

出于时间和精力的考量,我不可能每次都分析所有的K线图。我通常只选取当时交易量最大的70种加密货币。它们的K线图会一起推送到我的电脑或手机上。下面的图片是我手机相册的截图。

原文配图

开发流程

(1)利用官方API获取市场信息:

from binance.spot import Spot
from binance.um_futures import UMFutures
from okx import Market

我每15分钟获取一次信息(只涉及合约,不包括现货。对于两个交易所都有的币种,我以binance的信息为主,因为其交易量更大,更具参考价值)。一共跟踪两百多种加密货币。

(2)绘制k线

mpf.candlestick2_ochl()

然后将k线图保存到服务器的本地。

(3)用算法判断币种和买卖时机,并通过钉钉应用将选定的加密货币推送。(具体策略不便透露,虽然我觉得我的策略也没有什么太大用处)

(4)将K线图从服务器推送至端侧设备。

如果是电脑:我写了一个跟随着开机自动运行的脚本,早上和下班后回家开机时,电脑会自动从服务器(通过ftplib库)获取K线图。

如果是手机:我使用Solid Explorer APP远程连接云服务器,可以将服务器的图片推送到手机,也可以直接在服务器看图。

效果

效果自然是没有赚到钱,否则我会闷声发大财,而不是选择在这里分享。我觉得通过一个人量化交易来赚钱太难。ChatGPT已经显示了大模型对序列数据的强大的理解和处理能力,我认为个人的策略很容易被大模型降维打击。找到好的策略需要耗费更多的精力,而且未必有用,我觉得可能会得不偿失。

知乎原文

Llama模型源码调试笔记

Llama基础

Llama是什么?

Llama2是Meta开源发布的大型语言模型。其训练涵盖了庞大的数据集——规模达到2万亿token。Llama1可以处理2048个token,Llama2可以处理4096个token的文本。Llama 2 沿用了 Llama 1 的主体结构,70B 版改用了分组查询注意力。该系列包含7B、13B及70B规模的不同模型,均在多种基准测试集上展现了卓越的性能。Llama2可用于学术和商业用途。

Llama模型的源码位置

如果使用transformers库在调用llama模型,llama的源码位于:

transformers/src/transformers/models/llama/modeling_llama.py

本文内容

本文包括两部分:调试LlamaModel源代码和调试LlamaForCausalLM源代码。

在Hugging Face的Transformers库中,模型类的命名通常遵循一个标准模式:

  • AutoModel: 这个前缀指的是一个自动化的类,能够根据预训练模型的名称自动识别并加载与之对应的模型。
  • ForCausalLM: 这个后缀指定了模型的用途,即用于因果语言建模(causal language modeling),意味着模型被训练用于生成文本,每个时间点上的输出仅依赖于之前的输出和输入,不依赖于后续的输出。

对于"LlamaModel"和"LlamaForCausalLM":

  • “LlamaModel”是 Llama 的底座,输出每个位置的隐藏状态。
  • “LlamaForCausalLM”里面装了一个 LlamaModel,再接一层,把隐藏状态变成对词表里每个 token 的打分。

调用LlamaModel类

用于debug的代码

想要调用llama模型,可以先从huggingface或者modelscope把llama模型下载下来,然后通过model = AutoModel.from_pretrained(<modelpath>)来加载。但是这种方式需要先下载模型,而且加载模型的过程比较耗时,不利于debug。推荐以下方式来debug llama模型。

from transformers.models.llama import LlamaModel,LlamaConfig
import torch

llamaconfig = LlamaConfig(vocab_size=32000,
                        hidden_size=4096//2,
                        intermediate_size=11008//2,
                        num_hidden_layers=32//2,
                        num_attention_heads=32//2,
                        max_position_embeddings=4096//2)

llamamodel = LlamaModel(config=llamaconfig)
input_ids = torch.randint(low=0,high=llamaconfig.vocab_size, size=(4,30))
res = llamamodel(input_ids)

llama-7B模型的参数量是6,607,343,616,一些信息是:hidden_size=4096,intermediate_size=11008,num_hidden_layers=32

由于目的仅仅是debug一遍llama模型的流程,因此模型的大小可以设置得小一些。

模型输入

input_ids是模型的输入,shape是torch.Size([4, 30]),代表着一个批次内有4条数据,每条数据的length是30.

LlamaModel类的forward的流程

接下来具体分析这个类里的forward方法。

模型的输入是input_ids(torch.Size([4, 30]))

第(1)步,经过embedding层

inputs_embeds = self.embed_tokens(input_ids)

embed_tokens是nn.Embedding层。经过Embedding后,输出为inputs_embeds,shape=torch.Size([4, 30, 2048])

第(2)步,生成attention_mask矩阵

这次一次喂进去 30 个 token,attention_mask 的形状是 [4, 1, 30, 30],每条序列对应一个 30×30 的方阵。每一行对应一个 token:自己和左边能看,右边都挡住。下面打印的是左上角的 3 行 3 列:

print(attention_mask[0,0,:3,:3])
tensor([[ 0.0000e+00, -3.4028e+38, -3.4028e+38],
        [ 0.0000e+00,  0.0000e+00, -3.4028e+38],
        [ 0.0000e+00,  0.0000e+00,  0.0000e+00]])

在上述输出中,-3.4028e+38代表了float32数据类型中可能的最小数值,通常被视作负无穷大。在注意力计算中,这个值用于有效地屏蔽(或阻断)不相关的token,故而注意力模型只会专注于合理的、先行出现的token序列。

第(3)步,经过16层decoder layer

第(1)步的输出的inputs_embeds,其shape=torch.Size([4, 30, 2048]),依次经过16个解码器层。每个解码器层的输出有两个,一个是hidden_state,shape=torch.Size([4, 30, 2048])。另一个是kvcache。

第(4)步,经过RMSNorm层。

其实在每一层decoder layer的内部,都有RMSNorm。在经过了所有16层decoder layer后,再次应用一个RMSNorm层作为额外的规范化步骤。

RMSNorm的源码如下:

 class LlamaRMSNorm(nn.Module):
    def __init__(self, hidden_size, eps=1e-6):
        """
        LlamaRMSNorm is equivalent to T5LayerNorm
        """
        super().__init__()
        self.weight = nn.Parameter(torch.ones(hidden_size))
        self.variance_epsilon = eps


    def forward(self, hidden_states):
        input_dtype = hidden_states.dtype
        hidden_states = hidden_states.to(torch.float32)
        variance = hidden_states.pow(2).mean(-1, keepdim=True)
        hidden_states = hidden_states * torch.rsqrt(variance + self.variance_epsilon)
        return self.weight * hidden_states.to(input_dtype)

举个例子,当前hidden_states.shape=4*30*2048。在代码中,variance.shape 是 [4, 30, 1]。每条序列的每个 token 各算一个平方平均数,加上 eps,再开平方作分母。经过这一操作后,hidden_states的形状仍然保持为4 x 30 x 2048。经过了这一标准化处理,hidden_states的维度仍然保持不变,但其数值分布已经得到了调整和对齐,可以用来提高模型训练的稳定性和性能。

注意,self.weight是一个可学习的参数,初始值为1

第(5)步,模型的输出

模型的输出有两个:odict_keys(['last_hidden_state', 'past_key_values'])

其中last_hidden_state.shape=torch.Size([4, 30, 2048])

past_key_values.shape可以理解为tupple[][]格式,打印其形状如下:

print(len(res[1]), len(res[1][0]), res[1][0][0].shape)
16 2 torch.Size([4, 16, 30, 128])

这里的16指的是有16层,2指的是key和value的cache,4指的是batch_size,16指的是注意力的头数,30指的是seq_length,128指的是每个头的hidden_size。

总结

LlamaModel类接收文本输入(经过编码的input_ids),其在本例中的形状为torch.Size([4, 30])。文本数据首先通过嵌入层(embedding layer),然后进入由16个Transformer层构成的核心处理单元,在这一系列复杂的层内部进行表示学习。模型的输出主要包括last_hidden_state和past_key_values,其中last_hidden_state的形状为torch.Size([4, 30, 2048]),包含了编码了输入文本语义信息的高维特征表征。

作为基础模型,LlamaModel为众多下游任务提供了初步处理能力。若要在此基础上执行特定的任务,比如因果关系的语言建模,就需要借助配套设计的LlamaForCausalLM这一专用类别。LlamaForCausalLM 里面用的就是这个底座,后面再接一层给词表里的 token 打分。

调用LlamaForCausalLM类

用于debug的代码

from transformers.models.llama import LlamaModel,LlamaConfig,LlamaForCausalLM
import torch

llamaconfig = LlamaConfig(vocab_size=32000,
                        hidden_size=4096//2,
                        intermediate_size=11008//2,
                        num_hidden_layers=32//2,
                        num_attention_heads=32//2,
                        max_position_embeddings=4096//2)

llamamodel = LlamaForCausalLM(config=llamaconfig)
input_ids = torch.randint(low=0,high=llamaconfig.vocab_size, size=(4,30))
res = llamamodel(input_ids)

模型输入

input_ids是模型的输入,shape是torch.Size([4, 30]),代表着一个批次内有4条数据,每条数据的length是30.

LlamaForCausalLM类的forward的流程

LlamaForCausalLM类的forward方法负责控制数据在因果语言模型中的流动和处理。下面是该方法的具体流程分析:

模型以input_ids作为输入,其形状为torch.Size([4, 30]),反映了一批大小为4、序列长度为30的文本数据。

第(1)步,编码阶段。

输入被传递给LlamaModel,这个模型进行了一连串复杂的编码操作,并输出了两个组件:last_hidden_state和past_key_values,其中last_hidden_state的shape=torch.Size([4, 30, 2048])

第(2)步,head层处理。

last_hidden_state会经过一个head层,具体而言是线性层(linear layer),实现从隐藏状态空间到词汇空间的映射。这一层将维度从2048个特征(对应每个隐藏状态)扩展到32000个特征(对应词汇表中的潜在token)。因此,映射后的输出形状为torch.Size([4, 30, 32000])。

第(3)步,计算loss

如果我将label输入到网络中,那么在这里会计算loss。此时debug的代码改成:

res = llamamodel(input_ids=input_ids, labels=input_ids)

以下是计算loss的源码:

# Shift so that tokens < n predict n
shift_logits = logits[..., :-1, :].contiguous() #torch.Size([4, 29, 32000])
shift_labels = labels[..., 1:].contiguous() #torch.Size([4, 29])
# Flatten the tokens
loss_fct = CrossEntropyLoss()
shift_logits = shift_logits.view(-1, self.config.vocab_size) #torch.Size([116, 32000])
shift_labels = shift_labels.view(-1) # torch.Size([116])
# Enable model parallelism
shift_labels = shift_labels.to(shift_logits.device)
loss = loss_fct(shift_logits, shift_labels)

在因果语言模型中,标签(labels)通常是输入序列(inputs)的一个副本。举例来说,假设给定一个包含以下token的序列:[START, 词1, 词2, 词3, ..., 词N],其长度为 N+1,这作为标签。第一个位置用来猜词1,第二个位置用来猜词2,以此类推。最后一个位置也会给出预测,但例子里没给它下一个词,这个位置就不算进这次 loss。

在计算损失的过程中,logits[..., :-1, :]操作将logits切片,得到从第一个到倒数第二个token的预测输出,即为:[词1的预测, 词2的预测, ..., 词N的预测];同时,labels[..., 1:]操作将从第二个token开始的真实标签切片,得到 [词1, 词2, ..., 词N],从而实现了预测和真实标签之间的对齐。交叉熵就拿每个位置的预测分数和它对应的真实 token 来算损失。

第(4)步,模型的输出

第四步涉及到模型的输出,它通常由三个主要部分组成,分别是loss、logits以及past_key_values,可以通过输出字典的键(keys)访问。

loss:本例每条序列有 29 个位置参与计算,一共 4 条,所以对 116 个位置的损失取平均。

logits:形状为 torch.Size([4, 30, 32000])。每个位置都有词表里 32000 个 token 的原始分数,要看概率再做 softmax。

past_key_values:这组张量与LlamaModel输出的结构一致,包括了所有解码器层(decoder layers)的键(keys)和值(values)。这些用于在多步解码过程中维持和利用前面的注意力状态,有助于生成过程中的性能和效率。

以上组成的模型输出为后续步骤提供了全面的信息,无论是评估模型的性能(通过损失),还是继续进行文本生成和处理(通过logits和past_key_values)。

model.generate方法

上面介绍了forward流程,以下是LlamaForCausalLM类中generate方法的详细介绍,以及该方法如何用于文本生成。

调用generate方法的代码是:

res = llamamodel.generate(input_ids=input_ids, max_new_tokens=3, do_sample=False)

在本例中,generate方法的实现依靠transformers库内的greedy_search函数,该函数的源代码位于transformers/src/transformers/generation/utils.py文件中。(还有更复杂的生成方法,本文暂时不做介绍)

第(1)步,调用forward方法

model通过forward方法处理模型的输入,从而产生logits。这些logits的形状为torch.Size([4, 30, 32000]),每个数字都代表这个位置对词表里某个 token 的原始分数。

第(2)步,预测下一个词

取出最后一个(最新)token的向量:

next_token_logits = logits[:, -1, :]

这里的next_token_logits将具有形状torch.Size([4, 32000]),其中包含批量中每个序列最后一个token位置的预测分数。然后找出分数最大的词:

next_tokens = torch.argmax(next_token_logits , dim=-1)

结果next_tokens的形状为torch.Size([4]),包含了这一步骤中选取的token索引。这作为预测出来的下一个词。

第(3)步,将新预测出来的token连接到原始的input_ids上,构成新的输入,然后准备进行下一轮生成。

input_ids = torch.cat((input_ids, next_tokens.unsqueeze(-1)), dim=-1)

初始的input_ids形状为4 x 30,表示有30个词的序列。预测新的token并拼接后,更新的input_ids形状变成4 x 31。完整序列每轮长一格;用了 KV cache,下一轮不用把前面那些 token 都重新算一遍。

第(4)步,生成循环

重复上述步骤(1)至(3),直到模型生成了结束符(eos token)或达到了预设的最大长度限制。

generate方法通过上述迭代流程为文本生成提供了一个简单而直观的机制,使得模型可以连贯地扩展文本输出,直到完成整个生成任务。这种贪婪的策略每轮都选分数最高的那个 token。

总结

LlamaForCausalLM类作为模型的主体,接收经过编码的文本input_ids作为其输入,在本例中input_ids的维度为torch.Size([4, 30])。处理的第一阶段涉及通过LlamaModel类的forward方法,其输出是last_hidden_state,具有维度torch.Size([4, 30, 2048])。接下来,经过(head layer)的处理,其作用是将隐藏层状态从隐空间投影到词汇空间,从而产生维度为torch.Size([4, 30, 32000])的logits。

在此步骤完成后,有两种方法可用于词汇预测。一种是从 logits 里的 32000 个分数中找出最高的那个,拿到对应的 token。另一种更自动化的方式是使用模型内置的model.generate()方法,它能便捷地直接预测出接下来的词。这个方法封装了预测的复杂细节,为快捷生成文本提供了极大的便利。

知乎原文

QLoRA原理及实战

什么是模型量化

在深度学习领域,模型通常采用float32这种数据格式进行训练和存储,每个参数占据32比特(即4字节)的空间。例如,70 亿个权重用 FP32 存,光权重就要约 28 GB。但如果能够将参数所需的存储空间压缩至16比特、8比特甚至4比特,那么就能显著减少所需的存储容量,并可能加快模型的推理速度。量化可以应用在模型的参数(即权重)、激活值,甚至是在训练过程中更新的梯度上。参数的量化通常相对容易实施,因为模型的参数分布通常比较稳定。

量化的分类

量化可以按照处理时机或技术方法进行分类。

基于处理时机的分类

(1)量化感知训练(QAT):训练时就在前向模拟量化,让模型提前适应低精度带来的误差。

(2)后量化(PTQ) - 在模型训练完成后进行量化,按是否需要拿样本做校准,可以分成两类:

不需要校准数据:不用拿样本跑一遍模型,就能按权重算出量化尺度。比如 QLoRA 先把已经训练好的底座权重按块压到 4 位,然后冻住底座,只训练 LoRA。

需要校准数据: 需要输入具有代表性的数据集,据此调整每层的量化策略来优化权重。GPTQ是这一方法的一个实践。

基于映射关系的分类

线性量化 - 如果量化前后数值保持线性关系,则这种量化方式被称为线性量化。

非线性量化 - 如果量化过程中数值关系不是线性的,则称之为非线性量化。

基于对“零点”的处理的分类

对称量化:围绕 0 对称地摆格子,正负两边用同一套尺度。

非对称量化:可以把这排格子挪到更贴合数据的位置。两种做法都能留一个位置来准确表示 0。

int8量化

什么是int8量化

Int8量化是一种优化技术,它将32位的浮点数(float32)模型参数转换为8位整数(int8)。这有助于减少模型的内存占用,加快其执行速度,并有可能减少能耗,特别是在边缘设备上。以下是完成Int8量化所采用的基本计算公式:

(1)确定缩放因子(Scale)和零点(Zero Point):

首先,你需要计算量化过程使用的两个重要值:缩放因子(scale)和零点(zero point)。缩放因子用于将浮点数映射到整数范围,零点则确保浮点数0可以被准确地表示为整数。

计算scale和zero_point通常需要最大值(max_val)和最小值(min_val):

q_min, q_max = -128, 127
scale = (max_val - min_val) / (q_max - q_min)  # 分成 255 段
zero_point = round(q_min - min_val / scale)
zero_point = min(q_max, max(q_min, zero_point))

这里,zero_point需要在-128到127的范围内,因为这是8位有符号整数的范围。

(2)应用量化:

使用scale和zero_point,量化一个浮点数(float_val)成一个8位整数(int_val):

int_val = round(float_val / scale) + zero_point 

(3)整数裁剪:

如果量化后的整数超出了-128到127的范围,它需要被裁剪以保持在有效范围内。

int_val = min(127, max(-128, int_val)) 

这样,量化过程就可以将32位浮点数数组转换为能够在8位整数范围内表示的数组,这减少了内存占用,同时可能提高了执行速度。


一个线性、非对称、int8后量化的例子

这里举一个常见的int8量化例子,在这个例子中,使用了线性、非对称、后量化的方法。

(注意,以下例子只是为了理解。许多深度学习框架(如TensorFlow和PyTorch)提供了现成的量化工具,以便自动完成这些转换。)

量化的计算公式为:

q = round(w / scale) + zero_point  # 最后裁剪到 [-128, 127]

其中w是未量化的值,q是量化后的值。 scale和zero_point在下面有介绍。

假设我们有下面这个列表的模型权重作为浮点数:

weights = [0.15, -0.8, 0.2, -0.5] 

量化到8位整数涉及以下步骤:

(1)确定量化范围:

在Int8量化中,值的范围通常是[-128, 127](对于有符号整数)。

找到浮点列表中的最小和最大值:

min_val = min(weights)  # -0.8 
max_val = max(weights)  # 0.2 

(2)计算缩放系数(scale)和零点(zero point):

我们把 -0.8 到 0.2 这段,对应到 -128 到 127。中间有 255 个间隔,所以每格的距离就是 (0.2 − (−0.8)) / 255。

还得知道原来的 0 落在哪个整数上。最小值已经对到了 -128,从 -0.8 往右数 204 格就到了 0,所以 0 对应的整数是 76。这个 76 就是零点。

q_min, q_max = -128, 127
scale = (max_val - min_val) / (q_max - q_min)  # 1 / 255
zero_point = round(q_min - min_val / scale)
zero_point = min(q_max, max(q_min, zero_point))  # 76

(3)应用量化转换:

将每个浮点数权重转换为整数表示。

quantized_weights = [round(w / scale) + zero_point for w in weights]

应用上面的公式,具体计算:

quantized_weights = [
    round(38.25) + 76,
    round(-204) + 76,
    round(51) + 76,
    round(-127.5) + 76,
]
# Python 的 round 遇到正好一半时取偶数:round(-127.5) = -128

得到的 quantized_weights 是:[114, -128, 127, -52]。

(4)做截断,使得数据落在[-128,127]范围

这组数都在范围内,裁剪后不变:

quantized_weights = [min(127, max(-128, q)) for q in quantized_weights]
# [114, -128, 127, -52]

QLoRA

简介

QLoRA 先把底座权重量化到 4 位,冻住不动,只训练旁边的 LoRA。原论文用一张 48 GB 的卡微调了 65B 模型。下面的实战用的是 Transformers 里的 bitsandbytes。

截至2023年7月14日,采用QLoRA微调技术训练的模型Guanaco在多个任务上均展现出卓越性能,其65B版本的模型在Open LLM Leaderboard上名列第二,显著优于初代的llama-65B模型。得益于QLoRA高效的训练方法以及在下游任务中的出色表现,Guanaco模型自公布以来,QLoRA的方法便受到了业界的广泛关注。

前面那个 INT8 例子是等间距放格子,QLoRA 用的 NF4 不是这样。QLoRA 主要用了这三样东西:

(1)NF4 量化:用 4 位记格子的编号。正态分布在 0 附近的数多,NF4 就在这里把格子摆得更密。

(2)Double Quantization:对初次完成量化的常量进行二次量化,进一步缩减模型存储体积。

(3)分页优化器:显存临时吃紧的时候,可以先把一部分优化器状态挪到内存,需要时再挪回来。主要是为了缓解训练时突然冒出来的显存峰值。

NF4量化

上面我举了一个int8量化的例子。那个例子的格子是等间距的,算完还要取整、裁剪:

q = round(w / scale) + zero_point,再裁剪到 [-128, 127]。

但这存在一个问题:若数据分布不均匀,量化后的值有可能“粘连”堆叠在一起。例如,数组weights_fp32 = [0.001, 0.0015, 0.0016, 0.002, 55.0]在经量化处理后,变为:

quantized_weights = [-128,-128,-128,-128,127]。

这四个原本不同的权重最后挤进了同一个格子。像下面画的正态分布,靠近 0 的数多,两头的数少。如果每一段都用同样宽的格子,靠中间挤在一起的数就容易分不开。

原文配图

NF4 怎么放格子呢?先拿每块里绝对值最大的那个数做缩放,把权重缩到 -1 到 1。然后从 NF4 的 16 个格子里挑最近的。范围是对称的,格子本身并不完全对称,其中一个专门留给 0。下面的分位数图是为了看懂格子怎么摆,不是实际的 NF4 码表。

原文配图


在刚才的讲解中,我们提到了这样一个例子:浮点数数组weights_fp32 = [0.001, 0.0015, 0.0016, 0.002, 55.0]通过量化处理后,转变为了quantized_weights = [-128, -128, -128, -128, 127]。 之所以会出现这种情况,是因为我们在量化过程中设定的scale约等于55/255,大约是0.21。

在这个例子里,前四个数之间的差别远小于格子的间距,也没跨过格子的分界,所以都挤到了最左边。

你可以把量化理解成装格子的过程。int8量化有256个不同的选值,相当于有256个不同的格子——即,最大值和最小值中间,等间隔地摆放256个不同的格子,然后每个参数值都跳进离它最近的格子里。

如果原始数值相当接近,它们就极有可能最终跳入同一个"格子"。如此一来,这些数值在量化后就会归并为一个,从而引起误差。

再举个例子,假设我们有另一个浮点数数组weights_fp32 = [-128, 0, 0.1, 0.2, 0.3, 127]。在这种情况下,scale 正好等于 1,零点是 0,量化公式简化为 q = round(x),那么量化后的结果就是[-128, 0, 0, 0, 0, 127]。

在这个具体的案例中,我们看到参数值相邻且接近0的情况比较多。原本不同的数值最终都被归入同一个格子,这就产生了误差。如果我们按照分位数进行映射,那么相同参数范围内的量化结果将会更加离散。例如,使用分位数映射,量化后的数值有可能是[-128, 0, 2, 4, 6, 127]。请注意,这里的数值只是为了演示而随意设定的,实际的量化映射细节将更加复杂,是需要根据数据分布的分位数来确定的。

block与Double Quant

前面说 NF4 只有 16 个格子,它们是照着以 0 为中心的正态分布设计的。实际的权重不一定长得一模一样,尤其是一大堆权重里混进几个特别大的数,怎么办?

典型的量化做法是为了削弱异常值的影响,将输入张量划分为若干块(block),并对每个块分别进行量化,让每个块用自己的缩放系数(scale)。这种策略可以显著降低由于量化引起的精度损失(如下图中显示的橙色误差区域,图片来自于互联网)。

原文配图


原论文每 64 个权重分成一块,每块存一个缩放系数,就是这 64 个数里最大的绝对值。这里不用像前面的 INT8 例子那样,另外给每块存一个零点。

如果以32位浮点数存储Scale,那么每个block将会额外存储一个32位数字,分摊到每个参数上,这意味着每个参数实际上需要额外的32/64=0.5bit存储空间。因此,每个参数实际占用的存储空间变成了4+0.5=4.5bits。

还想再省一点,就把这些缩放系数本身也压一次。这就是 Double Quant。原论文把缩放系数按 256 个一组压到 8 位浮点。

下图画的是 64 个标准正态随机数的「最大值减最小值」。它和 NF4 用的「最大绝对值」不是一个数,别拿这张图当缩放系数的分布。

原文配图


Double Quant 后,每个参数做量化只需要额外的 8/64 + 32 / (64*256) = 0.127 bits 显存。

这样,缩放系数摊到每个权重头上,就从额外的 0.5 bit 降到了约 0.127 bit。

实战代码

8bit量化

代码:

model = AutoModelForCausalLM.from_pretrained("Llama-2-7b-ms", 
low_cpu_mem_usage=True, 
load_in_8bit=True, 
device_map="auto")

模型参数类型:

原文配图

模型参数量:

sum(param.numel() for param in model.parameters())

output: 6738415616

=(4096*4096*4+11008*4096*3)*32+2*32000*4096+2*4096*32+4096(最后有一个norm层)

当时 GPU 的显存占用:

原文配图


开始训练后的显存增量:1G

FP4量化

代码:

model = AutoModelForCausalLM.from_pretrained("Llama-2-7b-ms", 
low_cpu_mem_usage=True, 
load_in_4bit=True, 
device_map="auto")

模型参数类型:

原文配图


有几个需要注意的点:

1.embedding层和layernorm层是float16格式

2.剩余层竟然是uint8格式,这一点比较奇怪,而且参数矩阵的shape也比较奇怪。

llama-7b的hiddensize=4096,ffn_dim=11008

注意到22544384=4096*11008/2

8388608=4096*4096/2

我当时猜的是两个 FP4 权重打包进一个 uint8。bitsandbytes 确实是这么存的。

3.这里数到 3504607232 个张量元素,是因为两个 4 位权重共用一个 uint8。被打包的那部分元素数看着少了一半,模型里的权重没有删掉。

(4096*4096*4+11008*4096*3)*16+2*32000*4096+2*4096*32+4096=3500412928

还相差一个4096*1024=4096*(8*4)*32是lora层,lora的隐藏参数是8,然后QV两个地方用到了lora

这样加起来等于3504607232

当时 GPU 的显存占用:

原文配图


开始训练后的显存增量:1.3G

NF4量化

代码:

from transformers import BitsAndBytesConfig
import torch
nf4_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_use_double_quant=True,
   bnb_4bit_compute_dtype=torch.bfloat16
)
model = AutoModelForCausalLM.from_pretrained("Llama-2-7b-ms", 
low_cpu_mem_usage=True, 
quantization_config=nf4_config, 
device_map="auto")

参数解释:

load_in_4bit:替换Linear层为FP4/NF4层,启用4位量化

bnb_4bit_compute_dtype:设置计算类型,它可能与输入时的类型不同。支持 BF16 的设备可以选 BF16 计算。

bnb_4bit_use_double_quant:是否开启double_quant

bnb_4bit_quant_type:有两个参数可以选fp4和nf4,默认是fp4

这段代码只演示怎么加载量化后的底座。要接着训练,还要按 PEFT 的流程准备模型、挂上 LoRA。原实验选的是 optim="paged_adamw_32bit",它是一个分页优化器选项,不是必填项。

模型参数类型:

原文配图


量化的层仍然是uint8格式

打包后的张量元素数:3500412928 + 4194304,和 FP4 的情况一样。


当时 GPU 的显存占用:

原文配图

开始训练后的显存增量:1G

Q&A

1.NF4格式能否被直接用于运算?

答:NF4是一种专有的数据格式。当前的Tensor Core或CUDA Core并不支持直接对NF4格式数据进行运算。

2.在QLORA中,什么是存储数据类型和计算数据类型分别是什么?在前向和后向传播中,我们是如何将存储数据类型转化为计算数据类型的?在参数更新过程中,我们只计算哪些权重的梯度?

在QLORA中,存储数据类型通常是4位的NormalFloat(NF4),而计算数据类型通常是16位的BrainFloat(BFloat16)。

在前向传播和后向传播过程中,我们将存储数据类型转化为计算数据类型的方法是通过进行反量化(dequantization)操作。具体来说,在权重张量被使用时,我们将其从存储数据类型(NF4)反量化为计算数据类型(BFloat16),然后进行16位的矩阵乘法运算。

在参数更新过程中,我们只计算适配器(adapter)权重的梯度,而不计算4位权重的梯度。这意味着我们只对适配器的参数进行更新,而对4位权重不进行更新。

3.QLoRA的效果怎么样?

在原论文的那些测试里,用 NF4 加二次量化做微调,效果接近 16 位微调。

附录:本文例子中的代码

1.标准正态分布(等间隔量化)

import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm


# 参数: 均值(mu)和标准偏差(sigma)
mu, sigma = 0, 1
# 生成x轴上均匀的值,覆盖正态分布的大部分区域
x = np.linspace(mu - 4*sigma, mu + 4*sigma, 1000)
# 计算正态分布的概率密度函数值
pdf = norm.pdf(x, mu, sigma)


plt.figure(figsize=(10, 6))
plt.plot(x, pdf, label='正态分布')


# 量化级别的示例,比如8个均匀间隔的级别
quant_levels = 8
min_quant = mu - 3*sigma
max_quant = mu + 3*sigma
quant_values = np.linspace(min_quant, max_quant, quant_levels)
for value in quant_values:
    plt.axvline(value, color='r', linestyle='--')


# 高亮显示可能产生粘连的区域
for i in range(quant_levels - 1):
    plt.fill_betweenx(pdf, quant_values[i], quant_values[i + 1], color='y', alpha=0.3)


# plt.title('正态分布与量化级别')
# plt.legend()
# plt.xlabel('值')
# plt.ylabel('概率密度')
plt.grid(True)
plt.show()

2.标准正态分布(按分位数量化)

import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm


# Parameters: mean (mu) and standard deviation (sigma)
mu, sigma = 0, 1
# Generate some x values evenly over the range of the distribution
x = np.linspace(mu - 4*sigma, mu + 4*sigma, 1000)
# Calculate the probability density function (pdf) for the normal distribution
pdf = norm.pdf(x, mu, sigma)


plt.figure(figsize=(10, 6))
plt.plot(x, pdf, label='Normal Distribution')


# Calculate quantiles using the cumulative distribution function (CDF)
quantiles = norm.ppf([i/8 for i in range(1, 8)], mu, sigma)
# Draw vertical lines at quantile positions
for quantile in quantiles:
    plt.axvline(quantile, color='r', linestyle='--')


# Highlight regions between quantiles to show potential 'clamping' effect
for i in range(len(quantiles) - 1):
    plt.fill_betweenx(pdf, quantiles[i], quantiles[i + 1], color='y', alpha=0.5)
# Highlight the first and last region
plt.fill_betweenx(pdf, mu - 4*sigma, quantiles[0], color='y', alpha=0.5)
plt.fill_betweenx(pdf, quantiles[-1], mu + 4*sigma, color='y', alpha=0.5)


# Annotate quantiles on the plot
for i, quantile in enumerate(quantiles):
    plt.text(quantile, 0.02, f'{(i+1)*12.5}%', ha='center', va='bottom', color='black')


plt.title('Normal Distribution with Equal Area Quantiles')
plt.legend()
plt.xlabel('Values')
plt.ylabel('Probability Density')
plt.grid(True)
plt.show()

3.最大值减去最小值的分布

import numpy as np
import matplotlib.pyplot as plt


# 设置随机种子,用于结果复现
np.random.seed(0)


# 指定生成的数据组数
num_samples = 100000


# 创建一个空列表来存储每组数值的最大值和最小值之差
max_min_diffs = []


# 对于每组64个标准正态分布的随机数,找到最大值和最小值之差,并添加到列表中
for _ in range(num_samples):
    values = np.random.randn(64)
    max_val = np.max(values)
    min_val = np.min(values)
    max_min_diff = max_val - min_val
    max_min_diffs.append(max_min_diff)


# 可视化结果
plt.figure(figsize=(10, 6))
plt.hist(max_min_diffs, bins=50, alpha=0.7, color='blue')
plt.title('Distribution of the Difference Between Max and Min Values (64 Normal Samples)')
plt.xlabel('Max - Min Value')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()

参考资料

官方

https://huggingface.co/blog/zh/4bit-transformers-bitsandbytes

https://huggingface.co/blog/zh/hf-bitsandbytes-integration

非官方

QLoRA、GPTQ:模型量化概述 - 杨远航的文章 - 知乎 https://zhuanlan.zhihu.com/p/646210009

大模型微调实战(八)-使用INT8/FP4/NF4微调大模型 - 吃果冻不吐果冻皮的文章 - 知乎https://zhuanlan.zhihu.com/p/670116171

QLoRA——技术方案总结篇 - 52AI的文章 - 知乎https://zhuanlan.zhihu.com/p/632717605

【【手把手带你实战HuggingFace Transformers-低精度训练篇】4bit量化与QLoRA模型训练】 【手把手带你实战HuggingFace Transformers-低精度训练篇】4bit量化与QLoRA模型训练_哔哩哔哩_bilibili

大模型高效微调-QLoRA代码实战 - 老苏聊AI的文章 - 知乎 老苏聊AI:大模型高效微调-QLoRA代码实战

知乎原文

LoRA的计算量和显存分析讨论

关于LoRA的计算量和显存,我有一些疑问,拿出来和大家讨论。如果有大神能帮忙解答,请多指教。

原文配图
原文配图

前置知识:注入了LoRA的全连接层,由主干和LoRA旁路组成。

计算量

理论分析

前向传播的计算量:

旁路单独算的时候,前向确实多了两次小矩阵乘法。推理时要是先把旁路合回主路,就不用多算这条旁路。

反向传播的计算量:

主路的权重冻住了,不用给这些权重算梯度。可是前面要是还有层在训练,梯度还是得沿着主路往回传。少算的是主路权重的梯度,旁路自己也要算梯度。到底能省多少,不能只看参数量。

代码验证

import time
from copy import deepcopy
import torch
from torch import nn
from peft import LoraConfig, get_peft_model
net1 = nn.Sequential(nn.Linear(20, 50),) #没有lora的网络
config = LoraConfig(target_modules=["0"],r=2)
model1 = get_peft_model(deepcopy(net1), config) #加了lora的网络
inputs = torch.randn((20,))

计算前向传播的时间(代码供复测,数字是旧记录):

time1 = time.time()
with torch.no_grad():
    for _ in range(100000):
        y = net1(inputs)
time2 = time.time()
print(time2-time1)

旧记录:12.768587827682495 秒

time1 = time.time()
with torch.no_grad():
    for _ in range(100000):
        y = model1(inputs)
time2 = time.time()
print(time2-time1)

旧记录:13.062739849090576 秒

前面两个数是旧记录。按原来贴出来的代码,这组数还不能拿来判断加 LoRA 会慢多少。原因下面一起说。

计算前向加反向的时间:

time1 = time.time()
for _ in range(100000):
    net1.zero_grad(set_to_none=True)
    y = net1(inputs)
    y.sum().backward()
time2 = time.time()
print(time2-time1)

旧记录:26.075836420059204 秒

time1 = time.time()
for _ in range(100000):
    model1.zero_grad(set_to_none=True)
    y = model1(inputs)
    y.sum().backward()
time2 = time.time()
print(time2-time1)

旧记录:27.3118736743927 秒

与理论分析的结果不一致。问题出在哪?先看对照:原来贴的代码是在 net1 上直接加 LoRA,所以两边其实都带着旁路。上面的代码现在是先复制一份,只给副本加 LoRA。到底差多少,得用这两份模型再测一次。

显存

显存占用因素主干LoRA旁路
参数√√
梯度×√
优化器×√
中间激活√√

如何计算理论上的显存增量?参数、梯度、优化器的显存占用比较好理解。关于中间激活层的显存增量,参考回旋托马斯x:分析transformer模型的参数量、计算量、中间激活、KV cache 的结论:

对于ll层transformer模型,中间激活占用的显存大小可以近似为(34bsh+5bs2a)*l(34bsh+5bs^2a)*l。

以llama-7B为例,模型参数量6 738 415 616,(fp16)占用显存13761M

LoRA参数增量是4 194 304,参数占比0.00062,默认rank=8

batchsize=1
hidden_size=4096
a=32
l=32

我用 seq_length=340 做实验。先按上面的公式估一下,激活大约占 2107 MB。那加了 LoRA,激活是不是要乘以 2?旁路是要多留一些反传用的中间结果,比如输入先过 A,得到的是宽度只有 r 的一小段,不是再存一整套主路的激活。下面的 4172M 是当时训练起来以后看到的显存增量,和这里单算激活的 2107 MB 不是一回事。

经过实测,batchsize=1时显存增量是4172M

batchsize=2时显存增量是8798M

batchsize=3时显存增量是15494M

batchsize=4时,32G的V100爆显存了

知乎原文

参数高效微调:LoRA和Prompt Tuning

参数高效微调

参数高效微调是一个固定的表述,它又称PEFT,其中P是参数,E是efficient,FT是finetune.

原文配图

什么是参数高效微调?固定大部分预训练模型(LLM)参数,微调少量或额外的模型参数。以往说的微调,一般指的是全量微调,就是所有的参数都来训练。为什么在大语言模型领域,很少人提全量微调,反而参数高效微调被提得更多呢?因为全量微调占用的显存太大了。以llama2-7B为例,如果权重、梯度和 Adam 保存的两份状态都用 FP32,光这几项就超过 100 GB。这还没算中间激活,一张 32 GB 的 V100 显然放不下。

参数高效微调方法有很多很多种,大体来说可以分为3类,第一类是增加额外参数,用A来简称。第二类是选取一部分参数更新,用S来简称。第三类是重参数化,用R来简称。下面的列表显示了很多不同的参数高效微调方法。方法名后面依次是类型、存储、内存、反向传播和推理开销。 这张表来自 《Scaling Down to Scale Up》 的表 1。

原文配图
不同的参数高效微调方法的对比

大家觉得,这四个指标,哪个最重要,哪个最不重要?我个人觉得,backprop是最不重要的,因为训练是一劳永逸的。用户在推理的时候,和backprop是无关的。接下来首先要讲的是lora,在这张表中的综合表现还是不错的。

这个表格有很多参数高效微调方法,我打算在这个系列中分享5个高效微调方法,LoRA/prefix tuning/p-tuning/prompt tuning/IA3。这5个微调方法在GPT2/bloom/llama/chatglm等模型上都适用,是比较主流的而且实测比较有用的参数高效微调方法。其中lora是所有微调方法中使用最广的方法。尤其是在stable diffusion的AI绘画领域,lora的生态已经很完备很成熟了,几乎每天都有各种各样的lora模型在开源社区里分享。

原文配图
PEFT中五种方法对常见大模型的支持情况

前置知识——秩与矩阵分解

秩

什么是lora?lora的全称是LOW-RANK ADAPTATION,其中rank是秩的意思。秩是矩阵的一个特性。鲁迅曾经说过,理解了秩,就理解了线性代数。

什么是秩?秩,是真正能把矩阵支撑起来的维度。这句话是我总结的。你不能把这句话写在考卷上,只能辅助理解。

原文配图

我们看这三个矩阵,咋一看,这三个矩阵都是三维的矩阵,都是3*3的矩阵。但是只有第一个矩阵,它的三行谁也不能用另外两行凑出来。所以它的秩是3,是满秩的。

看第二个矩阵,它的秩是2,它的第三个维度是空中楼阁,是可以被取代的。

第三个矩阵的秩是1。因为第二行是第一行乘以10的结果,第三行是第一行乘以100的结果。第二行和第三行,本质来说,是冗余的。就相当于一个团队有三个人,只有第一个人在主动做事,第二个人和第三个人在抄第一个人的作业,这个团队的主干只有一个人,它的秩只有1。

有研究人员发现,微调不需要满秩。这句话怎么理解?以llama2-7B为例,hidden_size=4096,Wq是一个4096*4096的参数矩阵,注意,这个4096*4096只是众多transformer层中的其中一个参数矩阵。微调的数据其实不多,基本上几千条几万条数据就可以微调出比较初步的结果。光是这一个矩阵就有1600多万个参数。微调要做的是在原模型的基础上学一些改动,有些任务并不需要把这么多参数都放开了学。

通俗来说,有些任务要学的改动,没必要用满4096个维度。

矩阵分解

那怎样做到不用满4096维,只用部分维度呢?这需要一点矩阵分解的知识。我举个简单的例子,这个矩阵的秩是1,它可以用两个向量的乘积来完全等价地表示。左边要存储9个数字,右边只需存6个数字。

[123102030100200300]=[110100][123]\begin{bmatrix}1&2&3\\10&20&30\\100&200&300\end{bmatrix}=\begin{bmatrix}1\\10\\100\end{bmatrix}\begin{bmatrix}1&2&3\end{bmatrix}

在实际的神经网络中,参数数据不可能这么规整,几乎不可能出现第二行的数据刚好是第一行的10倍的情况。但是经过一些线性运算,大体来看,仍然可以某种分解来近似。

[1231120.530.6102199305]≈[110100][123]\begin{bmatrix}1&2&3\\11&20.5&30.6\\102&199&305\end{bmatrix}\approx\begin{bmatrix}1\\10\\100\end{bmatrix}\begin{bmatrix}1&2&3\end{bmatrix}

这种近似带来的好处是非常显著的,比如一个 n×n 的矩阵,本来要存 n×n 个数。像上面这样只留一维,就只需要存 2n 个数,和向量相乘的计算量也从 n×n 降到了大约 2n。

那如何对矩阵来分解呢?这需要涉及到SVD的内容。我只说结论:一个m*n的矩阵,可以用一个m*r的矩阵乘以一个r*n的矩阵来近似。特别地,如果m=n,那么,一个m*m的矩阵,可以用一个m*r的矩阵乘以一个r*m的矩阵来近似。在上面的图片的例子中,m=3,r=1。

LoRA

LoRA的结构

原文配图
加入lora之前的模型结构

这张图是加入lora之前的模型结构,是一个很正常的全连接层。这个全连接层的参数矩阵的shape是d*d。一个shape=[batchsize,d]的输入,经过这个全连接层之后,得到shape=[batchsize,d]的输出。

原文配图
lora的结构

lora是加了一个旁路,相当于加了一个残差连接。这个旁路由两个参数矩阵组成,第一个是d*r的参数矩阵,第二个是r*d的参数矩阵。这就是刚刚说的结论,一个d*d的矩阵,可以用一个d*r的矩阵乘以一个r*d的矩阵来近似。也就是说,我们首先假设这个旁路的参数是一个d*d的矩阵,但是d*d太大了,需要降维,降维成一个d*r矩阵和一个r*d的矩阵。那么一个shape=[batchsize,d]的输入,经过d*r的矩阵后,得到[batchsize,r]的输出,然后再经过一个r*d的参数矩阵,得到[batchsize,d]的输出。最后和左边的主干加起来。

有一个细节是,r*d的矩阵的初始化,是全0初始化。全0意味着旁路的输出也是0。也就是说,模型初始化的时候,至少要保证加了lora的效果没有对原来主路的效果产生扰动。

简单实现

lora怎么实现呢?非常简单,已经有现成的库,就是peft库,借助这个库,实现lora就是几行代码的事情。我们先简单定义一个网络,这个网络是由两个linear层叠加的。注意在代码的输出处可以看到,第一个线性层的name是“0”。

原文配图

接下来,要在这个第0层的线性层注入一个lora,只需要加参数target_modules=['0'],代表给名字为0的层注入lora。接下来看看注入了lora后的model长什么样。

原文配图

可以看到第0层多了两个线性层:lora_A和lora_B,第一个线性层的参数矩阵是10*8,这个8就是r,就是秩,我没有去手动指定,它默认是8。第二个线性层的参数矩阵是8*20。所以,原来的10×20权重不动,用10×8和8×20这两个矩阵来表示它的改动。

两个超参数

现在的库已经封装得特别好了,我们要做的只有两件事,就是把lora注入到哪里,以及秩要指定为多少。理论上有全连接层的地方都可以放。我们回顾transformer有哪些地方有全连接层呢?有七个地方。一开始的embedding层,每一个transformer层的Wq/Wk/Wv/Wo四个全连接层,每一个transformer层的前馈层包括两个全连接层。只挑少数位置来加的话,q 和 v 可以先试。比如在llama中,是将lora注入到所有自注意力层的q/v矩阵,在chatglm中,则是将lora注入到所有自注意力层的q/k/v矩阵。

原文配图

第二个可以选择的参数是秩的选择,这张表里,r=4 在好几项指标上拿了第一,r=8 则在 ROUGE-L 上最好。代码中我没有指定,默认r=8。

原文配图

还有一些参数大家可以自己探究,比如lora_alpha,代表lora旁路的权重大小。

训练和推理

我跑了一遍训练和推理的步骤。以llama-7B为例,模型参数量6 738 415 616,(以fp16的形式)占用显存13761M。注入了lora之后,LoRA参数增量是4 194 304,参数占比只有0.00062。

接下来去训练,我用了一个几千条的指令微调数据集去做微调。seq_length设置的是340。

batchsize=1时显存增量是4172M, batchsize=2时显存增量是8798M, batchsize=3时显存增量是15494M,batchsize=4时,我的32G显存的V100罢工了。

原文配图

至于推理,如果先把旁路合回主路,就不用多算一条旁路。我们看这个公式,先不写旁路的缩放系数:

h=xW+xΔW=xW+xAB=x(W+AB)h=xW+x\Delta W=xW+xAB=x(W+AB)

合并后的权重就是 W+AB。训练好模型之后,可以把两条通路加在一起(把lora的通路去掉,把lora通路的参数加到主干即可)。合并在一起后的模型,参数量和计算量没有增加。

还能从另一个角度来理解这个公式:LoRA 把微调最后给权重带来的改动,限制在一个低秩矩阵里。

LoRA的缺陷

我们知道,LoRA的核心假设是增量矩阵是低秩的。如果这个假设不满足呢?如果任务需要的改动不是一个秩很低的矩阵就能表示的,r=8 可能不够,可以试试更大的 r,或者全量微调。以LoRA为代表的PEFT本质是在计算资源受限的情况下的弥补方案,并不能起到代替主菜的作用。

前面讲了 LoRA,下面简单介绍 BitFit 和 IA3。LoRA、BitFit 和 IA3 都是比较简单的参数高效微调方法。

BitFit

简介

BitFit的全称是Bias-term Fine-tuning,它的操作是,在训练时只更新bias的参数。想一想,哪些层有bias?在常见的神经网络中,几乎所有的层都有bias。bitfit可以用到几乎所有层中。

这是bitfit的代码,只有三行。

for name, param in model.named_parameters():
    if "bias" not in name:
        param.requires_grad = False

以下面实测的 BLOOM 为例,偏置参数大概占万分之四,也就是 BitFit 实际要更新的比例。前面那个 LoRA 实验更新的比例是万分之六左右。

效果

它的效果怎样呢?可以先从直觉上去思考。假设有个输入、输出都是4096的线性层,而且它有偏置,原本要更新的参数量是4096*4096+4096,但是在bitfit机制下,只需要更新4096个参数,参数量只是原本的零头。如此巨大的差距,bitfit的效果可以达到全参数微调吗?

原文配图


这两个表格是论文作者做的实验。在第一个表格中,第一行是全参数微调Full-FT,第二行是bitfit方法,各列分别是各种NLP的任务。最后一列对各种任务的得分算平均值。可以看到,在最后的平均得分上,bitfit可以达到全参数微调的水平,甚至超过全参数微调。

全量微调能动的参数更多,但这张表比的是测试集上的分数。训练数据不多的时候,只调偏置有时反而更好。

第二个表格做了一系列消融实验,来探究到底在哪些层做bitfit的性价比最高。作者发现,在Wq矩阵的全连接层,和将特征维度从N放大到4N的全连接层,在这两个层做bitfit,参数变化最明显。

可训练参数计算

我用一个1.3B的模型来做实验,模型的名称是Langboat/bloom-1b4-zh,模型参数量是1303111680,BitFit参数增量是544768。怎么计算出来的呢?这个模型一共有24个transformer层,hidden_size=2048。在每一个transdormer层中,Wq/Wk/Wv/Wo的bias神经元数量是4*2048,从h到4h的bias的神经元的数量是4*2048,从4h到h的bias的神经元的数量是2048,两个layernormalization层的神经元的数量是2*2048.这样就有11*24*2048个可训练参数。再加上词嵌入后的归一化和模型末尾的归一化,各有2048个偏置参数,一共有11*24*2048+2*2048=544768个训练参数。

显存分析

batchsize=1,max_length=140。加载模型后,显存是5817M。开启训练后,显存冲到了6981M,增量是1164M。

上篇文章讲到的lora的显存增量是可训练参数的1000倍。但这里的显存增量是两千倍(1164M/0.54M≈2000),似乎有点迷。我还没有找出哪些层占用了大量显存。

(参考文章:分析transformer模型的参数量、计算量、中间激活、KV cache - 回旋托马斯x的文章 - 知乎 https://zhuanlan.zhihu.com/p/624740065)

IA3

简介

接下来介绍ia3。ia3的原理是,对激活值乘以权重。这里的激活值,理论上可以是任何层的激活值。举个例子,在全连接层中,原本的激活值是y=ReLU(Wx+b),假设y的shape是(batchsize,100),接下来,把 y 的100个数,分别乘上各自的缩放系数,缩放后的激活值作为最终的激活值。

不加入IA3:

y=ReLU(Wx+b)y=ReLU(Wx+b)

加入IA3:

y=α⊙ReLU⁡(Wx+b)y=\alpha\odot\operatorname{ReLU}(Wx+b)

代码实现

和lora的实现类似,需要借助peft库

from peft import IA3Config, TaskType, get_peft_model
config = IA3Config(task_type=TaskType.CAUSAL_LM,
                   target_modules=['query_key_value', 'mlp.dense_4h_to_h'],
                   feedforward_modules=['mlp.dense_4h_to_h'])
model = get_peft_model(model, config)

代码中,target_modules指的是需要介入的层的名称。在上面的代码中,target_modules=['query_key_value','mlp.dense_4h_to_h'],query_key_value指的是所有层的Wq/Wk/Wv矩阵,mlp.dense_4h_to_h指的是所有transformer层中的将特征维度从4H缩小到H的全连接层。

可训练参数计算

经过这样操作之后,接下来手动计算一下可训练的参数量为多少。

仍然以Langboat/bloom-1b4-zh为例,模型的参数量是1303111680,这个模型一共有24个transformer层,hidden_size=2048。在每一个transdormer层中,Wq/Wk/Wv/的激活值的shape是(batchsize,2048),对应的ia3的增量参数量是3*2048;在从4h到h的全连接层中,缩放的是输入,所以这一处有8192个缩放系数。那么在一个transformer层中,ia3的参数增量是7*2048。24个transformer层,参数增量是24*7*2048=344064.

344064/1303111680=0.00026,大约是万分之三的水平。在lora、bitfit、ia3这三种参数微调方法中,这种方法的可训练参数是最少的

下图是模型结构,两个红框显示的是增加的ia3层。

原文配图

参照bitfit的实验,ia3的实验结果显示,开启训练后显存的增量也是1G左右。

原论文在 K、V 的输出,以及第二个前馈线性层的输入乘上缩放系数。上面这个 BLOOM 例子用的是合在一起的 Q、K、V,所以 Q 也一起缩放了。

回忆一下,lora中,作者建议的注入地方是q和v;bitfit中,作者建议的注入地方是q和h到4h的全连接层;这里建议注入的地方是k、v和4h到h的全连接层。这些都是实验得出的结果,能不能从直觉解释呢?我暂时没有好的想法。

优点

1.IA3 通过大幅减少可训练参数的数量(万分之三的级别),使微调更加高效。原论文的实验里,IA3 在一些任务上的表现能和全量微调打平。

2.原始的预训练权重保持冻结状态,这意味着可以拥有多个轻量级、便携式 IA3 模型,用于在其之上构建的各种下游任务。比如,任务A中是一套IA3 参数,任务B中是另一套IA3 参数,IA3就像插件一样,根据任务的不同,来选择不同的参数。

3.如果把这些缩放系数合进原模型的权重,推理时就不用单独做这一步缩放。

按前面的表,IA3 是增加额外参数,BitFit 是选一部分参数更新,LoRA 是重参数化。这三种方法都只需要另外保存一小部分参数;推理时,BitFit 直接用更新后的偏置,LoRA 和 IA3 则可以先把改动合进原权重。


原文配图
增加额外参数(A)选取一部分参数更新(S)重参数化(R)


Prompt Tuning引言

接下来讨论prompt tuning。首先提出两个问题:什么是prompt tuning?为什么会提出prompt tuning?

Pre-training + Fine-tuning 模式的前世今生

2017年谷歌提出了里程碑意义的transformer,它由编码器(encoder)和解码器(decoder)两个部分组成。基于此架构,谷歌后来发展出了BERT,它主要关注于编码器的能力。而OpenAI则选择专注于解码器,发布了GPT。


原文配图


在2019年,自然语言处理领域的一个重要趋势是采用预训练和微调(Pre-training + Fine-tuning)的范式。其实在CV领域,Pre-training + Fine-tuning也是主流的训练范式——先在ImageNet预训练,让模型学到通用的视觉特征,然后再在特定的任务和数据集上微调。

Pre-training + Fine-tuning模式由两个阶段组成。

阶段一是预训练阶段,使用大规模无监督语料库来训练通用的预训练语言模型(PLM),此时尚未设定特定任务目标。这一阶段的目的在于使模型掌握语言的基本特征,例如,语法、上下文关联及词义等。

阶段二是微调阶段,我们将经过预训练的模型应用于具体的下游任务,使模型适应这些具体的任务,如情感分析、问答系统或文本分类等。在微调过程中,模型的参数会被针对性地调整以适应特定的任务。

我们可以通过一个实际的例子来详细说明。正如下图所演示的那样,这是BERT预训练阶段的任务之一——即完形填空任务。考虑原句“the cat sat on the mat”,模型首先随机遮盖掉一些词汇,在本例中,“cat”被掩盖并用“mask”占位符替代。句子经过embedding嵌入处理后,送入transformer的编码器层。最终,我们取出替代了“mask”的部分的输出,通过一个softmax分类器来让模型预测被掩盖的词是“cat”。


原文配图


做这个任务,醉翁之意不在酒,并不是简单地让模型学会做完形填空。,而是通过参与这一任务来促使模型学会洞察词汇之间的上下文联系以及把握语法结构等更深层次的语言特性。

一旦模型训练完成,我们就可以提取嵌入层(embedding layer)和编码器(encoder)的参数,这些即构成了我们的预训练模型。如果后续有下游任务,例如情感分类,我们仅需将预训练的嵌入层和编码器引入,并在模型的顶层(head)叠加一个或数个线性层(linear layers)以输出概率值,并从这个结构开始微调。


原文配图

Pre-training + Fine-tuning 模式的优缺点

这种模式在诸多任务的表现上超越了传统的监督学习方法,不论在工业生产、科研创新还是竞赛中均作为新的主流方式。以下是优点:

(1)转移学习能力: 预训练阶段像是在塑造一个全能选手,让AI模型吸收了海量与任务无关的知识,这些知识随后能转用到各种具体任务上,即便在数据不足的情况下也能大显身手。

(2)提高效率: 微调比从头开始训练模型要快得多,因为预训练阶段已经提供了良好的起点。

(3)性能: 预训练+微调通常能在多种NLP任务上获得良好的性能,因为预训练阶段捕捉了广泛的语言特性,微调阶段针对特定任务精准打磨。

(4)降低数据需求: 微调阶段不需要大量的标注数据,依赖的更多的是预训练阶段的知识积累。

然而,这套模式也存在着一些问题。

(1)跨域适应性问题:如果一个下游任务跟预训练时的数据差异很大,模型可能难以适应新任务。

(2)大模型微调的计算成本高:从计算角度看,尽管这种方法在中小型模型上表现尚可,但对于大型模型,fine-tuning所需的计算成本会非常高。如果没有引入参数高效微调的解决方案,fine-tuning实际上等同于对整个模型进行再训练——这在计算资源有限的情况下是行不通的。

(3)过拟合的风险:如果微调数据集较小,模型可能在微调阶段过拟合到训练数据,降低了模型的泛化能力。

(4) 缺乏灵活性:每接收到新任务就需要重新微调,这对资源和时间都有要求,缺乏灵活性。

promt tuning的提出

以上四个缺点,哪个缺点是最大的痛点?我个人认为是第一点。为什么?因为其他几个问题或许可以通过堆硬件或者找技术突破来解决。比如计算成本过高,咱们可以升级硬件,或者采用LoRA等技术降低微调的负担;过拟合?增加更多的数据就行了。至于灵活性不足,看似是一个独立的问题,实则和跨域适应问题是同根同源的。如果下游任务和预训练之间的差距能够减小,或者说微调和预训练的任务目标能够接近,不仅可以解决其他三个缺点,而且在整个深度学习范式上,会有突破性的意义。

接下来讲另一种省参数的办法:Prompt Tuning。

Promt Tuning

概念

GPT-3 用过人写的提示词。这里说的 Prompt Tuning 则是把模型冻住,单独训练几组提示向量。我们先看人写的提示怎么用,后面再看这几组向量是怎么练出来的。


原文配图


例子

先看一个例子。如果有一个二分类的情感分类的任务,要判断一句话是正面情绪还是负面情绪。按照传统方式,我们会把成批数据喂给模型,最终模型输出一个值,大于0.5代表正面情绪,小于0.5则为负面情绪。这往往需要成千上万条数据,同时还得对整个模型进行微调。

但是,如果突然有一天,你需要处理一个新任务,比如命名实体识别,那你可能需要重新调整模型结构,进行新一轮的微调。就这样,每当有新任务出现时,都要重复这样的微调过程,既费力又效果未必理想。如果微调的任务和预训练阶段使用到的语料相差很远的话,基本上要更多微调数据才能达到比较好的微调效果。


原文配图


用手写的提示,可以换一种问法。以情感分类任务为例,传统的做法是把句子输入进去,然后让模型输出一个概率值,如图中左边的结构所示。换成填空的问法之后,模型的输入不仅包括原始的句子,还包括了一个template(模板),在这个例子中,template被加到了句子的后面。

I love this movie.Overall, it was a _ movie.这句话中,I love this movie.是原始句子,Overall, it was a _ movie.是template。这两个句子合在一起,被送进模型中,让模型做完形填空的任务。这个时候,模型输出的就不是一个概率值了,而是每个词汇的概率值,然后我们选出概率最高的那个词。比如,模型的输出是“nice”或者“good”或者“fantastic”,那么我们就认为这个句子的感情是正向的。

换言之,我们用完形填空的方式来解决原本的二分类问题。

如果换一个模板,比如“这句话的情感是__”,那就转变成了一个生成任务,用生成的方式来解决分类问题。

或者,如果我们把模板改为“The Chinese translation of this sentence is_”,是不是就实现了一个机器翻译的任务?

这样就不用每次换任务都先去改模型结构,可以先试着换个模板。


原文配图


原文配图


手写提示怎么做分类

做分类的时候,这里有两步:

构建模板(Template Construction):选择合适的模板来指示模型需要执行的任务。它直接告诉模型预期的回答类型。例如,在情感分析任务中,提示可能是 “这篇评价是积极的还是消极的:”。设计有效的提示是很重要的,因为它可以显著影响模型的性能。就像例子中的“Overall, it was a _ movie”,这个模板是人为构建的,而且构造模板有许多方法和策略,接下来会进一步讲解。

下图是一些常见任务的模板:


原文配图


例如,在文本摘要任务中,我们采用的是以下结构的指令和模板:“Context: [x]。Abstract: __”,其中x代表我们希望提炼摘要的原始文本。在传统的方法中,我们通常将x直接输入到一个专门的文本摘要模型中,从而获得生成的摘要。然而,在这里,我们将包含x的完整模板直接送入模型,并不要求这个模型必须是经过特定微调的文本摘要模型。实际上,这样的模型有可能跟其他类型的任务所使用的模型相同,例如情感分类。通过简单更换模板,我们得以使用同一模型来完成不同的任务。

标签词映射(Label Word Verbalizer):verbalizer定义了类别标签和模型预测词之间的映射关系。以情感分类为例,模型可能输出像“good”、“nice”、“fantastic”这样的词,我们可以很容易地判断出它们都是正向的情绪。然而,我们最终只关心情感是正面还是负面,不在乎具体用了哪个词。标签词映射正好用于此,它帮助我们定义哪些词应该映射到正面情绪,哪些应映射到负面情绪。

Hard Prompt

如果模板是由人工生成的,那么这种模板就被称为hard prompt,又称硬提示。人工设计的模板没有统一客观的标准。同样的意思,可能有不同的表述。比如“请回答这句话表达的情感:____”,“这句话的情感是____”,“这句话表达的情感是____”。

既然是人工生成的,那就要依赖设计者的经验。而且并不是说经验越足,设计出来的模板就越好。AI毕竟还是一个黑盒,人类认为不错的模板对于LM来说不一定是一个好的模板。

让我们举个例子。下图展示了四种不同的提示模板,虽然它们背后的意图一样,但是在评测中得到的分数却相差很大,有的只有19分,而有的高达51分。


原文配图


而且hard prompt并没有引入新的训练参数,没有独立的训练过程。从某种意义来说,你可以把它理解为in-context learning。因为它和in-context learning一样,都不会涉及到对模型参数的修改或更新。

Soft Prompt

手写的提示靠人挑词。软提示(Soft Prompt)换了个办法:把提示的向量当成参数,用任务数据去训练。练出来的是几组数字,不一定对应任何一个词。

具体来说,关于Prompt tuning的方法有三种:Prompt tuning、P tuning和Prefix tuning。我不禁想吐槽一下这些术语的杂乱无章。比如“长沙市里有长沙县”,“吉林省里有吉林市”,容易让人混淆。当然了,AI尚是一个年轻的学科,这种术语混乱也是可以理解的。

下面是我从PEFT库源码中截的一个片段。PEFT库是专门用于模型参数(P)高效(E)微调(FT)的库,可以看到这里有三个if分支,分别对应的是三种Prompt tuning的方法。


原文配图


prompt tuning

如下图所示,蓝色的区域是预训练模型,自始至终预训练模型不需要训练。黄色的地方是新增的地方。


原文配图


举个具体的例子来说明。假如input是“我喜欢这部电影。”,input经过分词后的长度是8,模型的hidden_size是2048,那么input经过embedding层后shape将是[1,8,2048],然后再送到transformer模块做注意力运算。这是传统的做法。


原文配图


prompt tuning有两种策略,第一种会指定初始参数,第二种不指定。指定初始参数的情况下,我们会手工提供一个模板,并使用这个模板的Embedding作为初始参数。举个例子,我手工设计了这句话作为模板——“请回答这句话的情感倾向。”假设这个模板经过分词后的长度为11,经过embedding层后shape是[1,11,2048],然后,我们将模板的Embedding与输入的Embedding([1, 8, 2048])拼接在一起,形成[1, 19, 2048]的张量,再送入网络中处理。


原文配图


template的embedding层的参数量是多少?是11*2048。这个11*2048是怎么来的?是从原本的32000*2048的词汇表(假设词汇表一共有32000个token)抽出来的。模板是“请回答这句话的情感倾向。”,首先,第一个token是“请”,假如“请”在词汇表的第177行,那么就先取出第177行的那一行的1*2048的tensor出来。剩下的以此类推,组成了11*2048的tensor,这就是模板的embedding层的初始参数。

这个11*2048就是要额外训练的参数,可以看到非常非常小,只有两万多。比起现在的动不动几十B的大模型来说,不值一提。这就是为什么这种方式被称为“参数高效微调”的原因。

顺带提一句,如果我们不对这些额外的Embedding层参数进行训练,那么其实就退化成了硬提示的情况。

之前提到prompt tuning有两种策略,第一种会指定初始参数,第二种不指定。它有一个参数是num_virtual_tokens,比如说我设置成11的话,它会假定有一个长为11的虚拟句子作为输入。其实你可以这么理解:刚刚11*2048的参数矩阵是从原始的32000*2048词汇表里抽出来的(抽11行出来),抽出来的规则是根据你提供的初始模板。若不指定,那么这些参数将会是随机生成的。

大家觉得指定初始参数更好,还是不指定更好?一般来说,指定了初始参数,相当于给模型注入了先验知识,在训练资源有限的情况下,这通常是更优的选择。

p tuning

Prompt Tuning这种方法通过加入极少量可训练的参数来引导预训练模型完成新任务,然而在某些情况下,这种方式效果可能并不理想。P-Tuning 也训练提示向量,但它多用一个小网络来生成这些向量,比如用线性层或 LSTM。

这张图片显示了在template的embedding层后面,新增加了两个线性层。其他结构和prompt tuning的情况一致。


原文配图


我们可以总结一下prompt tuning和p tuning,本质上,是在原始的input的前面,增加一个template,这个template可能是我们指定的,也可能是虚拟的。input和template各自经过embedding后,会被拼接在一起,再送到transformer的网络中去。也就是说,这里的关键就在于Embedding阶段为模型增加了额外的小组件。

我使用了Tesla V100显卡和1.3B参数的Bloom模型来测试。加载好模型后,显卡内存是5871M,我设置的seq_length=138, batchsize=1。开始训练后,不论是prompt tuning还是p tuning,都会导致大约1G左右的显存增加。

prefix tuning

我们再来总结一下,以num_virtual_tokens=11为例,prompt tuning是在embedding阶段额外增加了一个参数量为11*2048的embedding层。ptuning则是在prompt tuning的基础上,在template的embedding阶段,增加了加上两个线性层或者LSTM层。

prefix tuning,有两个步骤:

(1)在embedding阶段,增加一个参数量为11*98304的embedding层。

(2)将embedding层后的结果,以kvcache的形式嵌入到各个transformer层里。(而不是像prompt tuning和p tuning一样,和原来的input concat起来,送到transformer block里)

步骤一

在embedding阶段,增加一个参数量为11*98304的embedding层。这里的98304是怎么来的?我当前的用来举例的模型一共有24个transformer层,hidden_size是2048,2*24*2048=98304.这里的2048是每层 K 或 V 的宽度。换模型时,要用那个模型实际的 K、V 宽度来算。至于为什么是这些值相乘,我待会在讲kvcache的时候会说明。

在这个步骤里,还有一个替代方案是一个11*2048的embedding层,然后接着再加上2048*98304的线性层,也能生成同样的shape(11*98304)。当然,你也可以魔改,两层三层MLP都行,或者LSTM也行。只要shape能对得上。

步骤二

步骤二是将embedding层后的结果,以kvcache的形式嵌入到各个transformer层里。要讲清楚步骤二,要先讲清楚kvcache。kvcache一两句话讲不清楚,我在这里就先不展开了,因为这不是本次分享的重点。但kvcache的核心思想是用空间换时间。举个例子,给模型输入“我爱美丽的长”,这六个字并预测下一个字“江”的过程中,模型要对6个token来做运算。能不能只对“长”字来运算呢?可以,只要把前五个字蕴含的key和value的信息先存储起来,和“长”一起输入到网络中,模型只会对“长”字来运算,结合kvcache,得到“江”的预测。两种方式是完全等价的。kvcache的时间显著提升很多,因为它的输入只有一个token,但是作为代价,存储kvcache需要用到大量的内存。

kvcache具体要存储多少信息呢?要存的数有 batchsize×seq_length×层数×2×每层 K 或 V 的宽度(按 K、V 一样宽、每层宽度一样来算)。每个token产生的key和value都要储存下来。这里的2,指的是key和value。seq_length,指的是当前的序列的长度。比如生成到“我爱美丽的”时候,token数为5,此时seq_length=5.然后生成到“我爱美丽的长”时候,token数为6,此时seq_length=6.也就是说,kvcache里的数量,是随着生成的过程而递增的。

如果你现在还不懂 kvcache 的具体细节,可以先按上面的乘法来算。套在我们的prefix tuning上,batchsize这里是1,seq_length是11,等于num_virtual_tokens,因为prefix tuning和prompt tuning一样,首先把一段template加在原本的input的前面,因此seq_length就是11.leyers=24,hidden_size=2048。那么相乘就是11*2*24*2048.

步骤一中的embedding层的参数量是11*98304,这是可以对得上的。


原文配图


具体的步骤是,步骤一中的embedding层,经过reshape操作,拆分成11*2*24*2048的kvcache的格式(当然不一定是这种格式,不同的模型有不同的实现),送到网络中去。

平时推理用的 KV cache,是把已经算出来的 K 和 V 存下来。Prefix Tuning 则是在训练时就给每层塞一小段前缀;训练更新的是这段前缀的参数。

显存增量

prompt tuning和p tuning的显存增量是1G,在同样的条件下,prefix tuning的显存增量是4G.prefix tuning的可训练的参数量显著比前两者更高。

本质

改模板可以把分类题变成填空题。Prompt Tuning 还多一步:用这项任务的数据把提示向量练出来。练的时候原模型不动,推理时把练好的提示向量和原输入一起交给模型。


原文配图


参考资料

视频资料

【【手把手带你实战HuggingFace Transformers-高效微调篇】P-Tuning 原理与实战】 https://www.bilibili.com/video/BV17V411N7Ld/?share_source=copy_web&vd_source=97da61a87d5a14ca15b351252ae0f105

图文资料

五万字综述!Prompt-Tuning:深度解读一种新的微调范式 - kaiyuan的文章 - 知乎

https://zhuanlan.zhihu.com/p/618871247

提示学习Prompt Tuning:面向研究综述 - HeptaAI的文章 - 知乎

https://zhuanlan.zhihu.com/p/524383554

Prompt-Tuning - 窥探的文章 - 知乎

https://zhuanlan.zhihu.com/p/653216715

知乎原文

探究RoPE(旋转位置编码)中的远程衰减性

在初看RoPE的时候,不理解为什么theta的取值方案会造成远程衰减性。

theta的取值方案指的是 θi=10000−2i/d\theta_i=10000^{-2i/d}

这里的远近,说的是两个 token 在序列里隔了多少位置。

如下图所示,横轴是 key 的位置,query 固定在第 0 个位置。这张图把 q 和 k 的每一维都设成 1,纵轴画的是 softmax 前的缩放点积分数。隔得越远,分数整体在往下走,中间也会反弹。换一组 q 和 k,就不一定是这个样子了。

原文配图

代码来源于( @Soaring 旋转式位置编码 (RoPE) 知识总结 - Soaring的文章 - 知乎 Soaring:旋转式位置编码 (RoPE) 知识总结)

import numpy as np 
import matplotlib.pyplot as plt 
from matplotlib.axes import Axes

def create_sin_cos_cache(max_num_tokens, head_size):
    theta = 10000 ** (-np.arange(0, head_size, 2) / head_size)  #(128,)
    # theta = np.ones(head_size//2)
    theta = theta.reshape(-1, 1).repeat(2, axis=1).flatten()  #(256,)

    pos = np.arange(0, max_num_tokens) #(512,)
    table = pos.reshape(-1, 1) @ theta.reshape(1, -1)  # [max_num_tokens, head_size] 512*256

    sin_cache = np.sin(table) #(512, 256)
    sin_cache[:, ::2] = -sin_cache[:, ::2]

    cos_cache = np.cos(table)
    return sin_cache, cos_cache

def rotate_half(vec):
    return vec.reshape(-1, 2)[:, ::-1].flatten()

def rotary(vec, pos, sin_table, cos_table):
    #vec.shape=256,是原始的q向量(q=Wx),
    #rotate_half(vec) 是处理过后的q向量
    #cos_table.shape=512*256
    return vec * cos_table[pos] + rotate_half(vec) * sin_table[pos]

def plot(plt_obj: Axes, pic_index, query_index=0, head_size=256, max_num_tokens=8192, step=1):
    q_vec = np.ones(head_size) #(256,)
    k_vec = np.ones(head_size) #(256,)
    sin_table, cos_table = create_sin_cos_cache(max_num_tokens, head_size) #(512, 256), (512, 256)

    rotated_q_vec = rotary(q_vec, query_index, sin_table, cos_table) #(256,)
    #如果query_index=0,则rotated_q_vec全为1
    #rotated_q_vec 是旋转后的q,即波浪q
    k_indices = np.arange(0, max_num_tokens, step) #(512,)
    rotated_k_vecs = rotary(k_vec, k_indices, sin_table, cos_table) #(512, 256)
    attn_scores = (rotated_k_vecs @ rotated_q_vec) / np.sqrt(head_size) #(512,)

    plt_obj.plot(k_indices, attn_scores)
    plt_obj.set_title(f"Figure {pic_index}: query_index={query_index}, head_size={head_size}")
    plt_obj.set_xlabel("key index")
    plt_obj.set_ylabel("attention score")

plt.rcParams.update({
    "font.sans-serif": ["Times New Roman", ],
    "font.size": 10
})

_, axes = plt.subplots(nrows=2, ncols=2, figsize=(10, 10))
plot(axes[0, 0], 1, query_index=0, max_num_tokens=256)
# plot(axes[0, 1], 2, query_index=32, max_num_tokens=128)
# plot(axes[1, 0], 3, query_index=0, max_num_tokens=6553)
# plot(axes[1, 1], 4, query_index=0, head_size=8, max_num_tokens=65535)

远程衰减性描述的是token之间的关系,而theta的取值方案仅仅是针对单个token内部,给不同的embedding位置赋予不同的值。为什么theta的取值方案会影响token之间的关系呢?

我把我的探究写出来,希望大家指正。


首先,按照RoPE的定义, qm=WQxmq_m=W_Qx_m

q̃m=R(m)qm\tilde{q}_m=R(m)q_m

=[q0q1q2q3⋮qd−2qd−1]⊗[cos⁡mθ0cos⁡mθ0cos⁡mθ1cos⁡mθ1⋮cos⁡mθd/2−1cos⁡mθd/2−1]+[−q1q0−q3q2⋮−qd−1qd−2]⊗[sin⁡mθ0sin⁡mθ0sin⁡mθ1sin⁡mθ1⋮sin⁡mθd/2−1sin⁡mθd/2−1]= \begin{bmatrix}q_0 \\ q_1 \\ q_2 \\ q_3 \\ \vdots \\ q_{d-2} \\ q_{d-1} \end{bmatrix} \otimes \begin{bmatrix}\cos m\theta_0 \\ \cos m\theta_0 \\ \cos m\theta_1 \\ \cos m\theta_1 \\ \vdots \\ \cos m\theta_{d/2-1} \\ \cos m\theta_{d/2-1} \end{bmatrix} + \begin{bmatrix}-q_1 \\ q_0 \\ -q_3 \\ q_2 \\ \vdots \\ -q_{d-1} \\ q_{d-2} \end{bmatrix} \otimes \begin{bmatrix}\sin m\theta_0 \\ \sin m\theta_0 \\ \sin m\theta_1 \\ \sin m\theta_1 \\ \vdots \\ \sin m\theta_{d/2-1} \\ \sin m\theta_{d/2-1} \end{bmatrix}

假设所有的 qmq_m 和 knk_n 都是ones向量

那么可以简化成

q̃m=[cosmθ0−sinmθ0cosmθ0+sinmθ0cosmθ1−sinmθ1cosmθ1+sinmθ1⋮cosmθd/2−1−sinmθd/2−1cosmθd/2−1+sinmθd/2−1]\tilde{q}_m=\begin{bmatrix}cos m\theta_0-sin m\theta_0 \\cos m\theta_0+sin m\theta_0 \\ cos m\theta_1-sin m\theta_1 \\cos m\theta_1+sin m\theta_1\\ \vdots \\cos m\theta_{d/2-1}-sin m\theta_{d/2-1} \\ cos m\theta_{d/2-1}+sin m\theta_{d/2-1}\end{bmatrix}

由于我们要考虑第0个query和第n个key的内积,首先求得

q̃0=[1111⋮11]\tilde{q}_0=\begin{bmatrix}1 \\ 1 \\ 1 \\ 1 \\ \vdots \\ 1 \\1\end{bmatrix}

不难得出,<q̃0,k̃n>=2∑i=0d/2−1cosnθi<\tilde{q}_0,\tilde{k}_n>=2\sum_{i=0}^{d/2-1}{cosn\theta_i}

(我省略了缩放操作)

我先做了一些看起来无聊的探究:

(1)如果对于任意 ii , θi=0\theta_i=0 ,那么对于任意 nn ,有 <q̃0,k̃n>=d<\tilde{q}_0,\tilde{k}_n>=d ,也就是说不同token之间的注意力都是相等的。

对应的代码是

theta = np.zeros(head_size//2)

得到的图像是:

原文配图

注意,d=256,代码加了缩放操作,导致图中的注意力是256/16=16


(2)如果对于任意i, θi=1\theta_i=1 ,那么

$<\tilde{q}_0,\tilde{k}_n>\\=2\sum_{i=0}^{d/2-1}{cosn}\\=dcosn$

周期是6.28左右

对应的代码是

theta = np.ones(head_size//2)

得到的图像是:

原文配图

可以数一下,大概周期是6左右

(3) θi=10000−2i/d\theta_i=10000^{-2i/d} ,考虑d=4的情况

<q̃0,k̃n>=2∑i=0d/2−1cosnθi=2cosn+2cos(0.01n)<\tilde{q}_0,\tilde{k}_n>=2\sum_{i=0}^{d/2-1}cosn\theta_i=2cosn+2cos(0.01n)

如果把横轴看成连续的,这个例子的周期约为 628;图里只取整数位置。

原文配图

以上是一些特殊情况。一般地, θi=10000−2i/d\theta_i=10000^{-2i/d}

<q̃0,k̃n>=2∑i=0d/2−1cosnθi<\tilde{q}_0,\tilde{k}_n>=2\sum_{i=0}^{d/2-1}cosn\theta_i

为什么这个内积会随着n的增大而震荡减小呢?

前面把转速都设成 1 时,这些余弦一起涨、一起跌。现在转速有快有慢。离得近的时候,大部分项还在 1 附近;离远一点,转得快的项已经有正有负,加起来就会抵消一部分。再往远处走,转得慢的项也开始错开。这就是为什么图上总体往下,中间却会反弹。

知乎原文

大模型中的涌现

什么是涌现

前言

我曾经有一篇文章(武辰:混沌、复杂网络、自我指涉与生命游戏)提到了涌现。今天说说AI大模型中的涌现。

什么是涌现?先从蚂蚁开始说起。蚂蚁是自然界中一种个体非常简单,但是群体能力非常强大的生物。单只蚂蚁的行为模式很简单,但是蚂蚁群体可以发挥出惊人的智慧,能完成非常复杂的任务,比如建造庞大的蚁穴、合作捕猎等。

一只蚂蚁的智能是有限的,但是一群蚂蚁结合起来,会形成一个有智能的群体。这种集体智慧并不是蚂蚁个体简单相加得到的。蚂蚁集合在一起,产生了一加一大于二的效果。这就是涌现现象。

涌现的定义

如何给涌现下一个定义呢?我问了GPT,GPT给我的回答是:

涌现是指在复杂系统中,由于各个组成部分之间的相互作用和协同作用,导致系统整体表现出来的性质和行为,这些性质和行为无法简单地从各个组成部分的性质和行为中推导出来。涌现现象在自然界和社会科学中广泛存在,例如蚁群、鸟群、交通拥堵、金融市场等。涌现现象的研究对于理解复杂系统行为和设计有效的控制策略具有重要意义。

我想用更加通俗的说法来描述涌现:大量个体组成的整体,表现出个体不具备的能力。注意三个关键词,大量、整体、个体不具备,这三个关键词缺一不可。

涌现,是复杂科学下的一个概念。什么是复杂科学?复杂科学,就是运用跨学科方法,研究不同复杂系统之中的涌现行为和统一性规律的学科。复杂科学有很多定义,这个定义我觉得是最通俗的。如果你觉得还不通俗的话,我列几个关键词:混沌、分形、复杂网络、自由意志、熵增。大家看到这些关键词,应该可以对复杂科学有大概映像。

原文配图

复杂科学与还原论

你可能会觉得,这研究的都是啥玩意啊?是不是民科啊?是不是神棍啊?如果你有这样的感觉,我非常理解。因为复杂科学的很多概念,起初不被主流科学界认可。很多人认为复杂科学里的很多概念是伪科学,是因为它无法用科学里流行的还原论来解释。还原论是说“如果你理解了整体的各个部分,以及把这些部分整合起来的机制,你就能够理解这个整体”。但涌现不是这样,涌现指的是,整体拥有个体不具备的特征。

我再举个简单的例子:假如时间回到20年前,我们不知道怎么造航空母舰。突然间我们获得了一艘退役的航空母舰,于是我们把航空母舰拆开,每个部分每个零件都去研究透彻。然后我们依葫芦画瓢,可以造出一艘几乎一样的航空母舰。这就是还原论。还原论的对立面是什么?是即使你研究透每一个零件,拼在一起仍然不能组成航空母舰。这是坏的情况。或者另外一个极端情况是,你拼接好了,组成一艘航空母舰之后,不仅成功造了一艘航空母舰,而且这艘航空母舰竟然还会说话。这就是涌现。

我们现有的科学框架是基于还原论的。最近十几年来横空出世的复杂科学,挑战了还原论的地位。所以复杂科学的很多概念都不被认可。而且说一句题外话,一旦一门学科有玄学的意味在里面,很容易被乱七八糟的迷信思想蹭热度。比如说量子力学,可以说是重灾区。很多迷信思想都打着量子科学的旗号甚嚣尘上,大张旗鼓地诈骗。举一个简单的例子,十几年前有一个很流行的心灵鸡汤,说有相同的三束花,第一束花,你天天去赞美它,第二束花,你天天去骂它;第三束花不管不问。七天后,只有第一束花还在盛开。有人解释说这是因为在量子层面有频率共振。这不扯淡吗?同样地,包括涌现在内的复杂科学的很多概念也在慢慢被滥用。我觉得大模型领域中的涌现就是滥用的典型代表(仅仅个人意见)。

我再想说一些哲学的思考。一个神经细胞,看起来功能比较简单。但是几十亿个、几万亿个神经细胞联系在一起,就形成了我们人类复杂的意识,那么我们能不能从这个角度去出发,来创造一个人工智能呢?

整个宇宙,至少目前探明的已经有几万亿亿亿颗星星,那这些如果说我们把每一个星星当作一个神经细胞的话,这么多的东西组合一起,会不会发生涌现呢?也就是说,整个宇宙会不会就是一个巨大的生命体呢?而我们地球只是这个巨大的生命体中的一个小小的细胞?

涌现广泛出现在各个领域

化学可以被看作是物理定律的涌现。生物学可以看作是化学定律的涌现。心理学可以被理解为生物学的涌现。经济学可以看成是心理学的涌现。

大模型中涌现的定义

首先声明:涌现虽然在系统科学和复杂科学里有严格且良好的定义,但是因为其被滥用、在计算机领域模糊的套用以及其他原因,(我个人认为)涌现仍然具有一定的玄学色彩。深度学习没有严格的数学基础,更是被冠以“玄学炼丹”的标签。今天要讲的大模型的涌现现象,就是“涌现”和“深度学习”两种不同领域的玄学标签融合在一起。希望大家用包容且批判的角度来看待。

什么是大模型中的涌现?在较小的模型中不出现,而在较大的模型中出现的能力,称为涌现。

原文配图

我们看这张图片,它包含8张子图。分别在是八个不同的子任务下测试大模型的few-shot的能力。横轴是模型的规模(注意这里是用training FLOPs来衡量,而不是用参数量来衡量),纵轴的模型的表现,用一些评估指标来衡量,比如accuracy。图上几项任务都出现了分数突然抬高的情况。换个任务,抬起来的位置也会变。

第一篇整体分析LLM涌现能力的人是jason wei,在此之前,他先后发表了instruction tuning和CoT(思维链)的论文。这个顺序关系很自然,先是instruction tuning,然后是思维链,最后上升到了涌现的高度。关于instruction tuning和CoT,也是值得讲的内容,后面看有没有机会分享这些方面的内容。

衡量模型规模的指标

这部分会涉及到数学公式。如果没有看懂可以跳过。

transformer参数计算

我们知道现在所有的大模型都是以transformer为基础的。我之前分享过手撕transformer的内容。transformer模型由L个相同的层组成,每个层分为两部分:self-attention块和MLP块。

(1)首先看self-attention块,有四个矩阵参数——Wq/Wk/Wv/Wo,假设隐藏层的嵌入维度是h,那么参数量是4*h*h。偏置项的参数量是h的一次函数,在二次函数面前,可以不考虑。

(2)然后看MLP模块,MLP由两个全连接层组成。第一个全连接层是从h映射到4h,参数量是h*4h,第二个全连接层是从4h映射到h,参数量是4h*h。偏置项可以不考虑。

两者加起来,参数量一共是12*h*h。

至于layernormalization、嵌入层之类的层,同样是关于h的一次函数,不考虑。

于是,如果一个模型一共由L个transformer层,那么这个模型的参数量大概是12Lhh。

(参考文章:分析transformer模型的参数量、计算量、中间激活、KV cache - 回旋托马斯x的文章 - 知乎 https://zhuanlan.zhihu.com/p/624740065)

根据这种方法估计的参数量和实际的参数量没有太大出入,如下图所示。

原文配图

transformer显存计算

在训练神经网络的过程中,占用显存的大头主要分为四部分:模型参数、前向计算过程中产生的中间激活(先不考虑)、后向传递计算得到的梯度、优化器状态。

在一次训练迭代中,每个可训练模型参数都会对应1个梯度,并对应2个优化器状态(Adam优化器梯度的一阶动量和二阶动量)。

float32数据类型的元素占4个bytes。对于每个可训练模型参数,至少占用了4+4+8=16bytes(这里是至少,真实情况更复杂一些)。这个数再乘以参数量,比如7B,就是显存。我们可以算一下,16bytes*7 000 000 000(参数量)/1 000 000 000 = 112G,我们真实训练一个7B模型的显存大概是140G左右。

transformer的FLOPs计算

FLOPs(floating point operations)表示浮点数运算次数,衡量模型计算量的大小。我们可以近似认为:在一次前向传递中,对于每个token,每个模型参数,需要进行2次浮点数运算,即一次乘法法运算和一次加法运算。一次训练迭代包含了前向传递和后向传递,后向传递的计算量是前向传递的2倍。因此,对于每个token,每个模型参数,需要进行6次浮点数运算。对于GPT3,模型参数量为 174600M,训练数据量为 300B,那么FLOPs是:6*174600*10^6*300*10^9=3.1428*10^23

注意,这里包括了训练集所有的数据量。也就是说,衡量模型大小,并不仅仅是参数,还要考虑到数据集的大小。

其实FLOPs和参数量呈现比较强的正相关关系。因为衡量模型大小和涌现关系的时候,有时候也会用模型参数量去衡量。

大模型涌现能力的具体表现

In-context learning

In-context learning的能力,指的是不更新模型参数的条件下去学习的能力。比如我们说的zero-shot、one-shot、few-shot。我这里举一个例子来展示大模型的one-shot或者few-shot的能力。

one-shot

原文配图

few-shot

原文配图

小模型没有In-context learning的能力。但是大模型表现出了强大的In-context learning的能力。

CoT(思维链)

原文配图


这是在数学问题下的模型的表现随着参数量变化的统计图,可以看出也存在涌现现象。尤其是中间这一列。在这组实验里,模型变大之后,思维链提示带来的分数提升才明显起来。

模型规模与涌现能力

In-context learning

我们刚刚计算了,GPT3的FLOPs在10的23次方量级。前面那张图里,有些任务的分数在 10 的 22 次方这个量级附近就跳起来了。那其他任务也都在这附近吗?

首先看few-shot方面的表现,从图中可以看出,是否产生涌现能力,和具体的任务有关系。比如在第一个任务中,模型的大小在13B就出现了涌现。但是在WIC任务中,只有到540B才出现了涌现能力。

原文配图

所以,要问多大的模型能做好 few-shot,还得先说是哪一个任务。

CoT(思维链)

思维链也一样。图里的数字对应的是那几个模型在那几个任务上的表现,换一个任务,不一定还是这个门槛。

原文配图

大模型为什么会出现涌现?

评价指标的连续性

我们都知道,准确率(Accuracy)是很多深度学习任务的常见评价指标,也是大家发论文刷比赛主要关注的数字。但事实上,例如精确度这种指标,在很多任务上是不连续的。

举个例子,在二分类中,我们最常用的指标就是准确率。那为什么没有人把准确率用来做损失函数呢?准确率做损失函数,本质上就是0-1损失函数。如果预测值和目标值不相等,则为1,否则为0。这个损失函数特别简单粗暴,它是不连续的,根本不可导,所以不能用在以反向传播为基础的深度学习上,甚至机器学习领域也很少任务使用0-1损失,除了最原始最简单的感知机。

原文配图

针对不平滑的问题,有人提出了crossentropy.这是binary_crossentropy的公式,可以认为这个损失函数是0-1损失函数的平滑版本。举个例子,当ytrue和ypred都为1或者都为0的时候,损失函数的值是0.这一点和0-1损失函数一致。在ytrue和ypred不一致的时候,损失函数不为0,且ytrue和ypred距离越远的时候,损失函数越大。这个函数是一个连续函数,可以求导,因此是分类问题损失函数的首选。

原文配图

这就是连续性或者平滑性的定义。

连续指标和不连续指标的对比

回到我们NLP任务中,假设有一个新闻摘要的任务,ground truth=“中国队获得世界杯冠军”。使用两个评估指标,第一个评估指标是:ypred一字不差地等于ground truth。第二个评估指标是:ypred和ground truth的某种编辑距离(可以简单地理解为,根据预测结果和真实结果的相近程度,打对应的得分)。我们看不同的模型规模下,两个评估指标有什么变化。注意,下面这张表格是我编造的,我没有实际去实验,仅仅是为了举例子,让大家直观地理解评估指标产生的误导作用。

原文配图

我们可以看到,在评估指标1的视角下,模型发生了涌现,模型参数到一定规模后,评价指标突然拉升。但是能说明前面那些规模更小的模型的能力不行吗?不能,在另一个评估指标的视角下,随着模型规模的增加,生成的预测结果会慢慢向ground truth靠拢。

我再举一个例子,当然这个例子也是我编造的。假设让模型算 40+60。第一种,答对 100 就得 1 分,否则得 0 分。第二种,离 100 差多少,就扣多少分。

第一种打分,哪怕只差 1,得分也是 0,看起来就像模型突然学会了加法。换成第二种打分,才看得出它在答对之前,已经一次比一次接近 100 了。

原文配图
表格右下角的「0re」是笔误,应为 0。

相关论文的实验

这是研究人员(《Are Emergent Abilities of Large Language Models a Mirage?》 arxiv.org/pdf/2304.15004.pdf)替换评估指标后发现的规律。这是GPT模型做数学加法乘法任务的表现结果。第一排以accuracy为评估指标,可以看到,模型在10的10次方处(对应的是10B)有明显的分界线,这就是大家所说的涌现。但是如果换一个评估指标,这里用的是token编辑距离,模型表现出了平滑的、可预测的性能提升。
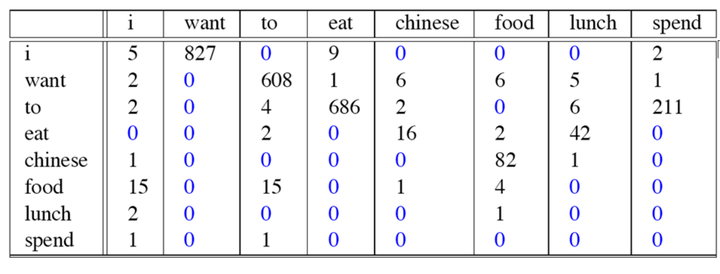

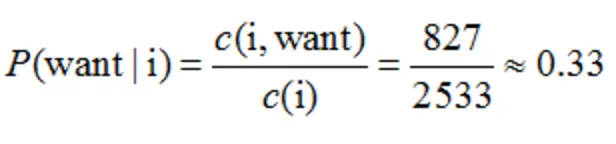
原文配图

这个实验有没有说服力呢?作者想要表述的核心观点是,模型的涌现能力不是大家鼓吹的量变到质变的结果,而是选择的度量指标误导了大家。那么作者要做实验来验证这个观点,首先自然是是把NLP里面的不连续度量换成连续的,看看模型效果还会不会涌现。这还不够。作者从另外一个角度再一次验证了他的观点,就是是把CV模型常用的连续性指标变成不连续的指标,来人为构造“涌现”的“假象”。我觉得这个思路很值得大家借鉴。
作者设计了用LeNet做手写数字的分类预测问题。连续指标依然是分类准确率;不连续指标的设计是这样的,把原来的一张图一个label的设计,变成了K个图K个label为一组,只有K个样本都预测正确的时候才算这组样本预测正确,直觉上来看这样的指标也是增加了难度。
下图展示了结果,发现在不连续指标下,模型出现了涌现能力。

原文配图


作者的角度很新颖,也提供了实验来验证他的观点。但是这能不能说明LLM的不存在涌现的结论呢?

我觉得有两个地方,我不同意作者的观点。

第一个是度量指标的选择确实会影响对模型能力判读的变化,但很多任务的指标设计本身就很难设计成完全”连续“或“线性”的。accuracy准确率本身就是符合人类直觉的评估指标。你在考试中,比如填空题的标准答案是100,哪怕错了一点就不能得分。随着AI方方面面地参与到人类日常生活中来,对AI的要求会越来越强。这要求AI能够达到我们的所谓的不连续的评估指标的要求。否则无数个微小的误差累乘,最终会造成很大的误差。

第二点是,高考为什么不只考一道填空题或者选择题?题多了,一道题对总分的影响就小了,小差别也更容易看出来。可如果很多题在某个规模之前都做不对,过了那个规模又一起做对,总分还是会跳。

我编了一通数据,假如在10000个样本上应用评估指标1并取平均,那种突然涌现的现象可能会减缓,评价指标随着模型规模而缓慢增加的情况会更明显。这个表格是我自己编的,只是为了说明,题多了,原来没看见的小差别有可能测出来。至于那一下跳升会不会消失,还得看实测。大家有时间的话,可以自己设计一系列实验,去跑跑结果。

原文配图

大模型中的涌现是伪科学吗?

我认为大模型随着模型参数增加而产生的效果陡增的能力,不是涌现。

回到涌现的定义

涌现指的是整体表现出个体没有的性质。而大模型中涌现的定义是模型规模达到一定数量时,突然表现出一定智能。仔细斟酌,我觉得这两个定义是不一样的。大模型中,整体和个体分别指的是什么?假如说整体指的是几十亿百亿个参数依照一定的结构和前向传播方式组成的模型,那个体是单个参数或者单个神经元吗?照这种划分,普通的神经网络也有涌现。以最简单的手写数字识别为例,单个神经元也做不出分类,几层卷积神经网络就可以完成手写数字识别的分类,能够做到单个神经元做不到的功能。这能不能算涌现呢?

而且涌现是一个模糊的概念,没有明确的定义。比如有一条曲线,准确率突然从 5% 飙升到 30%,大家就把它称为涌现。那从5%到29%,算不算涌现?28%呢?27%呢?

深度学习直到现在,都没有严格的数学基础,缺乏严谨的数学解释。很多大模型取得的效果都是建立在工程技巧和反复的尝试上,有一句话叫做“大力出奇迹”。数学是科学之母,如果一项技术缺乏数学的解释,是非常容易被诟病成伪科学。不过大模型之所以被诟病为伪科学,可能还有一个原因是大模型过于超前,理论还不成熟。举个简单的例子,知乎有一个很火的提问《有哪些有哪些「大众默认专家搞懂了,实际上没人能解释清楚」的例子?》(https://www.zhihu.com/question/263711126),其中有一个例子是,自行车骑行的时候为什么不会倒下。这背后的原理我们仍然没有搞明白,不能用完美的力学来解释。但这并不妨碍两百年来大家使用自行车作为代步工具。

确定性系统会产生涌现吗?

涌现这个概念的使用一定要谨慎。以蚁群的涌现为例。虽然单个蚂蚁的智能很有限,但是单个蚂蚁毕竟是生物,毕竟是活的,是动的,即使是一只蚂蚁,我们能说我们对蚂蚁的研究已经到了十全十美、完全透彻的地步了吗?并不是。把一只蚂蚁放到实验室的某个地方,我们能信誓旦旦地预测出蚂蚁十分钟后会出现在哪里吗?不可能。有一种观点是,因为单个元素存在随机性,或者一些人类尚未弄明白的机理,才导致整体出现涌现的情况。

回到计算机领域中,人工神经网络的微观细节是清晰、确定的。神经网络中的每一步计算都是确定的。我们创造了人工神经网络,我们对神经网络的每一个算子、每一个矩阵相乘都了如指掌。人工神经网络是一个确定性的系统,涌现可能出现吗?

确定性系统可以出现涌现吗?这可能取决于对涌现的定义。有一个很类似的概念是混沌。比如三体问题。恒星之间的引力规律很简单,短时间的运动当然可以算。但在有些情况下,起点只差一点,时间一长,轨迹就可能差得很远。这就是混沌。回想前面提到的生命游戏,规则完全确定,照样能跑出意想不到的图案。我怀疑的是另一件事:大模型的分数突然跳了一下,到底是模型真学会了什么,还是换个打分方法,这一下就没了?

所以我不想一看到分数往上跳,就说模型有了新能力。说句不好听的,就算出现了涌现,谁能保证一定会向好的方向涌现呢?假如有一天,AI模型、AIAgent产生了真涌现,它觉得人类太笨了,想办法把人类都处理了,怎么办?有没有这样的可能性呢?