我喜欢通过debug代码的方式来深入理解一个概念,因为我认为实践出真知。如果只是浏览论文或者别人的博客,对概念的认识可能仅停留在表面。即使用笔在纸上计算一遍,可能还是无法完全掌握细节。
引言:判断语言生成模型的性能 之前我分享过语言模型的“困惑度”的概念(武辰:深入理解语言模型的困惑度(perplexity) )。通过计算一段语料的生成概率,困惑度可以衡量一个base模型的性能优劣。
对于chat模型,如何衡量模型的好坏呢?在传统的分类问题中,我们可以轻松地通过精确度(accuracy)、召回率(recall)等指标来测定分类器的好坏。对于目标检测、定位、分割等问题,也有一套客观的评估方案。
对于语言生成模型来说,我们希望生成的句子与目标句子尽可能接近。交叉熵可以看模型给参考答案多大的概率。我这里想问的是另一件事:两句话都已经写出来了,它们到底有多像?
语言作为一个充满主观性的领域,往往即使对句子稍作修改,如增删几个字或微调词序,也不会改变句子的基本含义。那么,除了交叉熵,还有哪些指标可以衡量生成句子与目标句子之间的匹配程度呢?
抛砖引玉:一些简单的衡量句子相似度的方法 文本转向量模型 我的初步想法是利用文本向量化模型,诸如BERT模型、BCEmbedding模型、BGE模型等到,把句子转换为向量表示。然后通过向量的内积或余弦相似性来衡量两段语料的接近程度,其结果越大,则两段语料越为接近。然而,这一方案并不是太理想,因为它需要进行额外的推理运算,这会消耗大量计算资源。此外,结果的准确性还受到文本向量化模型质量的影响。如果模型的质量不高,计算出的相似度可能就不够准确。在一些特殊情况下,文本向量化模型可能无法处理词汇表以外的单词,这也会影响到计算的准确性。
余弦相似度 假设我们有两段文本(Text A 和 Text B):
Text A: The quick brown fox jumps over the lazy dog.
Text B: A fast brown fox leaps over a sluggish dog.
第一步:分词
将两段文本分别拆分成单词列表:
Text A: ["The", "quick", "brown", "fox", "jumps", "over", "the", "lazy", "dog"]
Text B: ["A", "fast", "brown", "fox", "leaps", "over", "a", "sluggish", "dog"]
(还可以进一步进行文本标准化处理,如转换为小写、去除停用词、词干化/词形还原等,以提高相似度计算的准确性。这个例子里只统一成小写,其他处理先不做。)
第二步:构建词频向量:
计算每段文本中每个单词的词频,形成词频向量。
假设我们有一个包含两段文本所有唯一单词的词汇表:
Vocabulary: ["a", "brown", "dog", "fast", "fox", "jumps", "lazy", "leaps", "over", "quick", "sluggish", "the"]
根据词汇表,构建词频向量:
Text A Vector: [0, 1, 1, 0, 1, 1, 1, 0, 1, 1, 0, 2]
Text B Vector: [2, 1, 1, 1, 1, 0, 0, 1, 1, 0, 1, 0]
第三步:计算余弦相似度。
这种方法比较naive,有如下缺陷:
1.对词汇顺序不敏感: 余弦相似度仅基于词频向量的点积,忽略了词汇在文本中的具体顺序。对于一些依赖于语序表达语义的情况(如“我喜欢狗”与“狗喜欢我”),这种方法可能无法准确反映其语义差异。
2.对词频过于敏感: 余弦相似度直接基于词频计算,可能导致某些高频但非关键的词语(如“的”、“和”、“是”等停用词)对相似度得分产生过大影响,掩盖了真正重要的词汇和概念。虽然可以通过预处理阶段去除停用词来缓解这个问题,但对于某些特殊情况(如词义丰富的同义词、多义词)仍可能不够精准。
3.忽视词汇的语义关联: 余弦相似度仅基于词汇表中的单词出现与否及其频率,无法捕捉词汇之间的语义关联或概念层次关系。例如,“汽车”与“轿车”、“跑车”在语义上高度相关,但在词频向量模型中被视为不同的词汇,可能导致相似度得分偏低。
4.对短文本效果不佳: 对于非常短的文本,由于词汇数量有限,构建的词频向量可能过于稀疏,导致余弦相似度计算结果不稳定,不能准确反映文本间的实际相似度。
5.需要预定义词汇表: 余弦相似度计算通常需要预先定义一个词汇表,这可能导致某些特定领域或上下文相关的词汇被忽略,进而影响相似度计算的准确性。此外,随着文本集规模增大,词汇表可能会变得庞大,增加计算复杂性和资源消耗。
TF-IDF TF-IDF可以看作是上一个方法的升级版。
TF-IDF原本是用来评估一个词对一篇文档的重要程度
以下内容参考于:https:// blog.csdn.net/szn104386 2535/article/details/120922191
词频(Term Frequency,TF)表示词语在当前文章中的频率;逆文本频率指数(Inverse Document Frequency,IDF)则表示某个词语在包含众多文档的文库中的常见程度,即IDF值越大,该词越不常见。 TF-IDF原本是用来评估一个词对一篇文档的重要程度,但是为什么可以用来衡量两个文本的相似度度量?接下来通过一个简单的例子来了解如何使用TF-IDF评估两个文本的相似度。
假设文档集合只有下面两句话:
文档1:“我喜欢吃苹果 和 橙子”
文档2:“我喜欢看电影 和 吃橙子”
首先使用TF-IDF为每个文档生成一个词汇的权重向量。
计算TF (词频):文档中某词出现的次数 / 文档的总词数
文档1切成「我/喜欢/吃/苹果/和/橙子」,一共 6 个词,每个词出现 1 次,TF 都是 1/6。
文档2切成「我/喜欢/看/电影/和/吃/橙子」,一共 7 个词,每个词出现 1 次,TF 都是 1/7。
计算 IDF(逆文档频率):log₁₀(总文档数 / 包含某词的文档数)。这个例子的分母不加 1。
对于词"我",总文档数是2,包含"我"的文档数也是2,所以"我"的IDF = log(2/2) = 0。
对于词"橙子",总文档数是2,包含"橙子"的文档数也是2,所以"橙子"的IDF = log(2/2) = 0。
对于词"苹果",总文档数是2,包含"苹果"的文档数是1,所以"苹果"的IDF = log(2/1) ≈ 0.3010。
对于词"电影",总文档数是2,包含"电影"的文档数是1,所以"电影"的IDF = log(2/1) ≈ 0.3010,等等。
通过将TF和IDF相乘,我们得到每个词在每个文档中的TF-IDF值。
于是,我们可以得到以下的TF-IDF向量表示:
文档1的向量表示:[我, 喜欢, 吃, 苹果, 和, 橙子, 看, 电影] ≈ [0, 0, 0, 0.05017, 0, 0, 0, 0]
文档2的向量表示:[我, 喜欢, 吃, 苹果, 和, 橙子, 看, 电影] ≈ [0, 0, 0, 0, 0, 0, 0.04300, 0.04300]
需要注意的是,当我们计算文档的TF-IDF向量时,词汇表应当包含整个文档集中的所有唯一单词。因此,每个文档的TF-IDF向量将具有相同的长度,即使某些单词在特定文档中没有出现(在这种情况下,该单词的TF-IDF值将为零)。
再算这两个向量的余弦相似度,结果是 0。两句话明明都提到了吃橙子,可它们共有的词在这两篇里都出现了,IDF 全是 0。第一句只剩「苹果」,第二句只剩「看」和「电影」,点积自然就是 0。
这种方法来衡量文本相似度仍然有一些缺陷:
1.语义层面的问题:TF-IDF关注的是词频和逆文档频率,而不是实际的语义。这意味着,即使两段文本在语义上相似但用词不同,TF-IDF也可能给出较低的相似度分数。
2.无法捕捉词序信息:TF-IDF是基于词袋模型的,即它只在乎文本中的词汇,而不关心词汇出现的顺序。这可能导致在判断某些情况下的相似度时效果不佳。
3.影响权重的因素较少:TF-IDF只关注词频和逆文档频率,缺乏其他有助于判断相似度的特征。例如,单词的重要性、长度、位置等特征都无法从TF-IDF中获取。
4.对高频词和罕见词可能处理不平衡:罕见词的影响往往高于常见词,这可能导致结果不准确。例如,两篇关于同一主题的文章中使用了不同的罕见词,可能被认为区别较大。
5.对同义词和词形变化敏感:即使两个词在语义上相同,但在形式上有差异(例如时态、复数等),也可能导致TF-IDF相似度低。
BLEU 除了前文提到的这两种方法外,学术界还提出了一些更具针对性的评估指标,其中BLEU(Bilingual Evaluation Understudy)是一个较为经典的衡量文本相似度的指标。
BLEU 是一种用于评估自然语言处理领域机器翻译质量的指标,最早由 IBM 的研究团队于 2002 年提出。其工作原理主要是通过比较机器翻译生成的文本与一个或多个人类翻译的参考文本,进而计算翻译质量的准确性。
当然,BLEU 也可以应用于衡量两段文本的相似度,不仅仅局限于机器翻译。
代码 from nltk.translate.bleu_score import sentence_bleu
candidates = 'The quick brown fox jumps over the big dog'
references = 'The quick brown beautiful fox jumps over the lazy dog'
candidate = candidates.split(' ') # 这是生成文本的例子
reference = [references.split(' ')] # 这是一个参考文本的例子,用列表的列表表示,因为可以有多个参考文本
bleu_score = sentence_bleu(reference, candidate)
print("BLEU score:", bleu_score)通过debug代码分析计算BLEU的步骤 第一步:分词
在这里,为简化问题,我直接基于空格进行分词,而无需使用分词器。对于英文来说,这种方法是可行的。
分词后的结果:
reference: [['The', 'quick', 'brown', 'beautiful', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog']]
candidate: ['The', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'big', 'dog']
第二步:计算1-gram
计算参考文本(reference)中每个词出现的频数:
{('The',): 1, ('quick',): 1, ('brown',): 1, ('beautiful',): 1, ('fox',): 1, ('jumps',): 1, ('over',): 1, ('the',): 1, ('lazy',): 1, ('dog',): 1}
计算候选文本(candidate)中每个词在reference中出现的频数:
{('The',): 1, ('quick',): 1, ('brown',): 1, ('fox',): 1, ('jumps',): 1, ('over',): 1, ('the',): 1, ('big',): 0, ('dog',): 1}
candidate一共有9个词,其中有8个词在reference出现过,因此precision是8/9。注意,BLEU是计算precision,因此分母是candidate的长度。如果计算recall,则分母是reference的长度。
为了更深入理解计算1-gram的逻辑,我换一个例子:
predictions = 'the quick brown big dog jumps over the big dog'
references = 'the quick brown beautiful fox jumps over the lazy dog'
计算参考文本中每个词出现的频数:
{('the',): 2, ('quick',): 1, ('brown',): 1, ('beautiful',): 1, ('fox',): 1, ('jumps',): 1, ('over',): 1, ('lazy',): 1, ('dog',): 1}
计算候选文本中每个词在参考文本中出现的频数:
{('the',): 2, ('quick',): 1, ('brown',): 1, ('big',): 0, ('dog',): 1, ('jumps',): 1, ('over',): 1}
虽然在candidate中dog出现了两次,但是在reference中,dog只出现了一次,因此还是计为一次。
需要注意的是,BLEU 这里算的是 precision。像 beautiful、fox 这种只在参考句里出现的词,不单独扣分;候选句太短,下面还有一项惩罚。
有人可能会问,那我忽略recall,只关注prerecision,行不行?比如我认为the这个词语一定会出现在reference中,那么只输出一个the作为candidate。答案是不行。因为针对短文本,BLEU会有一个 惩罚因子,下文会说到。而且这一招只能应付1-gram,对于2-gram、3-gram则无法奏效。
第三步:计算2-gram、3-gram、4-gram
计算2-gram、3-gram、4-gram和计算1-gram的思路是类似的,这里只列举结果。
参考句中各个 2-gram 的出现次数:
{('The', 'quick'): 1, ('quick', 'brown'): 1, ('brown', 'beautiful'): 1, ('beautiful', 'fox'): 1, ('fox', 'jumps'): 1, ('jumps', 'over'): 1, ('over', 'the'): 1, ('the', 'lazy'): 1, ('lazy', 'dog'): 1}
候选句中各个 2-gram 在参考句里匹配了几次:
{('The', 'quick'): 1, ('quick', 'brown'): 1, ('brown', 'fox'): 0, ('fox', 'jumps'): 1, ('jumps', 'over'): 1, ('over', 'the'): 1, ('the', 'big'): 0, ('big', 'dog'): 0}
2-gram的precision是5/8
参考句中各个 3-gram 的出现次数:
{('The', 'quick', 'brown'): 1, ('quick', 'brown', 'beautiful'): 1, ('brown', 'beautiful', 'fox'): 1, ('beautiful', 'fox', 'jumps'): 1, ('fox', 'jumps', 'over'): 1, ('jumps', 'over', 'the'): 1, ('over', 'the', 'lazy'): 1, ('the', 'lazy', 'dog'): 1}
候选句中各个 3-gram 在参考句里匹配了几次:
{('The', 'quick', 'brown'): 1, ('quick', 'brown', 'fox'): 0, ('brown', 'fox', 'jumps'): 0, ('fox', 'jumps', 'over'): 1, ('jumps', 'over', 'the'): 1, ('over', 'the', 'big'): 0, ('the', 'big', 'dog'): 0}
3-gram的precision是3/7
4-gram的candidate中每个gram出现的频数:
{('The', 'quick', 'brown', 'fox'): 1, ('quick', 'brown', 'fox', 'jumps'): 1, ('brown', 'fox', 'jumps', 'over'): 1, ('fox', 'jumps', 'over', 'the'): 1, ('jumps', 'over', 'the', 'big'): 1, ('over', 'the', 'big', 'dog'): 1}
候选句中各个 4-gram 在参考句里匹配了几次:
{('The', 'quick', 'brown', 'fox'): 0, ('quick', 'brown', 'fox', 'jumps'): 0, ('brown', 'fox', 'jumps', 'over'): 0, ('fox', 'jumps', 'over', 'the'): 1, ('jumps', 'over', 'the', 'big'): 0, ('over', 'the', 'big', 'dog'): 0}
4-gram的precision是1/6
第四步:加入惩罚项
上文说到,BLEU计算的是precision,precision更偏向于短文本。短文本惩罚可以防止短翻译在BLEU中得分过高。
候选句不比参考句短,惩罚系数 bp 就是 1;候选句更短,才用下面这个式子:
bp=math.exp(1 - reference_len / candidate_len)
在本例中,bp = exp(1 − 10/9) ≈ 0.895。
第五步:计算BLEU
在这里我就不列举枯燥的公式了,而是直接将数值往里面代入。
注意式子中有一个值是0.25,这代表取平均值。其实也可以自定义加权平均值,比如可以给2-gram的precision的权重更高一些。
b l e u = b p * e 0.25 ( l o g 8 9 + l o g 5 8 + l o g 3 7 + l o g 1 6 ) = 0.4 bleu=bp*e^{0.25(log\frac{8}{9}+log\frac{5}{8}+log\frac{3}{7}+log\frac{1}{6})}=0.4
BLEU的局限性 1.语义问题:BLEU主要依赖于n-gram精确度进行计算,它无法捕捉到文本的语义信息。如果两句话在语义上几乎一样,但是词序或者用词稍有不同,BLEU可能会给出较低得分。
2.无法处理句子长度:BLEU容易受到句子长度的影响。对于短句子,即使所有的词都正确,但由于句子长度过短,BLEU的得分可能依然很低。
ROUGE ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是一种自动评估文本摘要质量的指标,尤其适用于评估抽取式摘要任务。ROUGE 主要通过比较自动生成的摘要与人工编写的参考摘要进行评估,侧重于衡量召回率。ROUGE 的设计初衷是弥补 BLEU 在评估文本摘要任务时的不足。
当然,ROUGE也可以用来衡量两段语料的相似度。
代码 这里直接用 rouge_score 库算,能同时看到 precision、recall 和 F1。安装命令是 pip install rouge-score。
from rouge_score import rouge_scorer

predictions = ['The quick brown fox jumps over the big dog']
references = ['The quick brown beautiful fox jumps over the lazy dog']

scorer = rouge_scorer.RougeScorer(['rouge1', 'rouge2', 'rougeL'])
score = scorer.score(references[0], predictions[0])
print(score)
通过debug代码分析计算ROUGE的步骤 第一步:分词
这里用的是 rouge_score 自带的默认分词器,它会先把英文字母转成小写。
predictions = ['The quick brown fox jumps over the big dog']
references = ['The quick brown beautiful fox jumps over the lazy dog']
references经过分词后是
['the', 'quick', 'brown', 'beautiful', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog']
predictions经过分词后是
['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'big', 'dog']
注意,这个分词器不能对中文分词,因此这个代码无法适用于有中文的情况。解决方法是修改源代码,将self.tokenizer替换成支持中文的分词器,或者使用其他库(比如rouge_chinese)。
第二步:计算1-gram
计算参考文本(reference)中每个词出现的频数:
{('the',): 2, ('quick',): 1, ('brown',): 1, ('beautiful',): 1, ('fox',): 1, ('jumps',): 1, ('over',): 1, ('lazy',): 1, ('dog',): 1}
再看候选句里每个词在参考句里匹配了几次:
{('the',): 2, ('quick',): 1, ('brown',): 1, ('fox',): 1, ('jumps',): 1, ('over',): 1, ('big',): 0, ('dog',): 1}
predictions一共有9个词,其中有8个词在reference出现过。intersection_ngrams_count=8.
然后分别计算precision/recall/fmeasure
precision = intersection_ngrams_count / prediction_ngrams_count
recall = intersection_ngrams_count / target_ngrams_count
fmeasure = scoring.fmeasure(precision, recall)
这里的prediction_ngrams_count是predictions的长度,为9;target_ngrams_count是references的长度,为10.
结果是precision=8/9, recall=8/10, fmeasure=0.84
BLEU只计算了precision,ROUGE计算了precision/recall/fmeasure
第三步:计算2-gram
计算2-gram计算1-gram的思路是类似的,这里只列举结果。这里没有计算3-gram、4-gram
参考句中各个 2-gram 的出现次数:
{('the', 'quick'): 1, ('quick', 'brown'): 1, ('brown', 'beautiful'): 1, ('beautiful', 'fox'): 1, ('fox', 'jumps'): 1, ('jumps', 'over'): 1, ('over', 'the'): 1, ('the', 'lazy'): 1, ('lazy', 'dog'): 1}
候选句中各个 2-gram 在参考句里匹配了几次:
{('the', 'quick'): 1, ('quick', 'brown'): 1, ('brown', 'fox'): 0, ('fox', 'jumps'): 1, ('jumps', 'over'): 1, ('over', 'the'): 1, ('the', 'big'): 0, ('big', 'dog'): 0}
intersection_ngrams_count=5.
precision=5/8, recall=5/9, fmeasure=0.59
第三步:计算Rouge-L
ROUGE-L基于最长公共子序列(Longest Common Subsequence)计算两个摘要之间的相似度。它不仅考虑了重叠的单词和短语,还考虑了它们的顺序关系。ROUGE-L适用于评估生成摘要中保持参考摘要结构和重要信息的能力。
对于references:
['the', 'quick', 'brown', 'beautiful', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog']
和predictions:
['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'big', 'dog']
代码使用动态规划的方法求得它们的最长公共子序列是:
['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'dog']
长度为8,然后结果是:
precision=8/9, recall=8/10, fmeasure=0.84
最后,每种 ROUGE 都有三个分数。下面保留三位小数:
{'rouge1': Score(precision=0.889, recall=0.8, fmeasure=0.842),
'rouge2': Score(precision=0.625, recall=0.556, fmeasure=0.588),
'rougeL': Score(precision=0.889, recall=0.8, fmeasure=0.842)}
其他计算ROUGE的库 rouge库:
from rouge import Rouge
def calculate_rouge_score ( hypothesis , reference ):
rouge = Rouge ()
scores = rouge . get_scores ( hypothesis , reference )
return scores
hypothesis = 'The quick brown fox jumps over the lazy dog.'
reference = 'A swift brown fox leaps over a sluggish canine.'
scores = calculate_rouge_score ( hypothesis , reference )
print ( scores ) 这个库比较简陋,它甚至都没有集成分词器(tokenizer),而是仅仅依赖于空格来实现分词功能。
rouge_chinese库:
from rouge_chinese import Rouge
rouge = Rouge ()
hypothesis = 'The quick brown fox jumps over the lazy dog.'
reference = 'A swift brown fox leaps over a sluggish canine.'
scores = rouge . get_scores ( hypothesis , reference )
print ( scores ) 对于中文,仍然要配合jieba分词器使用,因为它没有内置分词器。
from rouge_chinese import Rouge
import jieba # you can use any other word cutting library

hypothesis = "今天我们相聚在一起"
hypothesis = ' '.join(jieba.cut(hypothesis))  #'今天 我们 相聚 在 一起'

reference = "我们今天相聚在这里"
reference = ' '.join(jieba.cut(reference)) #'我们 今天 相聚 在 这里'

rouge = Rouge()
scores = rouge.get_scores(hypothesis, reference)
print(scores)
Bert-score 在我们前文中提到,BLEU和ROUGE这两个评价指标无法准确捕获到文本的语义含义。即使两句话的要表达的内容几乎一致,只因词序或词汇选择稍有不同,这两个评估工具可能也无法给出高分。
面对这样的问题,BERT-Score就显得相当有用。此指标借助于BERT模型,将所需评估的文本转换为向量模式,然后评估模型预测输出(Hypothesis)相对于标签(Reference)的精确度和查全率。
前置准备 安装bert-score库
另外,我们需要下载bert-base-chinese模型,该模型的下载地址是https://huggingface.co/google-bert/bert-base-chinese/tree/main。
代码 from bert_score import score
cands = ['你举止优雅,吸引了众人的目光。']
refs = ['你风度翩翩,令人无法转移视线。']
P, R, F1 = score(cands, refs,model_type="/home/notebook/data/group/huggingface/bert-base-chinese",num_layers=8, lang="zh", verbose=True)
print(F1)
print(f"System level F1 score: {F1.mean():.3f}")如果模型已经下载到本地,model_type 就填模型目录。这里再传 num_layers=8,选第 8 层来评分,不用改库的源码。
通过debug代码分析计算步骤 第一步:分词。
加载好tokenizer后,发现tokenizer是BertTokenizer,具体的配置是:
BertTokenizer(name_or_path='/home/notebook/data/group/huggingface/bert-base-chinese', vocab_size=21128, model_max_length=512, is_fast=False, padding_side='right', truncation_side='right', special_tokens={'unk_token': '[UNK]', 'sep_token': '[SEP]', 'pad_token': '[PAD]', 'cls_token': '[CLS]', 'mask_token': '[MASK]'}, clean_up_tokenization_spaces=True), added_tokens_decoder={ 分词的结果是:
'[CLS] 你 举 止 优 雅 , 吸 引 了 众 人 的 目 光 。 [SEP]'
'[CLS] 你 风 度 翩 翩 , 令 人 无 法 转 移 视 线 。 [SEP]'
可见分词器将一个汉字分为一个词,每个句子都包括17个token。
对应的input_ids.shape=2*17。
第二步,加载model。
bert-base-chinese 本身有 12 层;这里评分用的是第 8 层的输出,每个 token 的向量还是 768 维。
第三步,模型推理。
输入的input_ids的shape是torch.Size([2, 17]),经过bert模型后,得到两个输出,分别是last_hidden_state和pooler_output。last_hidden_state 是这里截取的第 8 层的输出。pooler_output则是最后一层的[CLS]符号对应位置再经过几个线性层的结果。out.last_hidden_state.shape是torch.Size([2, 17, 768]),out.pooler_output.shape是torch.Size([2, 768])。
第四步:矩阵相乘(类似于做向量内积)。
out.last_hidden_state的第一个数据是hyp_embedding,shape是torch.Size([1, 17, 768])
第二个数据是ref_embedding,shape也是torch.Size([1, 17, 768])
先把每个 token 的向量除以自己的长度,再做点积,得到形状为 [1, 17, 17] 的矩阵 sim。这样,每个格子里算出来的就是候选句一个 token 和参考句一个 token 的余弦相似度。
第五步:计算precision和recall。
在源代码中,这两行代码可能比较难以理解:
word_precision = sim.max(dim=2)[0]
word_recall = sim.max(dim=1)[0]
sim矩阵的第一行,表示hyp的第一个token,和ref的所有token都算一遍余弦相似度后的结果。在这些结果中,挑出最大的出来。然后对每一行都是如此。默认设置下,[CLS] 和 [SEP] 那两行不计入平均。其余每行的最大值取个平均,就是 precision。这种计算precision的方式感觉有点牵强,并且结果不一定在0到1之间,但是它的基本逻辑符合直觉。比如说,hyp中出现了一个与参考文本无关的token,比如“克拉霉素”这个token,明显它和ref的任何token都不相关,那么克拉霉素这个token这一行的所有值都很小,这会拉低precision的分数,这是符合直觉的。
刚刚是从行的角度解释precision。现在从列的角度解释recall。
sim矩阵的第一列,表示在ref 的第一个token,和hyp的所有token都算一遍余弦相似度后的结果。在这些结果中,挑出最大的出来。然后对每一列都是如此。同样,[CLS] 和 [SEP] 那两列不计入平均,其余每列的最大值取个平均,就是 recall。假如ref中出现了“克拉霉素”这个token,但是hyp中没有出现任何医学相关的token,那么“克拉霉素”这个token所在的那一列的所有值都会很小,这会拉低recall的分数,是符合直觉的。
一些具体的例子 hyp = '美的人'
ref = '漂亮的笔'
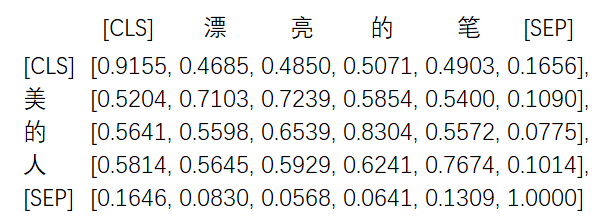
得到的sim矩阵是:
从precision的角度来剖析这个结果。
「美」和「漂」、「亮」的相似度都超过了 0.7,这是符合实际的。
“的”和“的”的余弦相似度最大,这是符合实际的。
“人”和“笔”的余弦相似度达到了0.76,超过了“美”和“漂”的余弦相似度,这似乎有些不太符合实际。
最终得到的precision是(0.7239+0.8304+0.7674)/3=0.7739
从recall的角度来剖析这个结果。
「漂」和「亮」都和「美」最相似,分数都超过了 0.7,这是符合实际的。
“的”和“的”的余弦相似度最大,这是符合实际的。
“笔”和“人”的余弦相似度达到了0.76,超过了“美”和“漂”的余弦相似度,这似乎有些不太符合实际。
最终得到的recall是(0.7103+0.7239+0.8304+0.7674)/4=0.7580