这篇文章节选自我已经出版的《大白话概率论:从数学直觉到AI视野》。这本书主要写给自学者,用大白话、具体例子和详细推导讲概率论,也结合了AI应用和Python实验。完整目录、详细介绍和购买链接放在文末,有兴趣可以看看。
上一章讲的均匀分布,那是理想国里的乌托邦——一切机会均等,毫无波澜。但真实世界是充满焦虑的。
我们在等公交、等暗恋对象的回复、等测试代码跑完。这种“不知道靴子什么时候落地”的煎熬,才是生活的常态。
如果说均匀分布是平静的湖面,那么今天我们要讲的“指数分布”,就是倒计时。数学家是怎么描述这种“随时可能发生,但又不知道确切是哪一刻”的感觉呢?
在离散的世界里,我们学过几何分布 ,用来描述“进行一系列独立试验,直到第一次成功所需的试验次数 ”。比如,你反复投掷一枚硬币,直到第一次出现正面朝上所需的投掷次数;或者,你不停地从一副扑克牌中抽卡(每次抽后放回),直到第一次抽到“A”所需的抽卡次数。这些都是离散的“等待”。
现在,我们步入连续的世界,时间可以精细到分秒、毫秒。那么,“直到某个随机事件第一次发生所需的等待时间 ”,又该用什么分布来描述呢?是等待下一个客户走进店铺的时间?还是等待下一个放射性原子核衰变的时间?
这一节要讲的就是指数分布。它和前面讲的几何分布、泊松分布都有联系。
几个等待时间的例子 想象一下这些场景:
你站在一个公交站,公交车班次不多,你想知道下一辆车还要等多久。 你刚买了一台新的路由器,想知道它第一次出故障会在什么时候。 你是一名客服,刚挂断一个电话,在等待下一个来电。 科学家观察一个放射性原子核,记录它发生衰变的时间。 这些看似不同的问题,都有一个共同的数学内核:我们关心的是,从一个随机事件(上一辆车离开、上次通话结束、开始使用、开始观测)开始,到下一个同类事件发生,中间需要等待多长时间。
这个等待时间 T T
听起来很合理,对吧?那么,什么样的数学函数能精确刻画这种特点,并且背后有深刻的道理呢?
让我们先不急着看公式,一起思考一个更根本的问题:这个随机事件的发生,本身应该遵循什么规律?
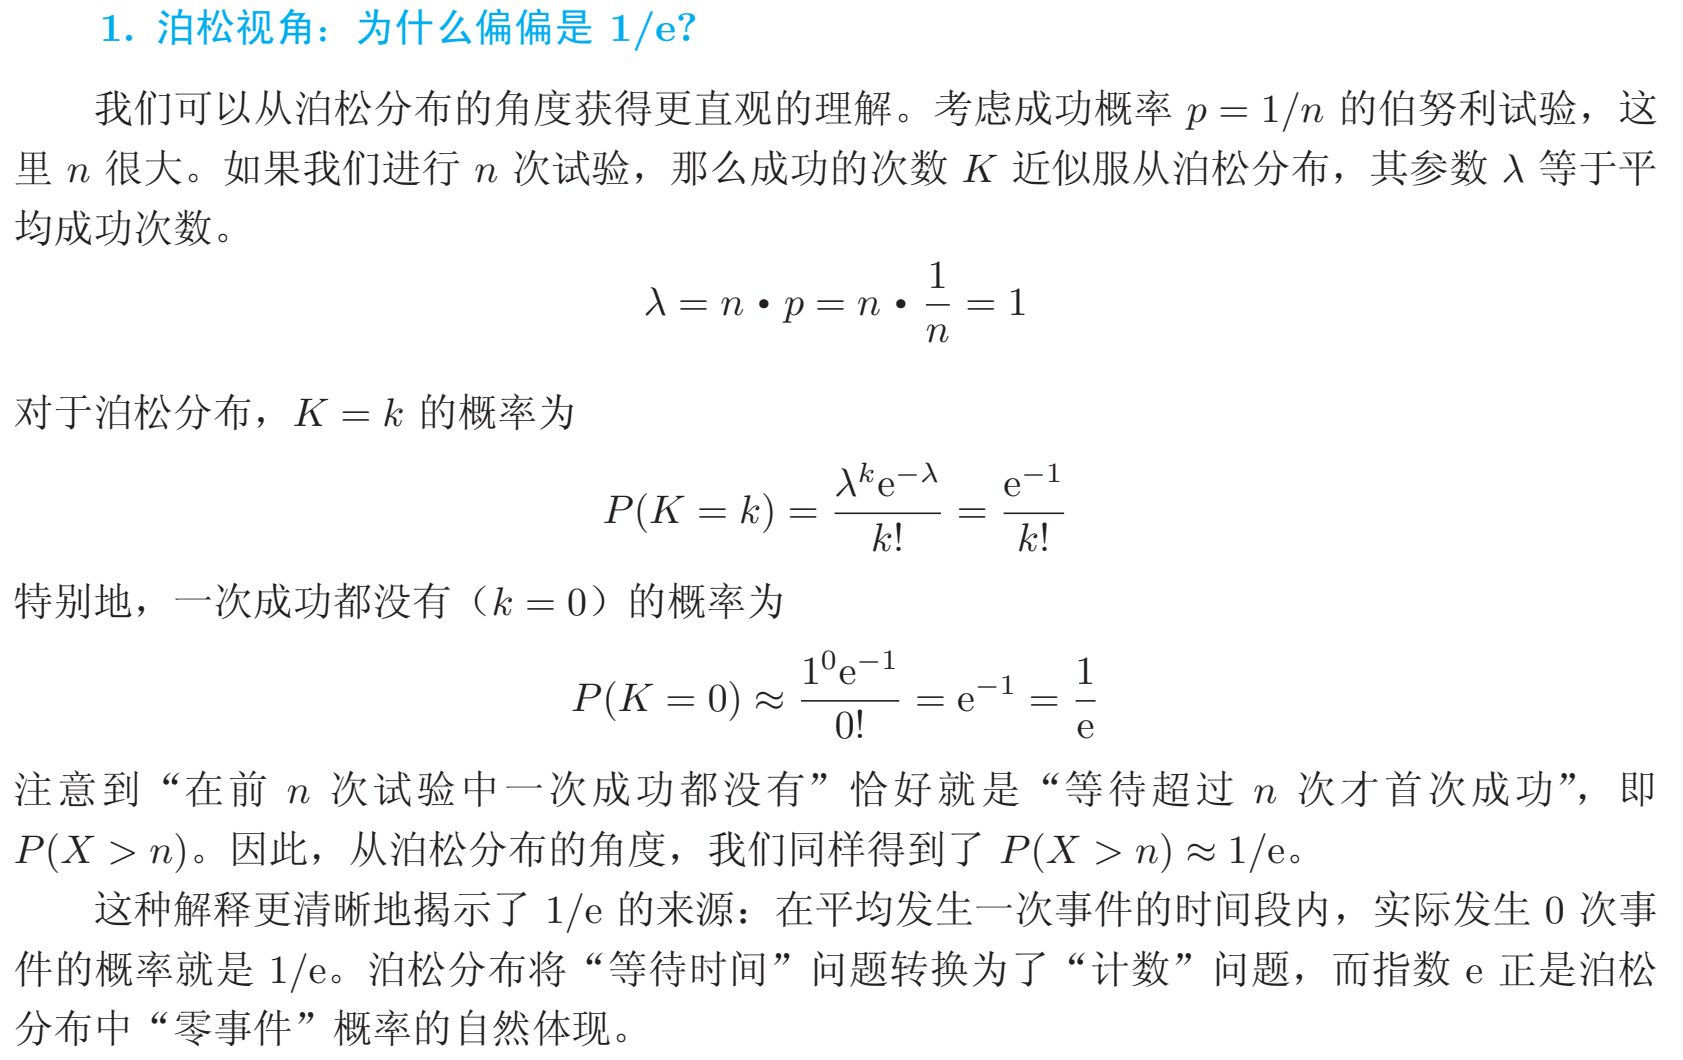
泊松过程和指数分布 你还记得我们上一章认识的泊松分布 吗?它描述的是:在一个固定的时间段 内,某个随机事件发生的次数 。比如,客服中心一小时接到的电话数,或者一个小型咖啡馆上午10点到11点进店的顾客人数。它的核心假设是:事件以恒定的平均速率λ \lambda 随机、独立地发生。
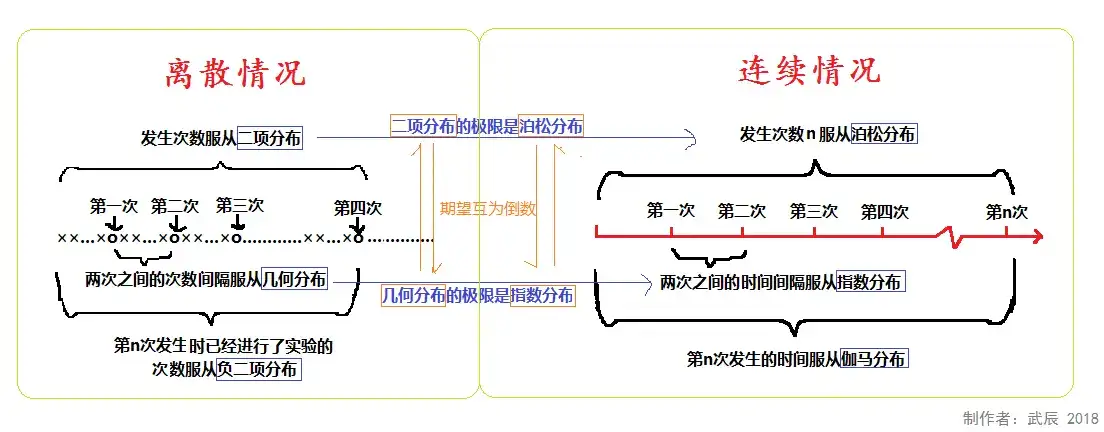
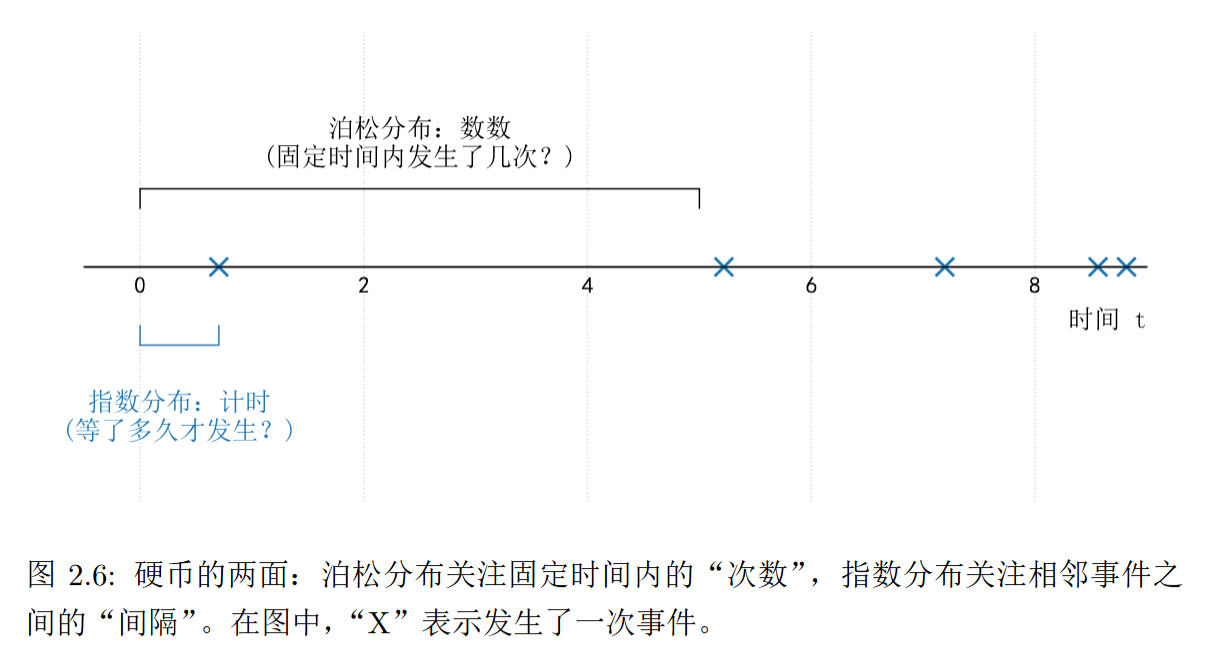
泊松分布是“计数”的分布。现在,我们换个角度想想。不从“一段时间内发生多少次”来看,而是从“两次事件之间隔了多久 ”来看。
仔细想想,这不正是我们的“等待时间”问题吗?对于客服电话,“来电”是一个随机事件。如果我们假设来电的发生是随机的、无记忆的,并且以某个恒定平均速率发生,那么“从上一次来电到下一次来电的时间”,就等同于“两次来电事件之间的间隔时间”。
泊松过程和指数分布之间,有这样一个联系:
如果一个随机事件的发生过程是一个泊松过程(恒定速率λ \lambda T T
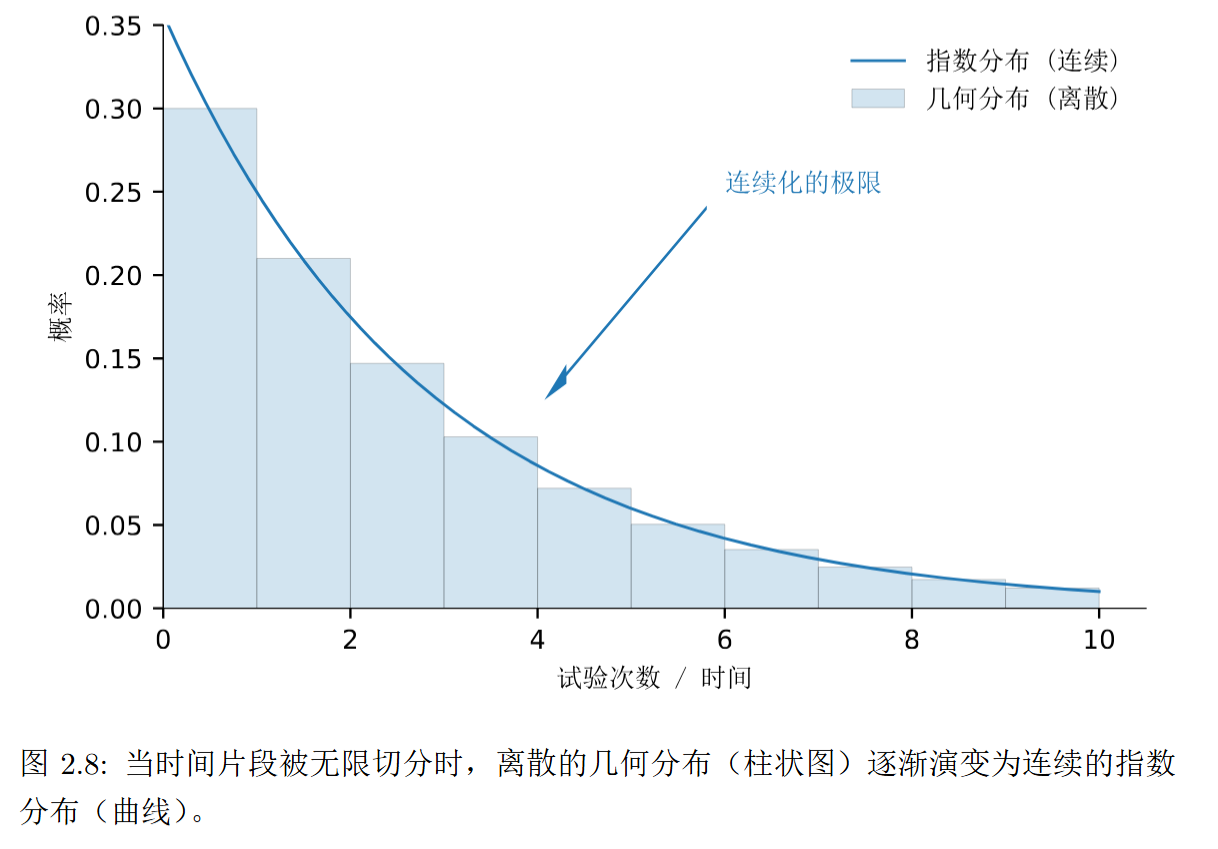
这个联系不是巧合,而是内在逻辑的必然。泊松分布关心“数数”,指数分布关心“计时”,它们描述的是同一个随机现象的两个侧面 。正如我们在图中我们所看到的,它们就像一枚硬币,一面是“次数”,一面是“间隔”。
正因为如此,指数分布的命运和它的孪生兄弟泊松分布绑定在了一起。它的公式也与泊松分布共享同一个参数λ \lambda
指数分布的公式,以及那个关键的参数λ \lambda 现在,我们可以请出指数分布的概率密度函数(PDF)了。对于随机变量 T T λ \lambda λ > 0 \lambda > 0 T ∼ Exp ( λ ) T \sim \text{Exp}(\lambda)
f ( t ) = λ e − λ t , 对于 t ≥ 0 f(t) = \lambda e^{-\lambda t}, \quad \text{对于 } t \ge 0
以及它的累积分布函数(CDF),也就是 P ( T ≤ t ) P(T \le t)
F ( t ) = 1 − e − λ t , 对于 t ≥ 0 F(t) = 1 - e^{-\lambda t}, \quad \text{对于 } t \ge 0
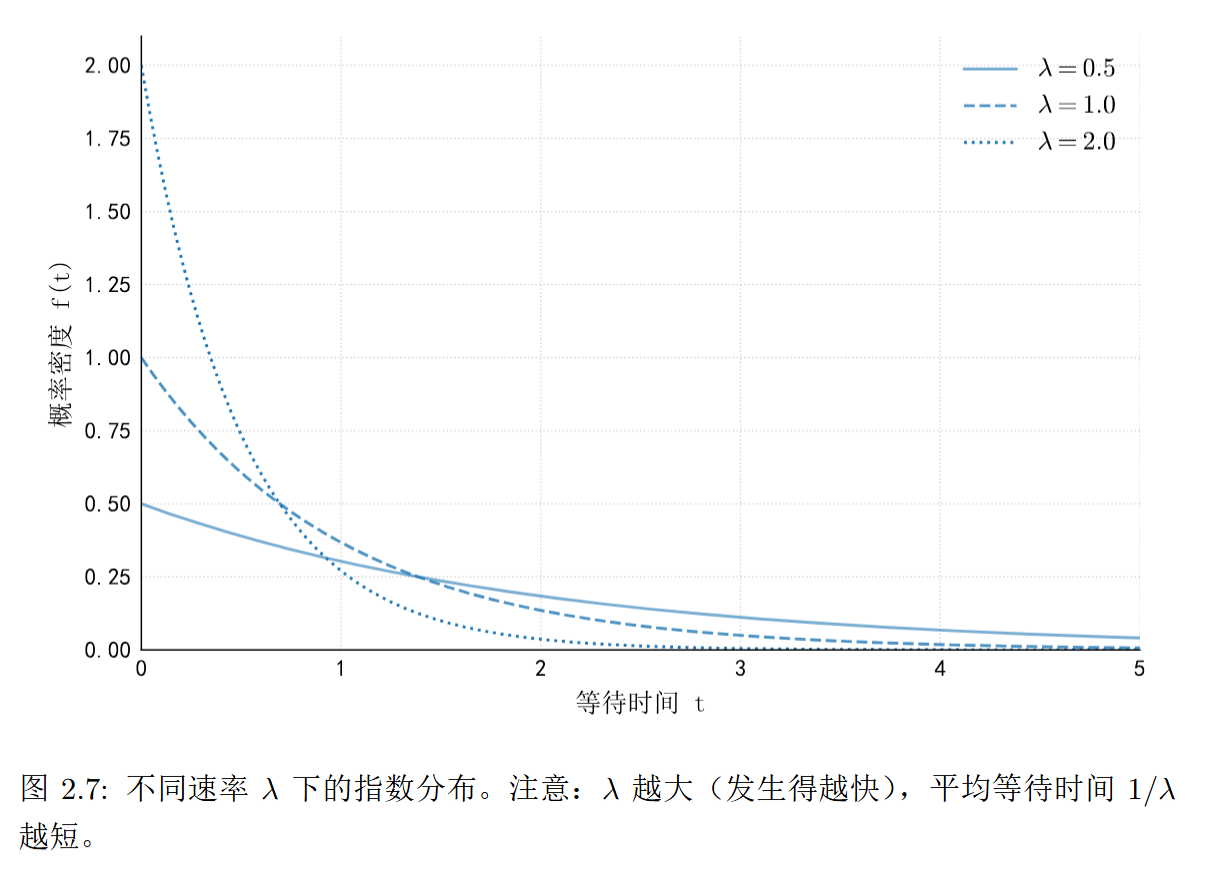
结合图,我们一起来看这个公式。
首先,看它的形状。当 t = 0 t = 0 f ( 0 ) = λ f(0) = \lambda λ \lambda t t e − λ t e^{-\lambda t} f ( t ) f(t) λ \lambda
那么,λ \lambda 这是最关键的,也是最容易误解的地方 。请你先在心里想一个答案:λ \lambda
很多人的第一反应是:λ \lambda f ( 0 ) = λ f(0)=\lambda
这个直觉是对的,但我们需要更精确。
在泊松分布中,λ \lambda “单位时间内事件发生的平均次数” ,我们称之为速率 。比如,λ = 0.5 \lambda = 0.5 λ \lambda
如果事件发生得“快”(λ \lambda λ \lambda λ \lambda 反比 关系。
事实正是如此。我们可以计算指数分布的期望(平均等待时间):
E [ T ] = ∫ 0 ∞ t ⋅ λ e − λ t d t = 1 λ E[T] = \int_{0}^{\infty} t \cdot \lambda e^{-\lambda t} \, dt = \frac{1}{\lambda}
E [ T ] = 1 / λ E[T] = 1/\lambda
λ = 0.5 \lambda = 0.5 1 / λ = 2 1/\lambda = 2 λ = 2 \lambda = 2 1 / λ = 0.5 1/\lambda = 0.5 这一块大家最容易晕。教你个简单的记法:把 λ \lambda λ \lambda 1 / λ 1/\lambda λ \lambda 1 / λ 1/\lambda λ \lambda λ \lambda
顺便提一句方差 。指数分布的方差是 Var [ T ] = 1 / λ 2 \text{Var}[T] = 1/\lambda^{2} 1 / λ 1/\lambda λ \lambda 波动性(方差)也会非常大 ,不确定性很高。反之,如果事件发生很频繁(λ \lambda
【例题】咖啡馆的等待 λ = 12 \lambda = 12 这就是指数分布的问题了。它关注的是“间隔时间”。我们需要 P ( T > 10 分钟 ) P(T > 10\text{分钟})
首先统一单位:λ = 12 \lambda = 12 = 0.2 = 0.2 P ( T > t ) = e − λ t P(T > t) = e^{-\lambda t}
P ( T > 10 ) = e − 0.2 × 10 = e − 2 ≈ 0.1353 P(T > 10) = e^{-0.2 \times 10} = e^{-2} \approx 0.1353
这意味着你有大约13.5%的概率能享受长达10分钟的清静。
生存函数与无记忆性 概率密度函数 f ( t ) f(t) t t P ( T > t ) P(T > t)
这个概率有一个专门的名字,叫生存函数 (Survival Function),我们记作 S ( t ) S(t)
P ( T > t ) = S ( t ) = ∫ t ∞ λ e − λ x d x = e − λ t P(T > t) = S(t) = \int_{t}^{\infty} \lambda e^{-\lambda x} \, dx = e^{-\lambda t}
多干净的结果。S ( t ) = e − λ t S(t) = e^{-\lambda t} S ( 0 ) = 1 S(0)=1 t t
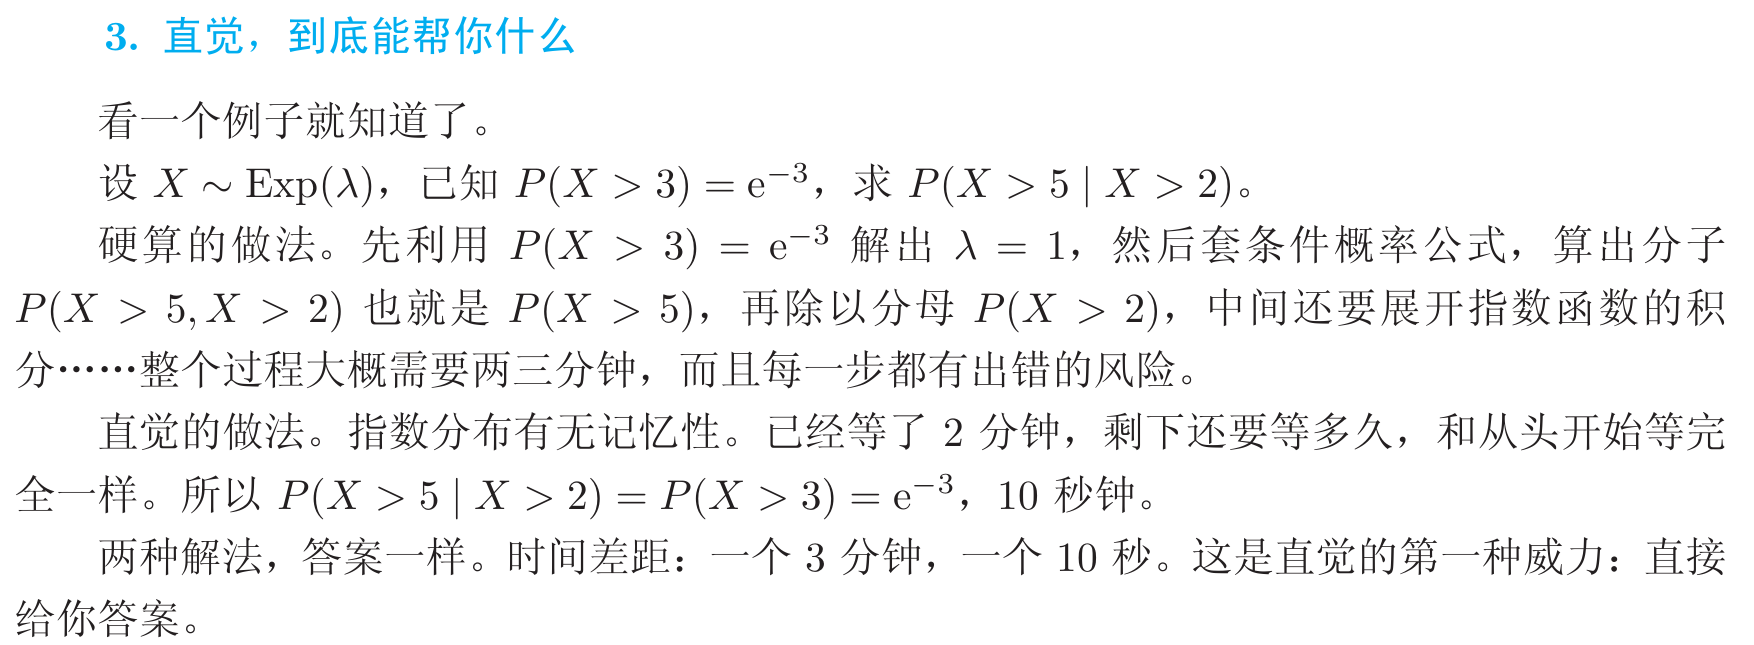
现在,我们来探讨指数分布最奇特、也最核心的性质——无记忆性 。
让我们回到那个新路由器的例子。假设它的寿命 T T λ = 1 / 3 \lambda = 1/3 T > 1 T > 1 再 坚持至少2年的概率,也就是 P ( T > 3 | T > 1 ) P(T > 3 | T > 1)
你的直觉会怎么回答?很多人会觉得:“它已经用了一年了,是个‘旧’路由器了,肯定比新的时候更容易坏。所以这个条件概率应该比一台全新路由器坚持2年的概率 P ( T > 2 ) P(T > 2)
这是非常符合生活经验的直觉。但对于指数分布所描述的“等待”,这个直觉是错的 。
我们来严格计算并证明一下。根据条件概率的定义:
P ( T > s + t | T > s ) = P ( { T > s + t } ∩ { T > s } ) P ( T > s ) = P ( T > s + t ) P ( T > s ) , P(T > s + t | T > s) = \frac{P( \{T > s+t\} \cap \{T > s\} )}{P(T > s)} = \frac{P(T > s+t)}{P(T > s)},
因为 T > s + t T > s+t T > s T > s
现在代入指数分布的生存函数 S ( t ) = e − λ t S(t) = e^{-\lambda t}
P ( T > s + t | T > s ) = e − λ ( s + t ) e − λ s = e − λ t P(T > s + t | T > s) = \frac{e^{-\lambda (s+t)}}{e^{-\lambda s}} = e^{-\lambda t}
而 e − λ t e^{-\lambda t} P ( T > t ) P(T > t)
因此,我们证明了:
P ( T > s + t | T > s ) = P ( T > t ) , 对于所有的 s , t ≥ 0 P(T > s + t | T > s) = P(T > t), \quad \text{对于所有的 } s, t \ge 0
这意味着,无论它已经工作了多久(s s t t 过去的等待,不会消耗它的“未来”。它就像一个被重置 了记忆的系统。
这就是无记忆性 。
这个性质反直觉,是因为人是“有记忆”的。活得越久,离死亡就越近,因为人的细胞在老化,身体里有“计时器”。
但指数分布描述的世界里,没有皱纹,没有疲劳。一个原子核,不管它已经存在了一亿年还是刚诞生一秒钟,它下一刻衰变的概率是一模一样的。它永远年轻,永远只有“当下”。 这就是为什么我们说它是“无记忆”的——过去的时间,没有在它身上留下任何痕迹。
指数分布所模拟的,是一种 “纯粹的随机冲击” 导致的等待。它假定设备的损坏不是由于“磨损”(磨损是有记忆的,用越久状态越差),而是由于外部的、完全随机的电压浪涌、宇宙射线击中关键电路等事件。对于这种完全随机的“致命一击”来说,每一刻都是崭新的,过去的幸免于难不会给你带来任何“经验值”或“损耗度”。
所以,当你使用指数分布来建模时,你心里必须清楚:你假设了这个等待过程是“无记忆”的 。这既是它威力强大的地方,也是它应用时必须小心的边界。
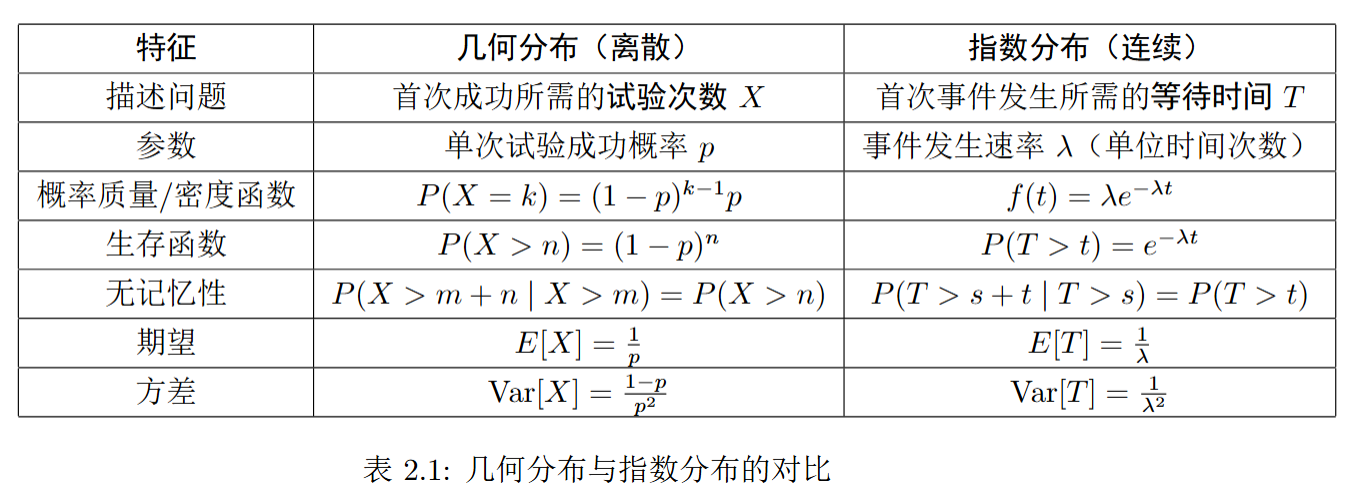
几何分布和指数分布有什么联系? 现在我们把连续的指数分布,和离散的几何分布放在一起看看。这种高度的相似性不是巧合,因为它们的底层逻辑都是“无记忆性”。
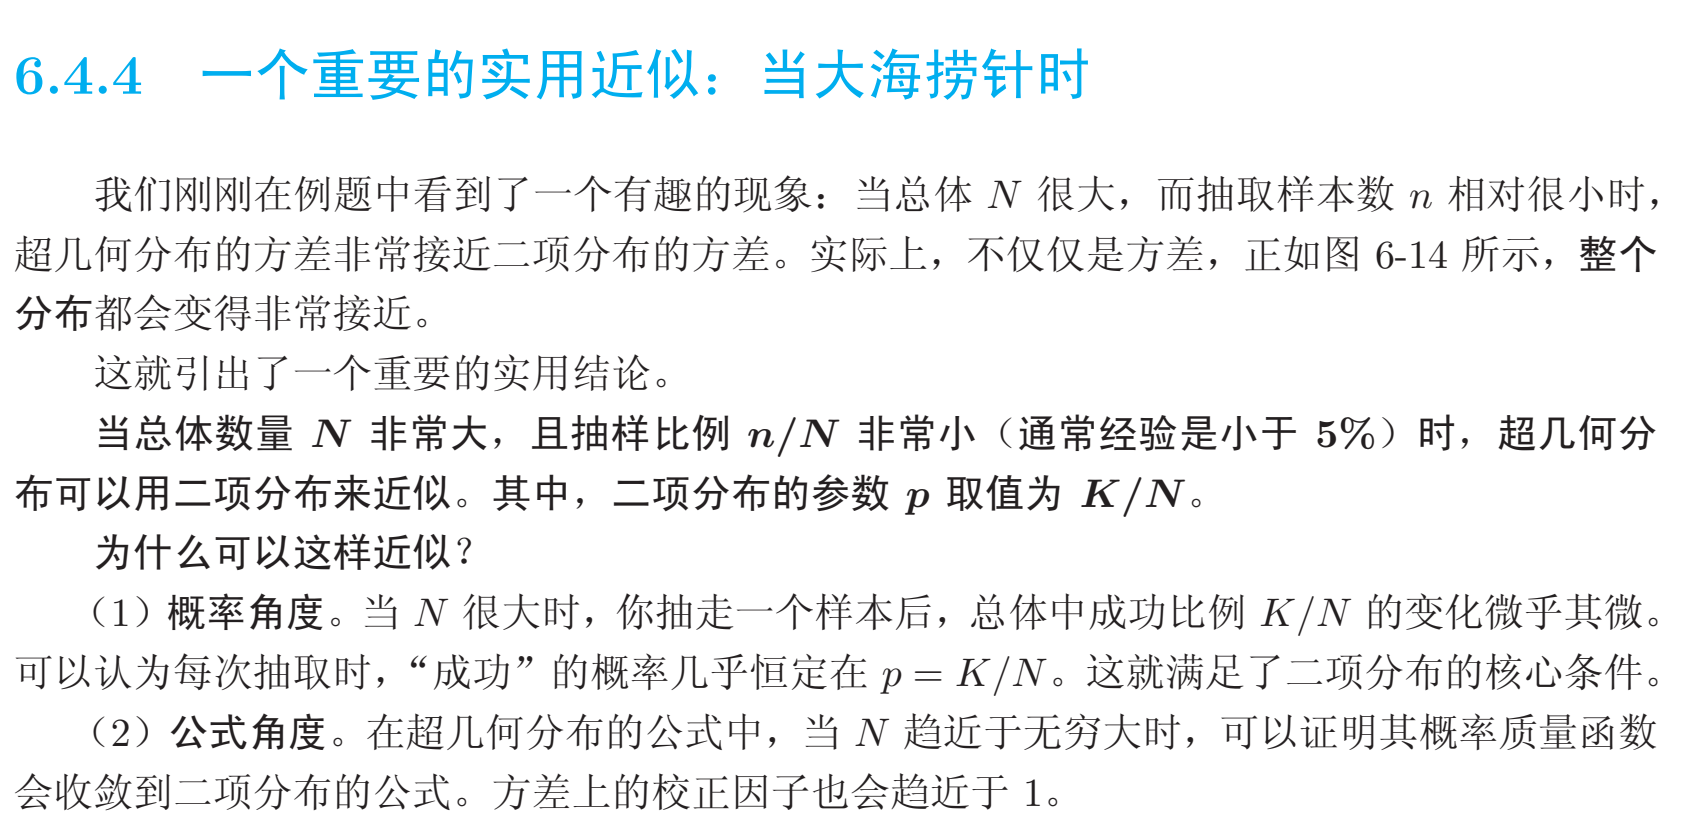
在几何分布中,成功概率 p = 0.1 p=0.1 1 / p = 10 1/p=10 在指数分布中,发生速率 λ = 0.1 \lambda=0.1 1 / λ = 10 1/\lambda=10 如图所示的直觉对应 :你可以把连续的指数分布想象成,将离散的几何分布中的每一次“试验”无限细分,变成无穷小的时间片段 Δ t \Delta t p = λ Δ t p = \lambda \Delta t Δ t → 0 \Delta t \to 0 ( 1 − p ) n (1-p)^n e − λ t e^{-\lambda t}
更多例题与常见误区 【例题】客服电话(混淆速率与概率) λ = 1 / 6 \lambda = 1/6 常见错误思路 :直接想,平均6分钟一个,那么3分钟内来的概率是 3 / 6 = 0.5 3/6 = 0.5 1 / 6 1/6 λ \lambda 3 / 6 3/6 平均呼叫次数 ,不是概率。正确思路 :这是一个指数分布问题 T ∼ Exp ( 1 / 6 ) T \sim \text{Exp}(1/6) P ( T ≤ 3 ) P(T \le 3) P ( T ≤ 3 ) = 1 − e − ( 1 / 6 ) × 3 = 1 − e − 0.5 ≈ 1 − 0.6065 = 0.3935 P(T \le 3) = 1 - e^{-(1/6) \times 3} = 1 - e^{-0.5} \approx 1 - 0.6065 = 0.3935 所以概率约为39.35%,而不是50%。 【例题】网络连接请求(无记忆性的应用) T T 求速率 λ \lambda 下一个请求等待时间超过10ms的概率。 已经等了5ms还没请求,再等超过5ms(即总时间超过10ms)的概率。
解答:
1 / λ = 8 ms 1/\lambda = 8 \text{ ms} ⇒ \Rightarrow λ = 0.125 /ms \lambda = 0.125 \text{ /ms} P ( T > 10 ) = e − 0.125 × 10 = e − 1.25 ≈ 0.2865 P(T>10) = e^{-0.125 \times 10} = e^{-1.25} \approx 0.2865 利用无记忆性 :P ( T > 10 | T > 5 ) = P ( T > 5 ) = e − 0.125 × 5 = e − 0.625 ≈ 0.5353 P(T>10 | T>5) = P(T>5) = e^{-0.125 \times 5} = e^{-0.625} \approx 0.5353 注意对比 :无条件等待超过10ms的概率是0.2865,但在已经等了5ms的条件下,再等超过5ms的概率是0.5353。条件概率改变了,但符合无记忆性公式:它等于从0开始等待5ms的概率。【例题】设备保修策略(综合计算) T T E [ T ] = 4 E[T]=4 λ = 0.25 \lambda=0.25 该元件在保修期内失效的概率是多少? P ( T ≤ 1 ) = 1 − e − 0.25 × 1 = 1 − e − 0.25 ≈ 1 − 0.7788 = 0.2212 P(T \le 1) = 1 - e^{-0.25 \times 1} = 1 - e^{-0.25} \approx 1 - 0.7788 = 0.2212 如果一个元件已经使用了2年未坏,它在接下来一年内失效的概率是多少? 这里问的是条件概率 P ( T ≤ 3 | T > 2 ) P(T \le 3 | T > 2) 解法一(利用无记忆性):这等于一个全新元件在一年内失效的概率,即 P ( T ≤ 1 ) ≈ 0.2212 P(T \le 1) \approx 0.2212 解法二(直接计算): P ( T ≤ 3 | T > 2 ) = P ( 2 < T ≤ 3 ) P ( T > 2 ) = e − 0.5 − e − 0.75 e − 0.5 = 1 − e − 0.25 ≈ 0.2212 P(T \le 3 | T > 2) = \frac{P(2 < T \le 3)}{P(T > 2)} = \frac{e^{-0.5} - e^{-0.75}}{e^{-0.5}} = 1 - e^{-0.25} \approx 0.2212
公司考虑将保修期延长至多久,才能使保修期内失效的概率接近50%? 我们需要解 P ( T ≤ w ) = 1 − e − 0.25 w = 0.5 P(T \le w) = 1 - e^{-0.25w} = 0.5 w ≈ 2.77 年 w \approx 2.77 \text{ 年} 通过这些例题,希望大家能体会:指数分布的计算核心在于熟练运用 CDF: F ( t ) = 1 − e − λ t \text{CDF: } F(t)=1-e^{-\lambda t} 生存函数: S ( t ) = e − λ t \text{生存函数: } S(t)=e^{-\lambda t}
最小值问题:多个指数分布竞争谁先发生 在均匀分布一节中,我们研究了 n n
问题 :设有 n n X 1 , X 2 , … , X n X_1, X_2, \ldots, X_n X i X_i λ i \lambda_i X i ∼ Exp ( λ i ) X_i \sim \text{Exp}(\lambda_i) M = min ( X 1 , X 2 , … , X n ) M = \min(X_1, X_2, \ldots, X_n) M M
思考过程 :我们先凭直觉猜一下。如果每个 X i X_i M M M M X i X_i
让我们用概率的语言来分析。最小值 M M t t M M t t 所有 n n 都大于 t t
对于单个 X i ∼ Exp ( λ i ) X_i \sim \text{Exp}(\lambda_i) P ( X i > t ) = e − λ i t P(X_i > t) = e^{-\lambda_i t} 由于独立性,所有变量都大于 t t P ( M > t ) = P ( X 1 > t , X 2 > t , … , X n > t ) = ∏ i = 1 n P ( X i > t ) = ∏ i = 1 n e − λ i t P(M > t) = P(X_1 > t, X_2 > t, \ldots, X_n > t) = \prod_{i=1}^n P(X_i > t) = \prod_{i=1}^n e^{-\lambda_i t} 整理一下:
P ( M > t ) = e − ( λ 1 + λ 2 + ⋯ + λ n ) t = e − ( ∑ i = 1 n λ i ) t P(M > t) = e^{-(\lambda_1 + \lambda_2 + \cdots + \lambda_n)t} = e^{-\left(\sum_{i=1}^n \lambda_i\right) t}
这正好是指数分布 Exp ( ∑ i = 1 n λ i ) \text{Exp}\left(\sum_{i=1}^n \lambda_i\right)
多个独立指数分布的最小值,仍然服从指数分布,其参数是各个参数之和。
用数学语言说:如果 X i ∼ Exp ( λ i ) X_i \sim \text{Exp}(\lambda_i)
M = min ( X 1 , X 2 , … , X n ) ∼ Exp ( ∑ i = 1 n λ i ) M = \min(X_1, X_2, \ldots, X_n) \sim \text{Exp}\left(\sum_{i=1}^n \lambda_i\right)
期望值 :根据指数分布的性质,M M
E [ M ] = 1 ∑ i = 1 n λ i E[M] = \frac{1}{\sum_{i=1}^n \lambda_i}
特例 :如果所有 λ i \lambda_i λ 1 = λ 2 = ⋯ = λ n = λ \lambda_1 = \lambda_2 = \cdots = \lambda_n = \lambda
M ∼ Exp ( n λ ) , E [ M ] = 1 n λ M \sim \text{Exp}(n\lambda), \quad E[M] = \frac{1}{n\lambda}
这意味着什么?假设每个设备单独的平均寿命是10年(λ = 0.1 \lambda=0.1 1 / ( 10 × 0.1 ) = 1 1/(10\times0.1) = 1
【例题】系统可靠性分析 部件A:平均寿命20小时(λ A = 0.05 \lambda_A = 0.05 部件B:平均寿命30小时(λ B ≈ 0.0333 \lambda_B \approx 0.0333 部件C:平均寿命60小时(λ C ≈ 0.0167 \lambda_C \approx 0.0167 求系统的平均寿命(即第一个部件失效的时间)。
解答: 系统的寿命 T sys T_{\text{sys}} T sys = min ( T A , T B , T C ) T_{\text{sys}} = \min(T_A, T_B, T_C)
λ total = λ A + λ B + λ C = 0.05 + 0.0333 + 0.0167 = 0.1 \lambda_{\text{total}} = \lambda_A + \lambda_B + \lambda_C = 0.05 + 0.0333 + 0.0167 = 0.1
所以系统寿命服从 Exp ( 0.1 ) \text{Exp}(0.1)
E [ T sys ] = 1 0.1 = 10 小时 E[T_{\text{sys}}] = \frac{1}{0.1} = 10 \text{ 小时}
虽然单个部件平均寿命有20、30、60小时,但系统整体平均寿命只有10小时!对于这种串联系统,只要有一个部件先坏,整个系统就不能正常工作了。
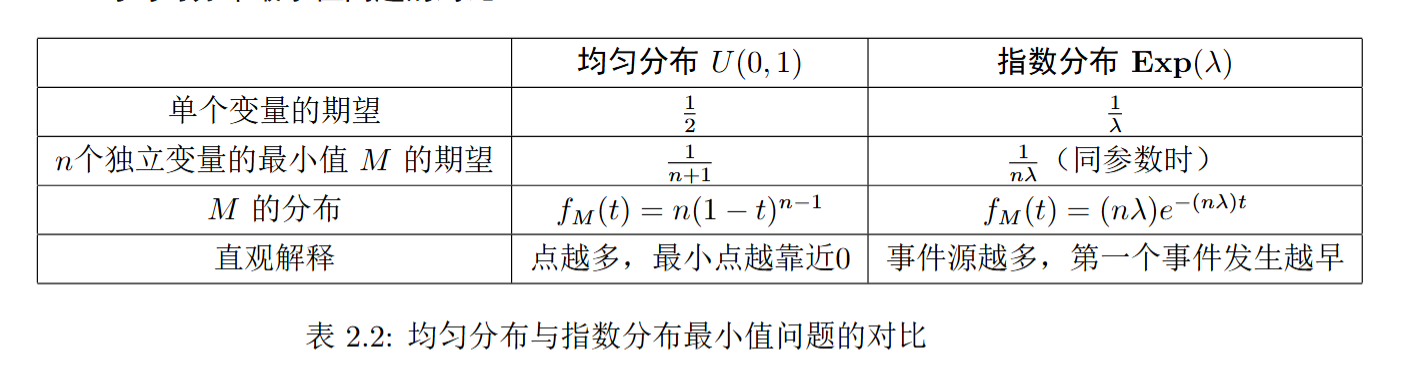
与均匀分布最小值问题的对比 :
注意到对比表格中最有趣的一点了吗?对于均匀分布,n n M M f M ( t ) = n ( 1 − t ) n − 1 f_M(t) = n(1-t)^{n-1}
但对于指数分布,情况完全不同:n n M M f M ( t ) = ( n λ ) e − ( n λ ) t f_M(t) = (n\lambda)e^{-(n\lambda)t} 仍然是一个指数分布 。只是参数从原来的 λ \lambda n λ n\lambda
这是什么概念?这意味着指数分布在“取最小值”这个操作下是封闭 的——你从指数分布家族中取出几个成员,对它们取最小值,得到的还是一个指数分布家族的成员。
为什么指数分布的最小值仍然服从指数分布?当我们同时启动 n n t t t t t t
正是因为每个时钟在任何时刻都“记不住”自己已经走了多久,所以多个这样的时钟同时运行,整个系统在任何时刻的“未来行为”都和刚开始时完全相同。这种“时间平移不变性”使得整个过程的统计特性始终保持指数分布的形式。
这个性质不仅仅是数学上的巧合。在实际应用中,比如:
排队论 :多个服务台同时服务顾客,每个服务时间服从指数分布。那么第一个服务台空闲的时间(即最短的服务时间)仍然服从指数分布。可靠性工程 :多个部件组成串联系统,每个部件的寿命服从指数分布。系统失效时间(即最短的部件寿命)仍然服从指数分布。生存分析 :多个独立风险因素同时威胁生命,每个风险的发生时间服从指数分布。那么首次风险发生的时间仍然服从指数分布。指数分布的这种“封闭性”使得它在这些领域的建模和分析中特别方便——我们不需要引入新的分布类型来描述“最小值”的行为。
和其他分布的联系 到这里,指数分布的核心性质基本就交代清楚了。最后,我们稍微往外扩展一下,看看它在整个概率论体系中的位置。
回望:与几何分布的深刻类比 我们已经详细对比过了。它们一个是离散等待的分布,一个是连续等待的分布,共享着“无记忆”的特征。理解其中一个,会极大地帮助理解另一个。
前瞻之一:伽马分布——等待不止一次 现在,我们只等了“第一次”事件发生。如果我要等“第 k k 伽马分布 。而指数分布,恰恰是伽马分布家族中,当形状参数 k = 1 k=1 k k
前瞻之二:威布尔分布——当“无记忆性”需要放宽 有些敏锐的读者可能会思考:现实中的设备寿命,真的完全服从指数分布吗?似乎不完全对。新车和开了十年的旧车,发动机突然故障的可能性肯定不一样。机械疲劳、材料老化是存在的。 是的,你说到了关键。指数分布的“无记忆性”和恒定失效率(λ \lambda 过强的简化 。这时,我们就需要更灵活的分布,比如威布尔分布 。 威布尔分布通过引入一个额外的形状参数 ,可以描述失效率随时间递增(磨损)、递减(早期磨合期失效)或恒定(此时退化为指数分布)的情况。指数分布可以看作是威布尔分布描述“恒定风险”时的特例。
总结 指数分布描述的,是不考虑磨损、事件随机发生的等待过程。
我们要记住的其实就三点:第一,λ \lambda
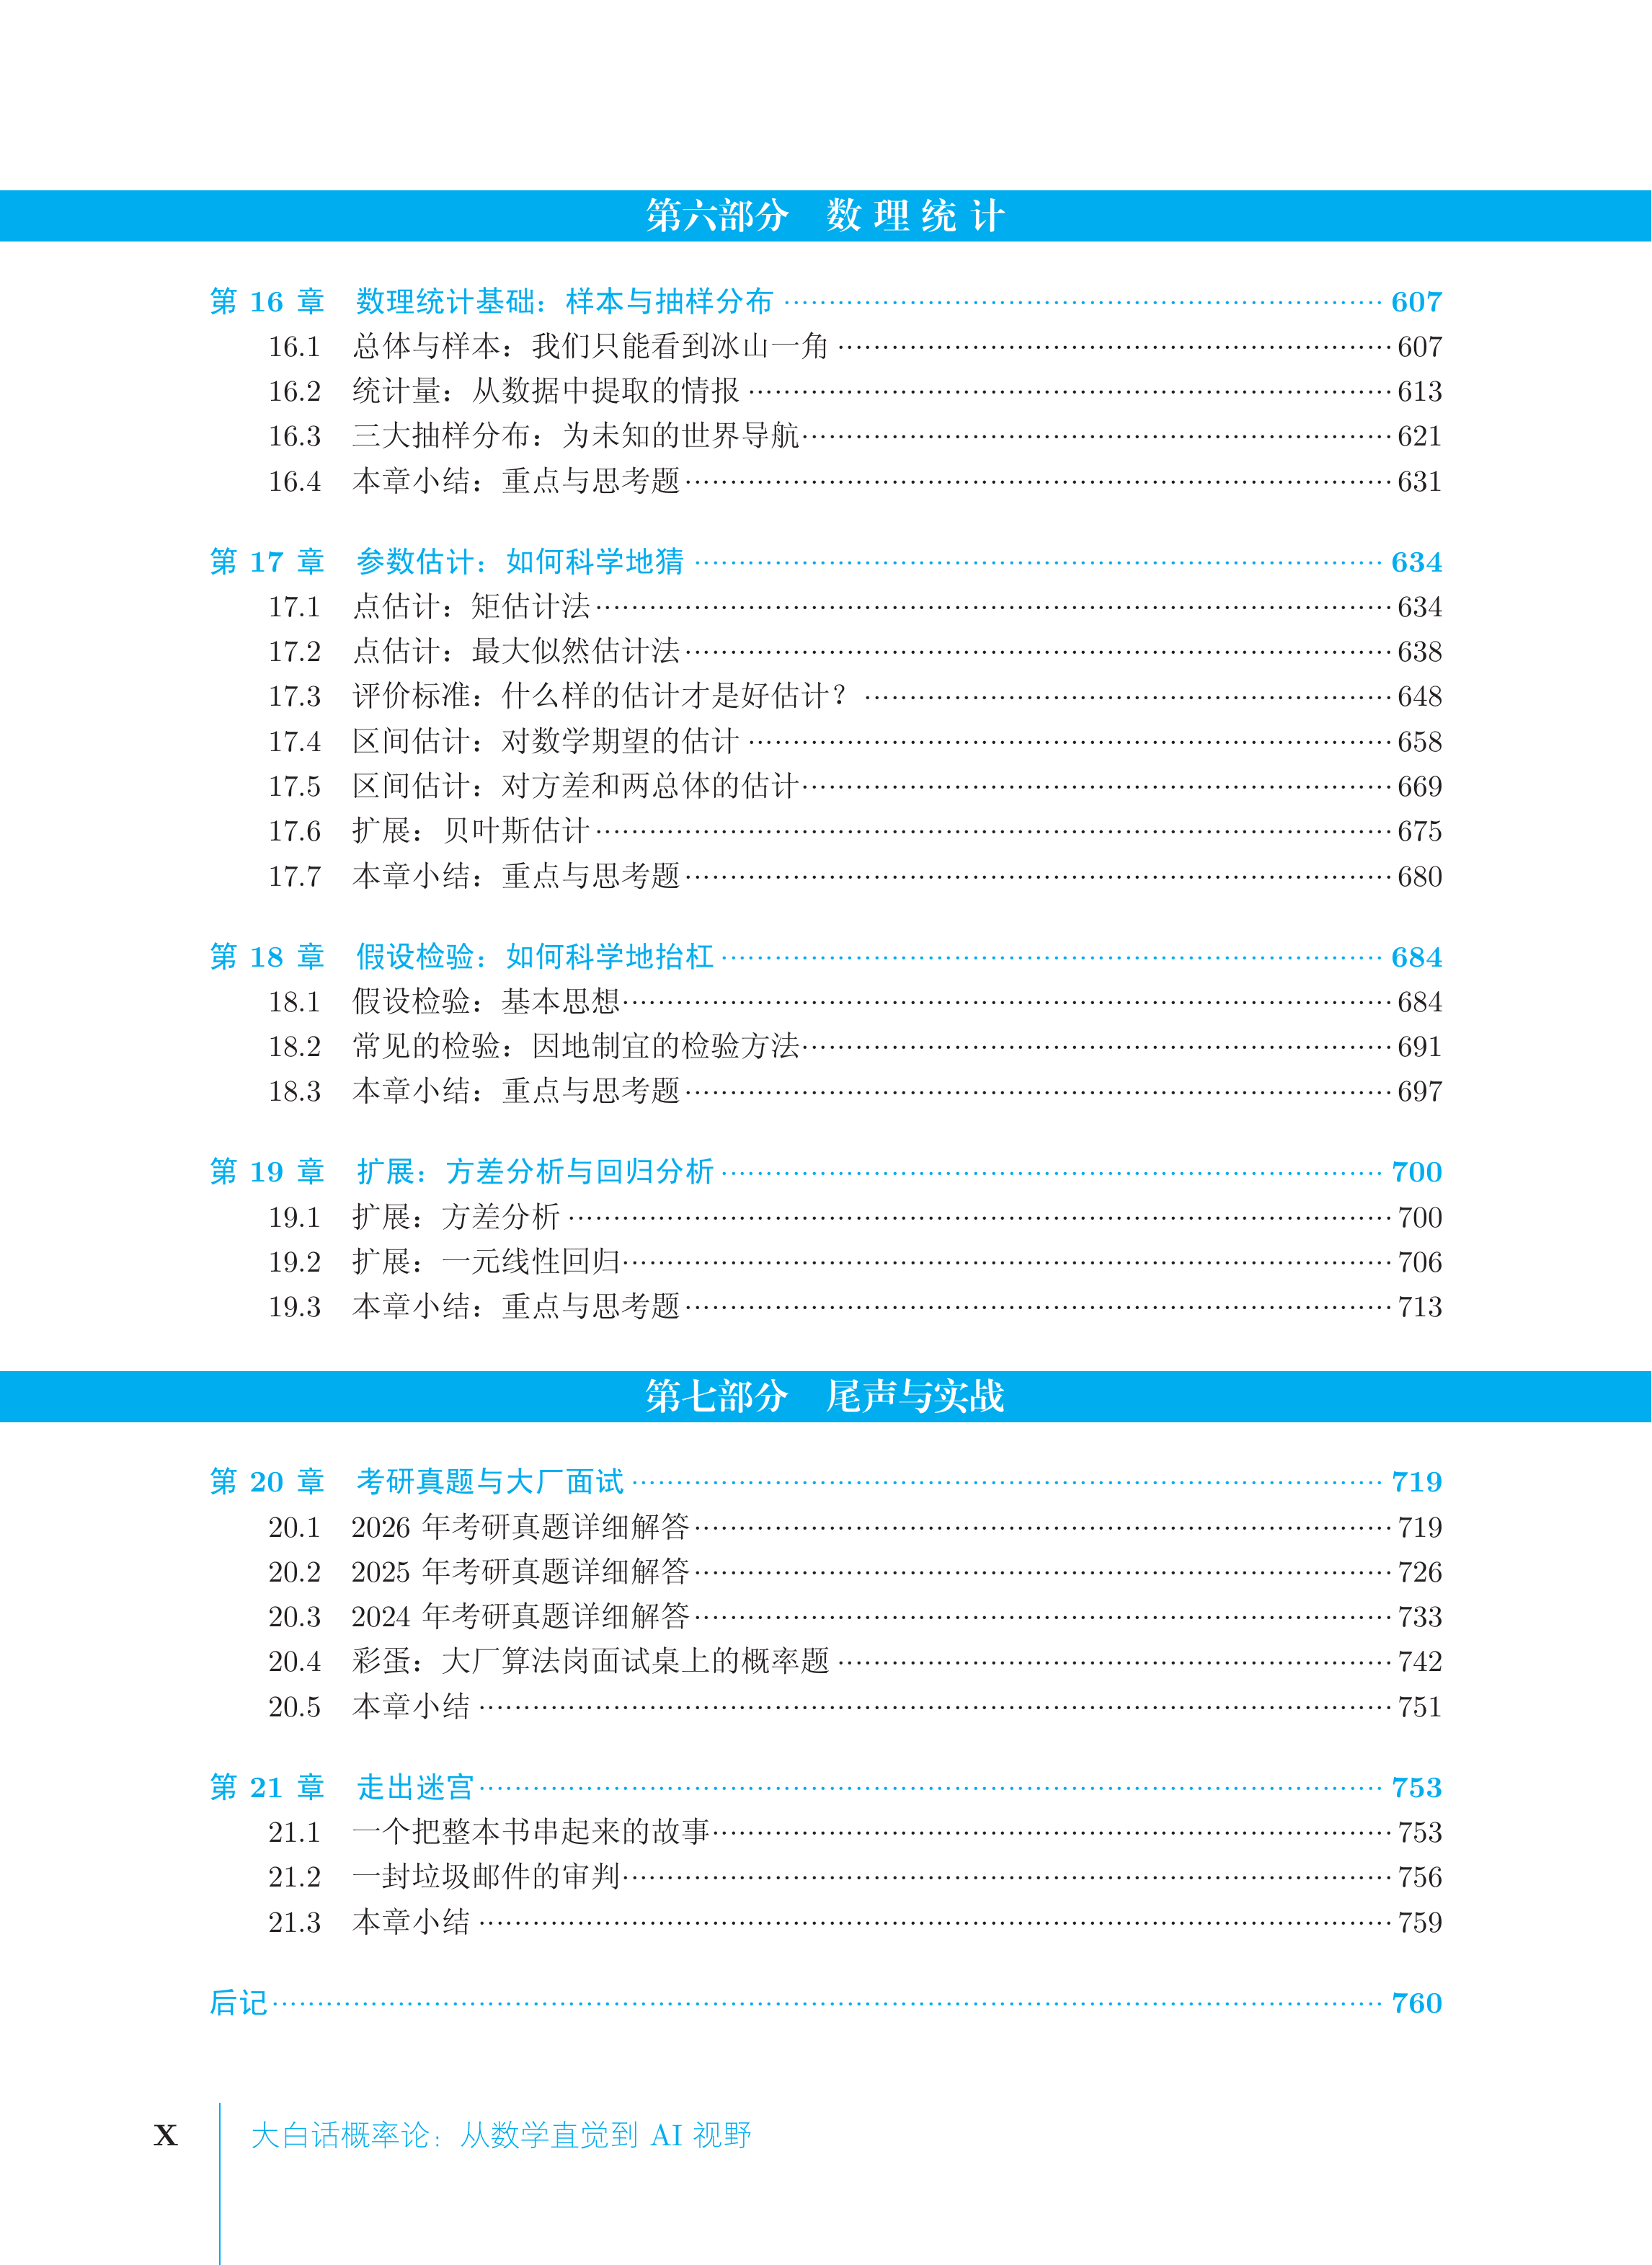
AI视野 【AI Box】L1正则化为什么能让模型变稀疏? e − | x | e^{-|x|} 关于这本书 这篇文章节选自我的新书《大白话概率论:从数学直觉到AI视野》,现在已经正式出版了。之前有不少朋友在评论区问出版进度,谢谢大家一直以来的关注和耐心等待。
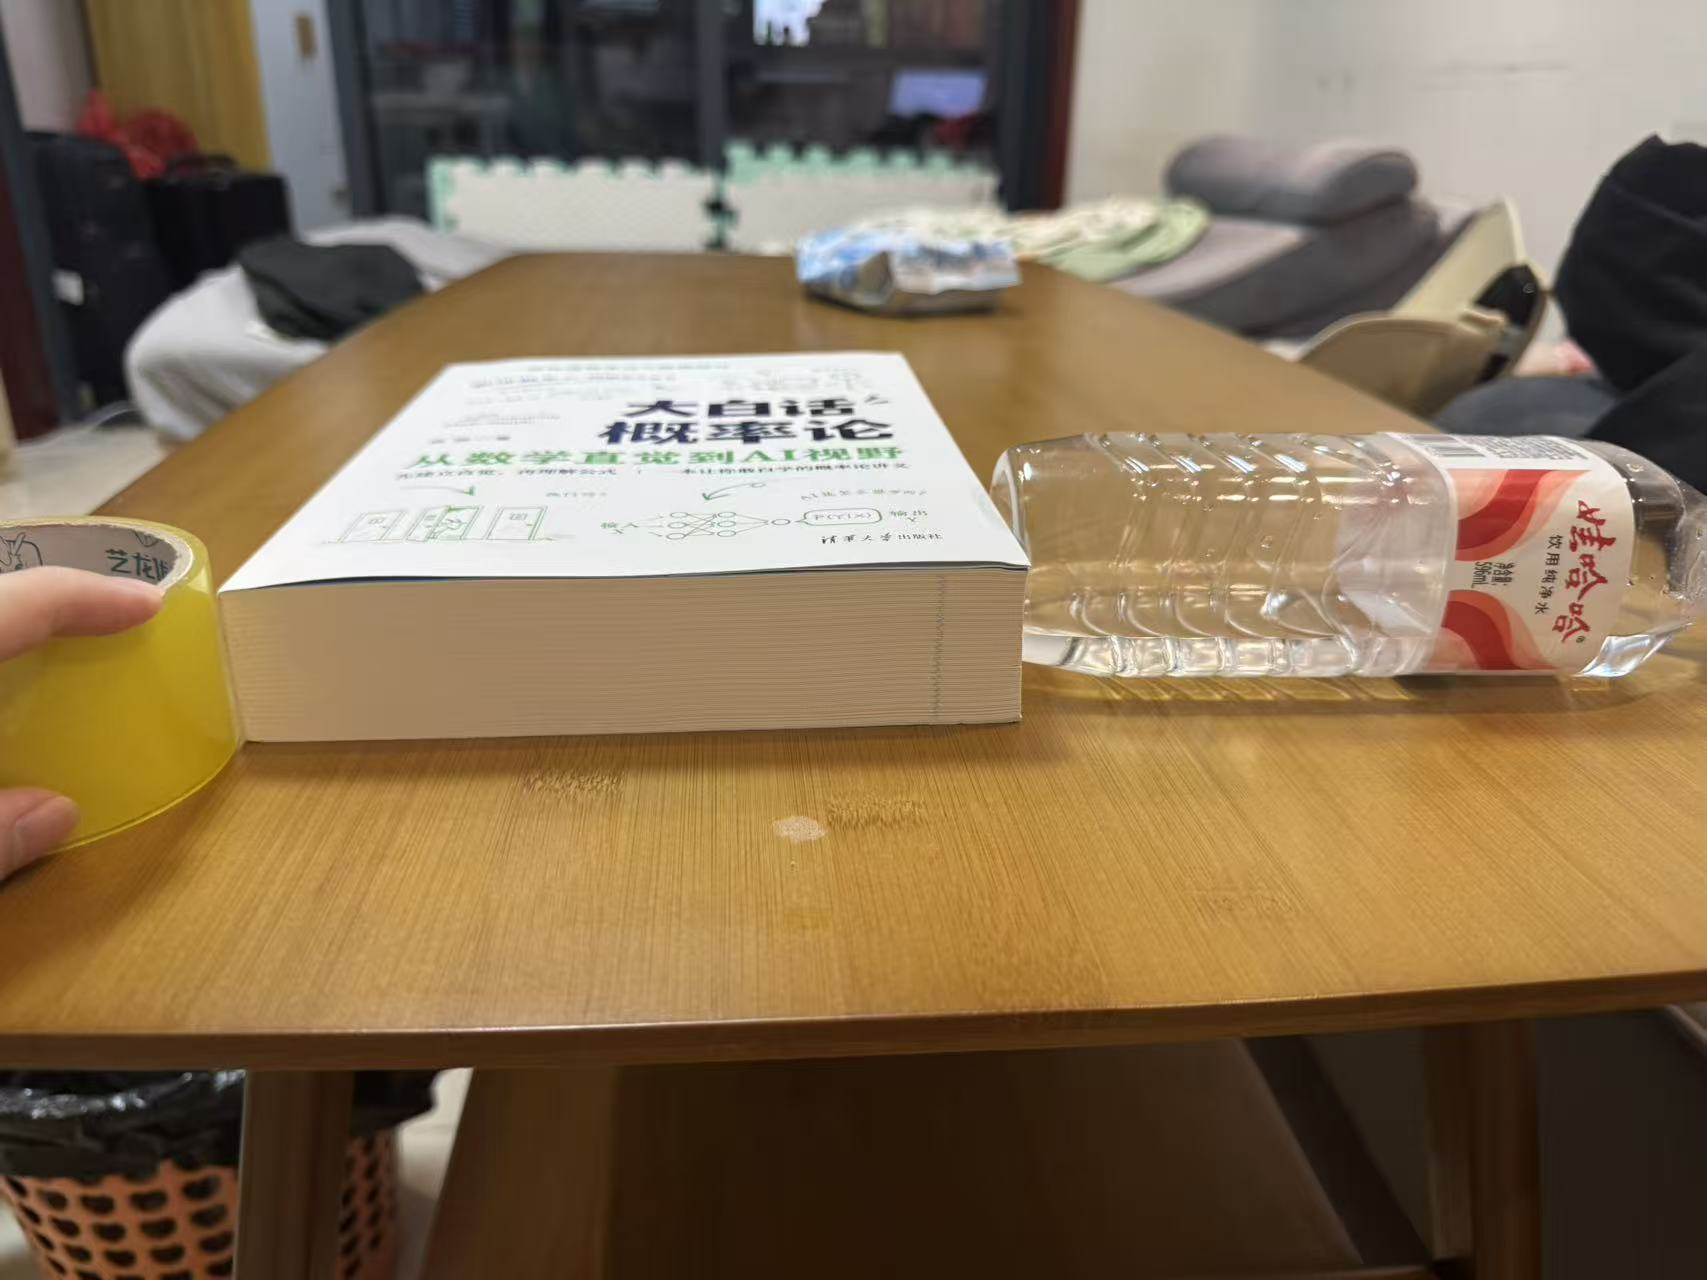
这是一本面向自学者的概率论与数理统计教材,700多页。我写这本书时,最想做的就是把概念和公式背后的道理讲清楚:为什么要引入这个概念?这个公式是怎么来的?它和前面学过的东西有什么联系?所以书里用了很多生活中的例子,也保留了详细的推导,希望大家读的时候能够跟得上。
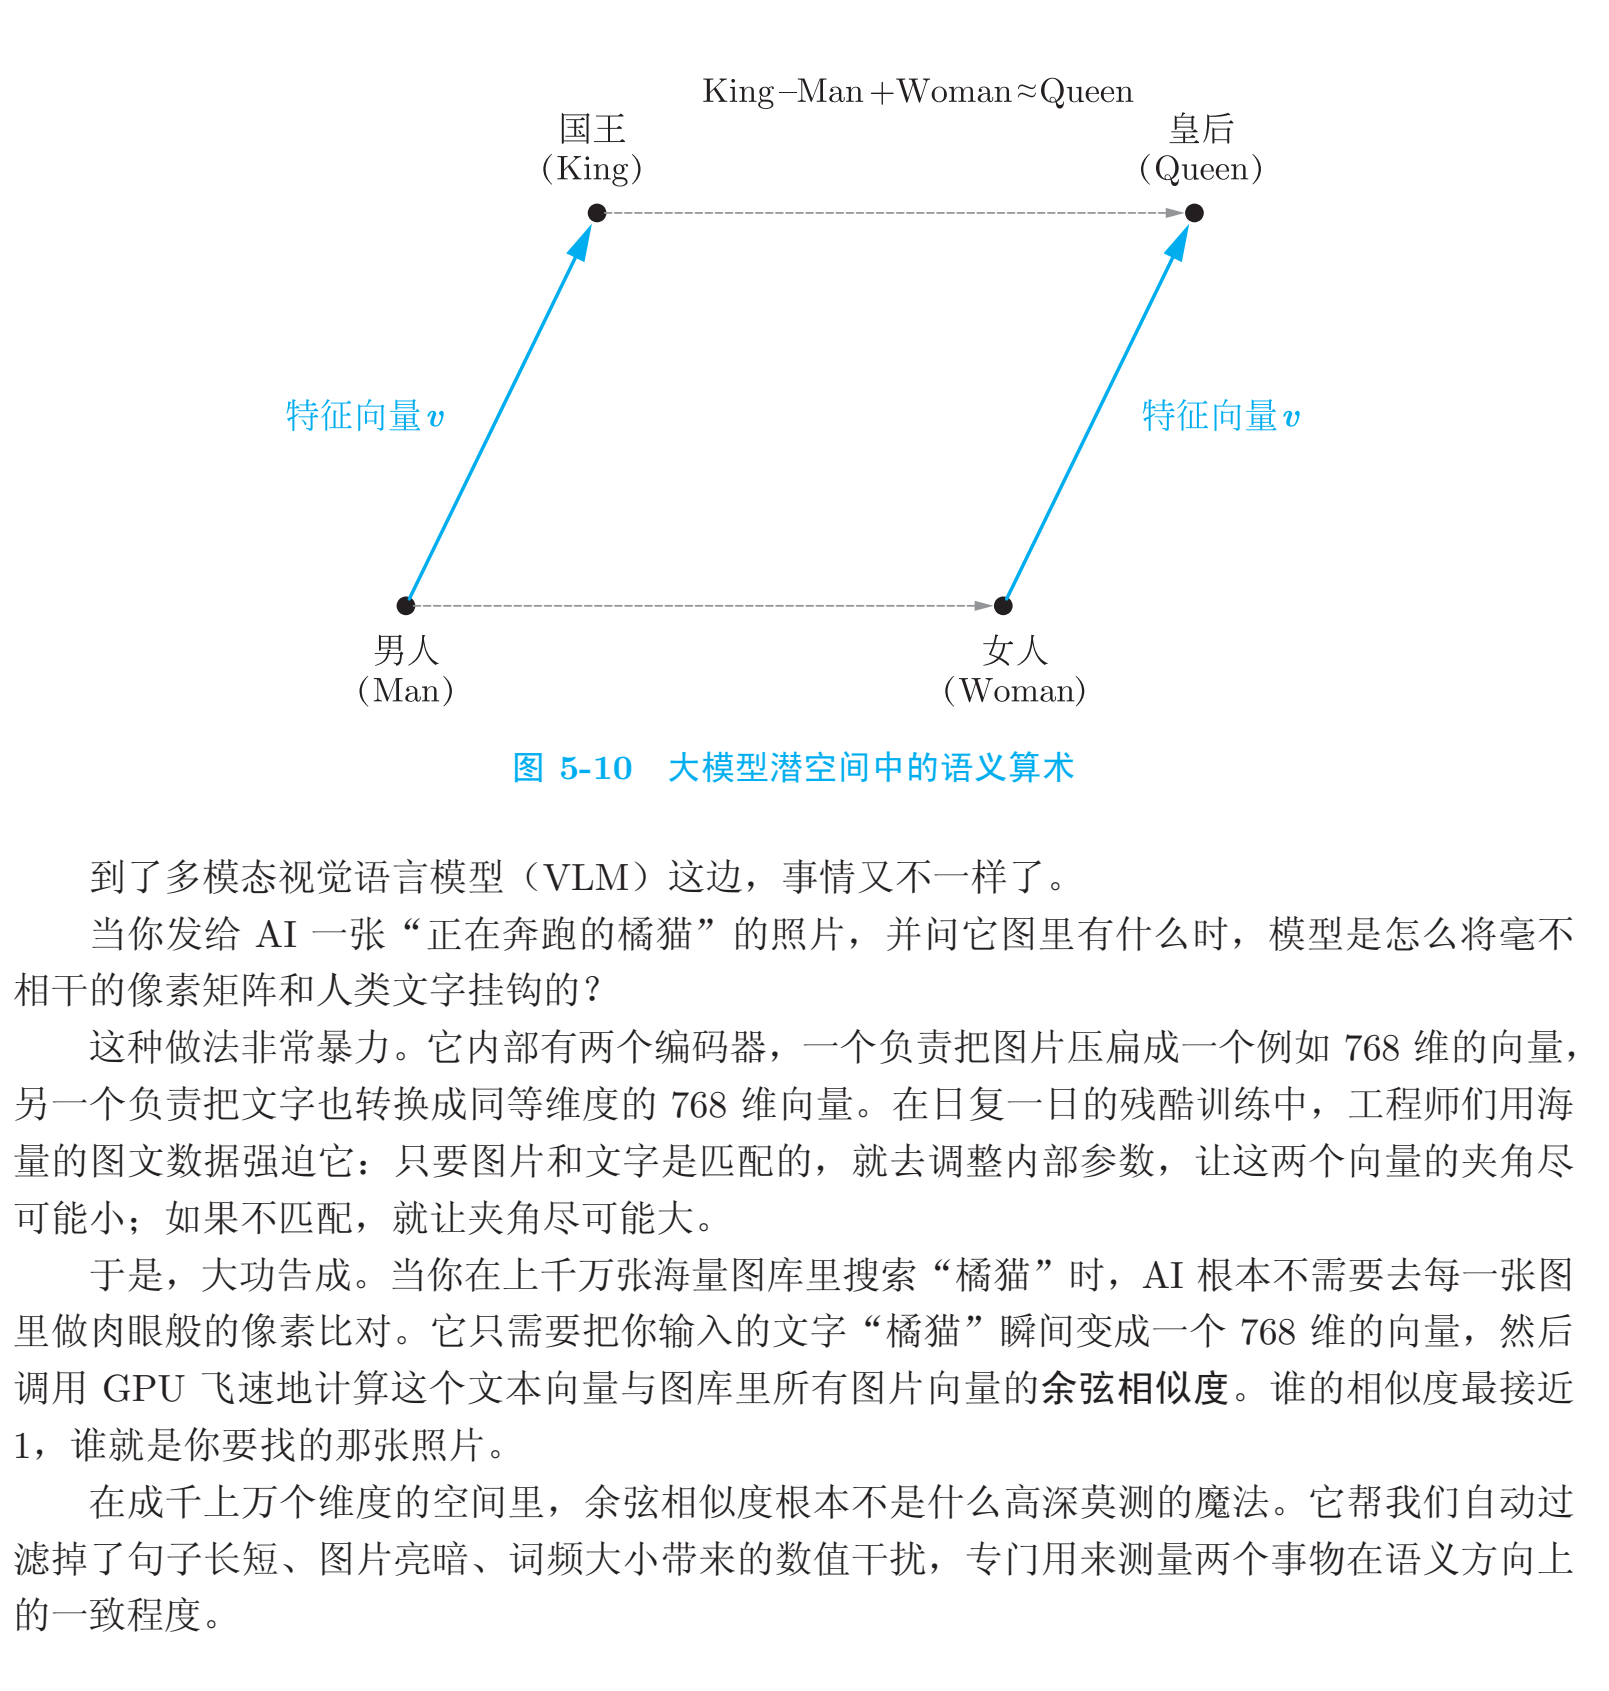
书里也结合了不少AI相关内容,比如softmax、余弦相似度、交叉熵和KL散度。各节还穿插了“AI视野”和“Python实验室”,介绍这些数学知识在AI中怎么用,也通过代码做一些模拟和验证。
如果你正在准备考研,书中还收录了2024—2026年考研数学一、数学三的部分概率论真题,以及大厂算法岗面试题的详细解答。
正在自学概率论、准备考研,或者学习AI时想补一补数学基础的朋友,都可以看看。下面附上完整目录,大家可以先看看具体讲了哪些内容,再决定是否适合自己。购买链接也放在这里了,感兴趣的话可以点进去了解。
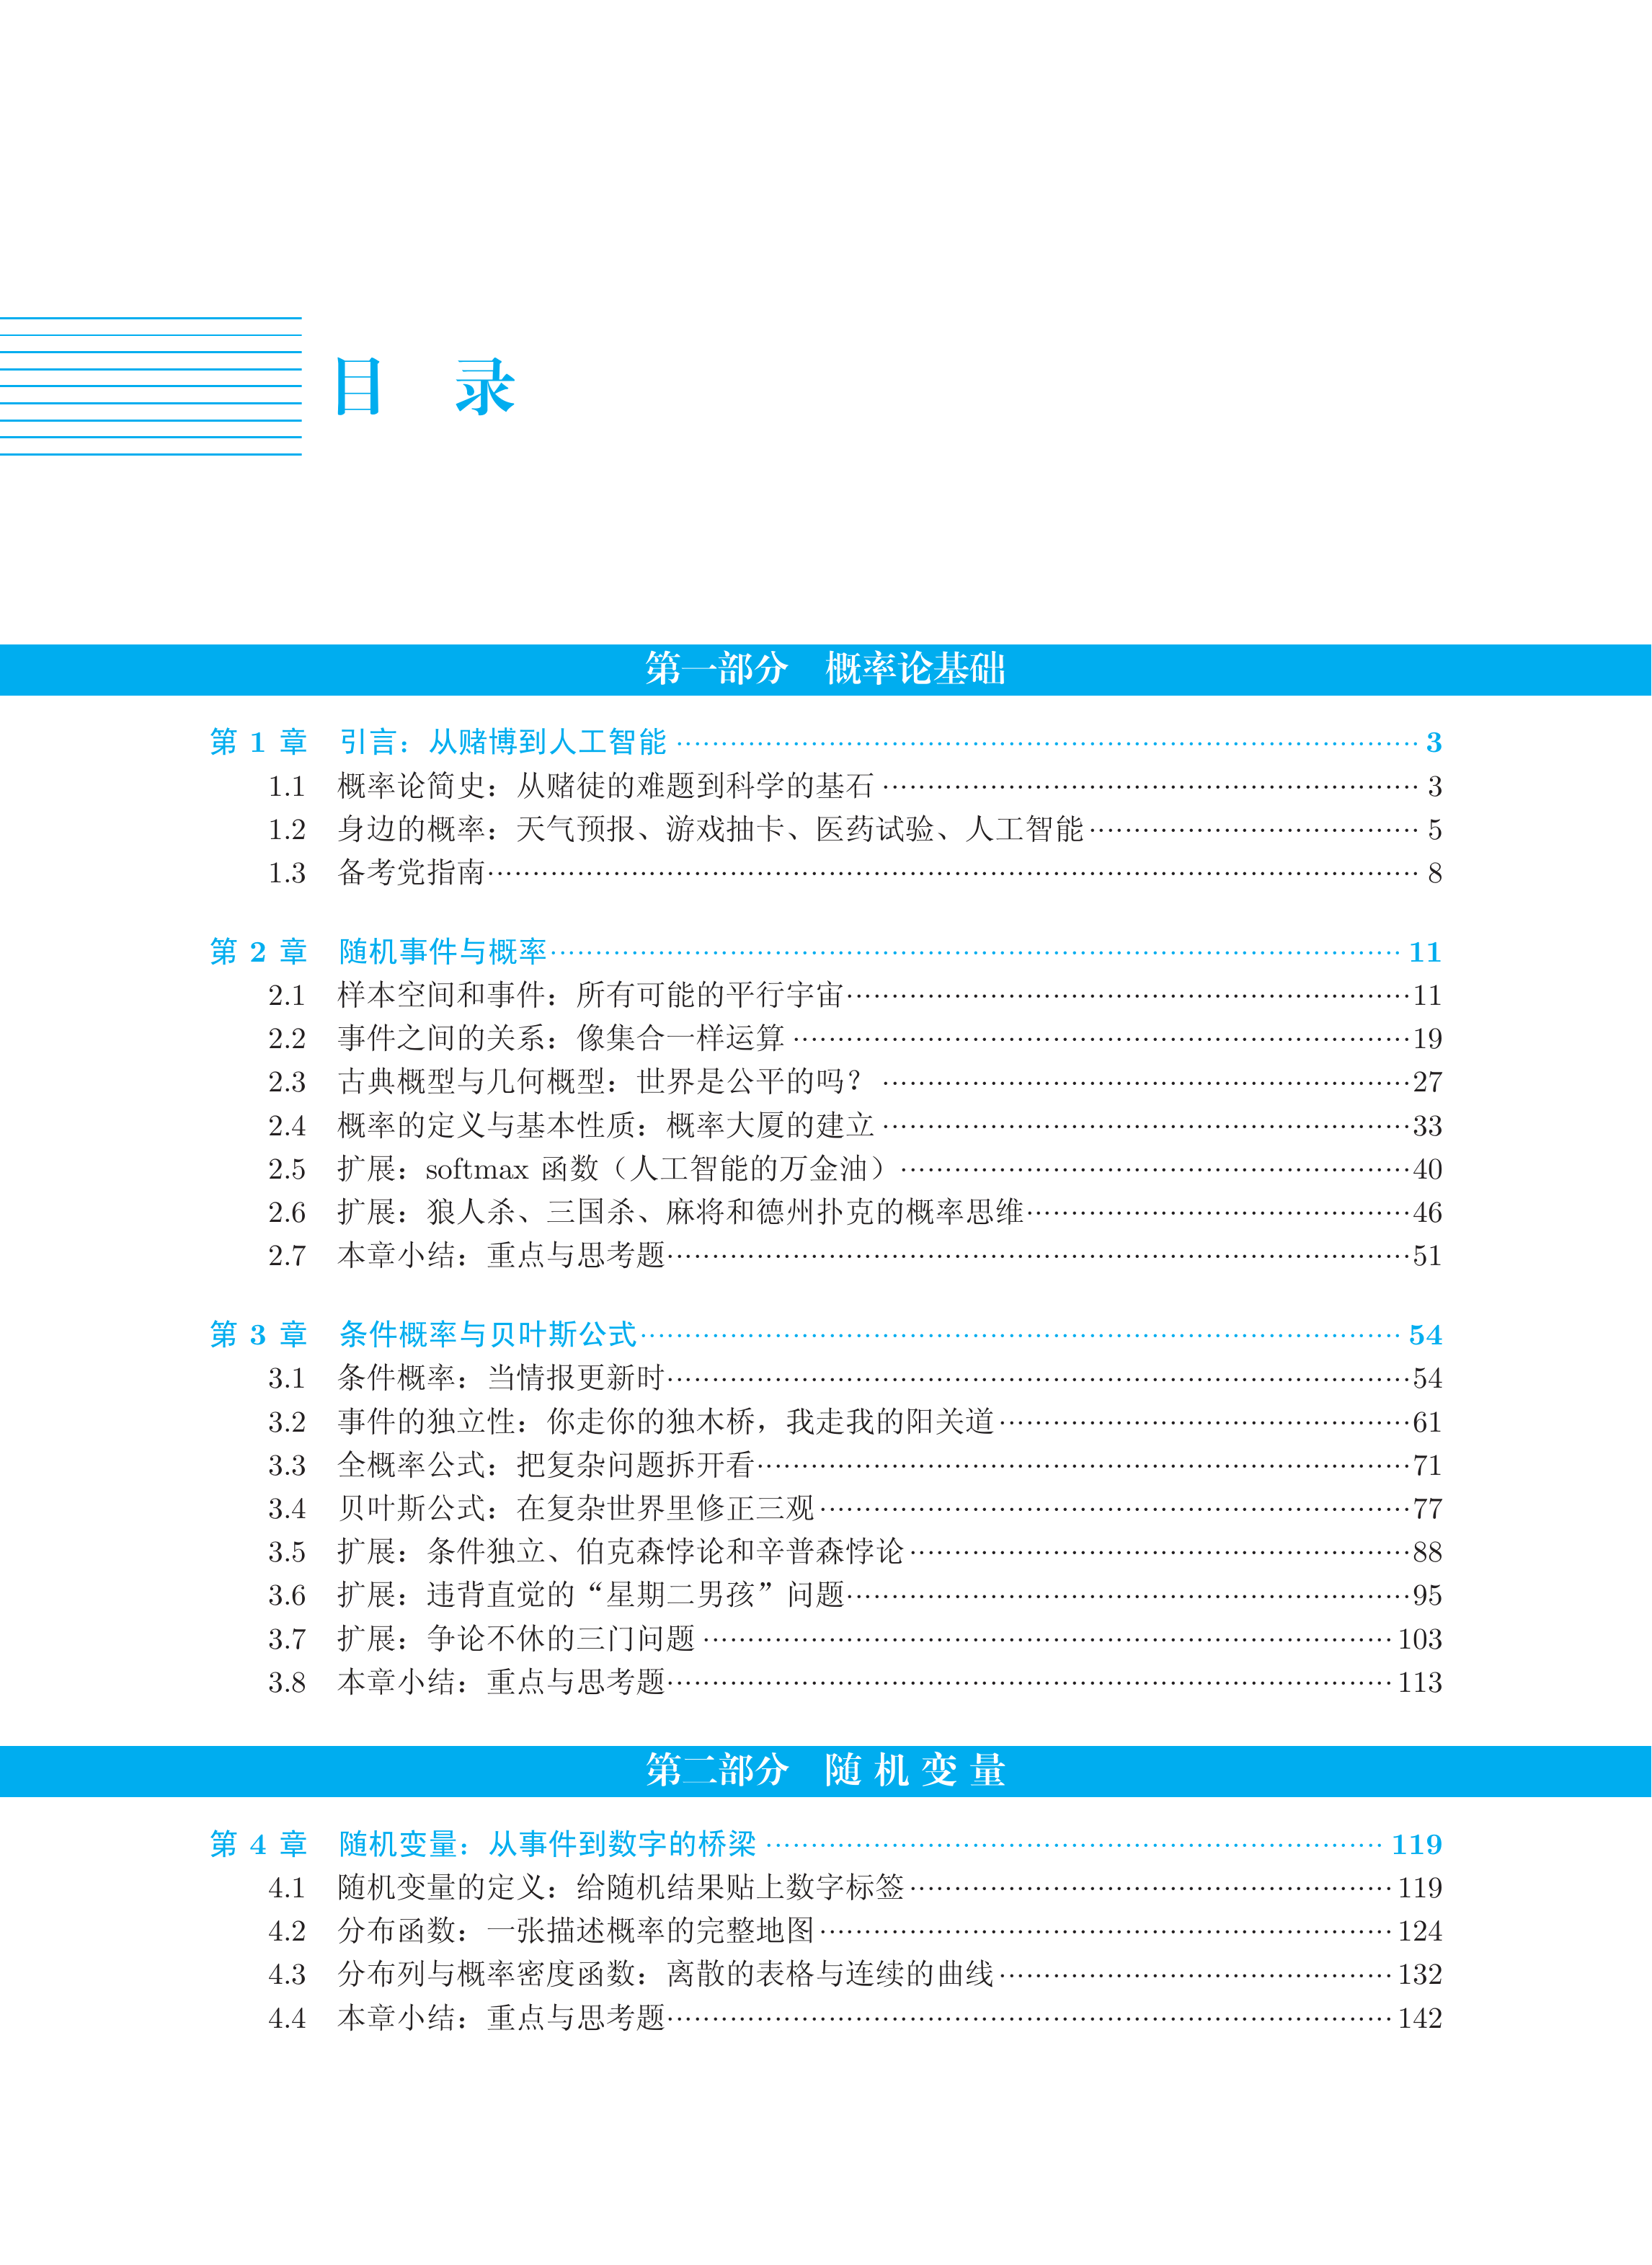
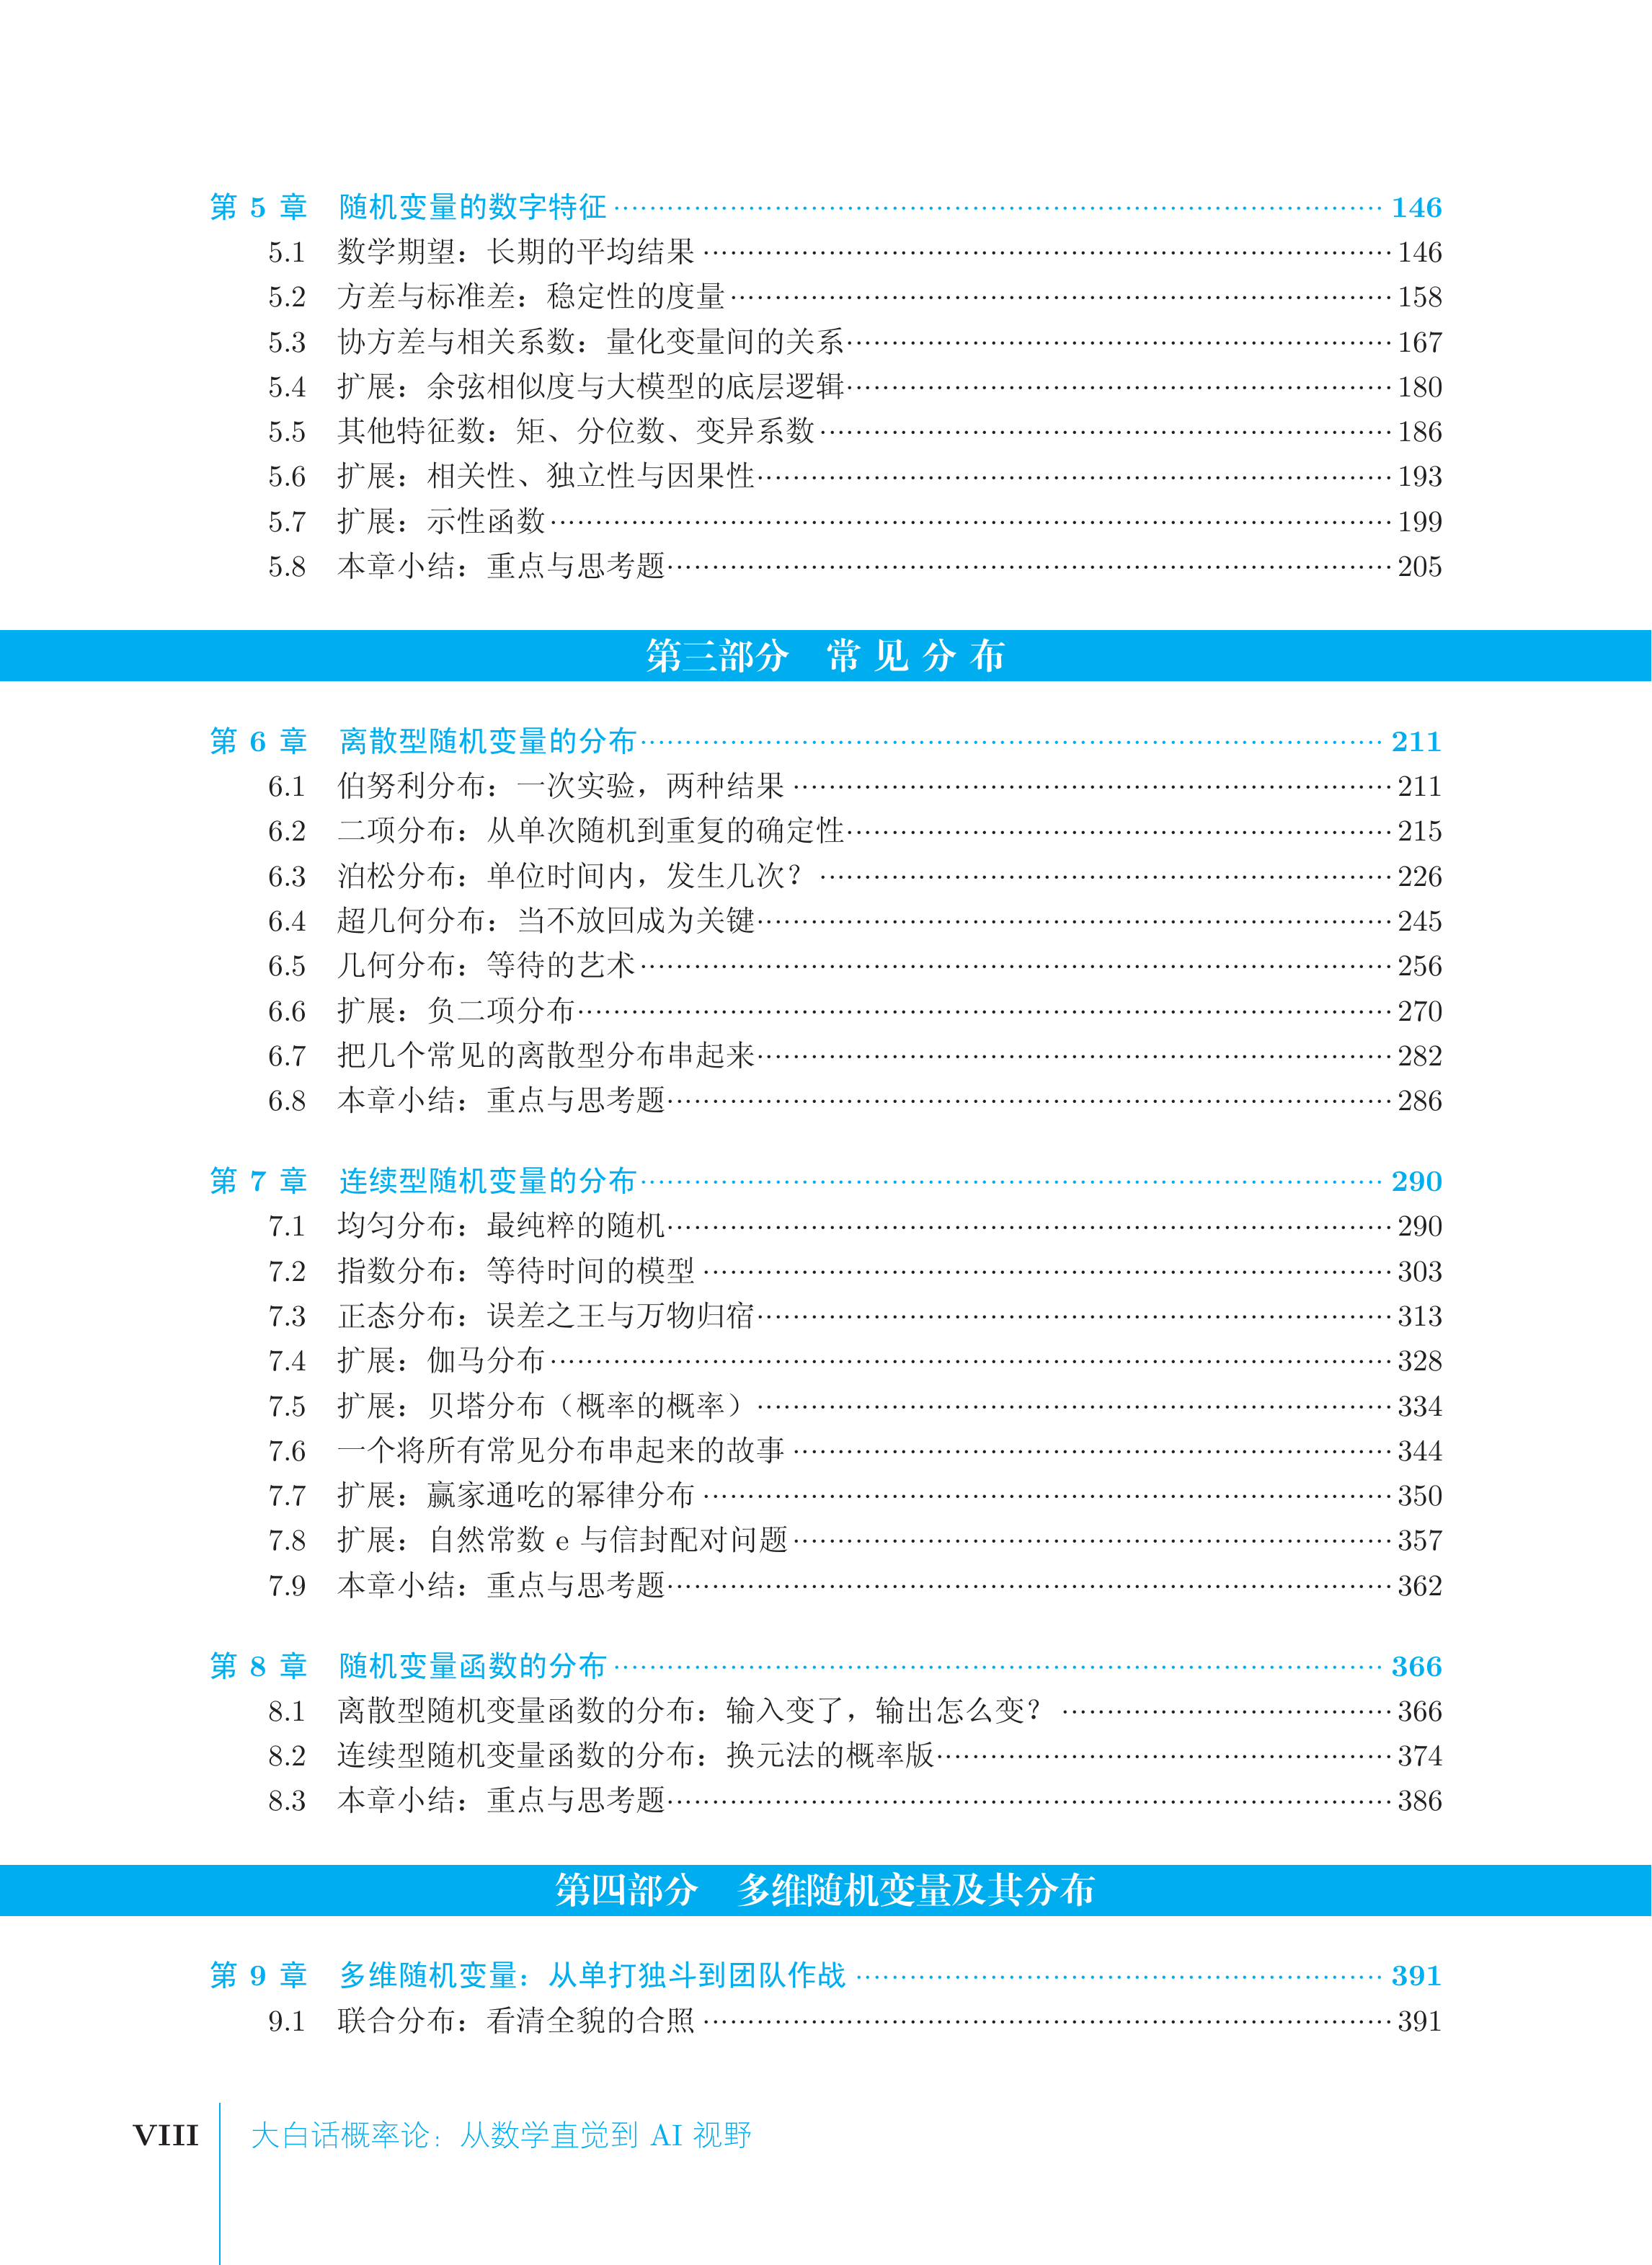
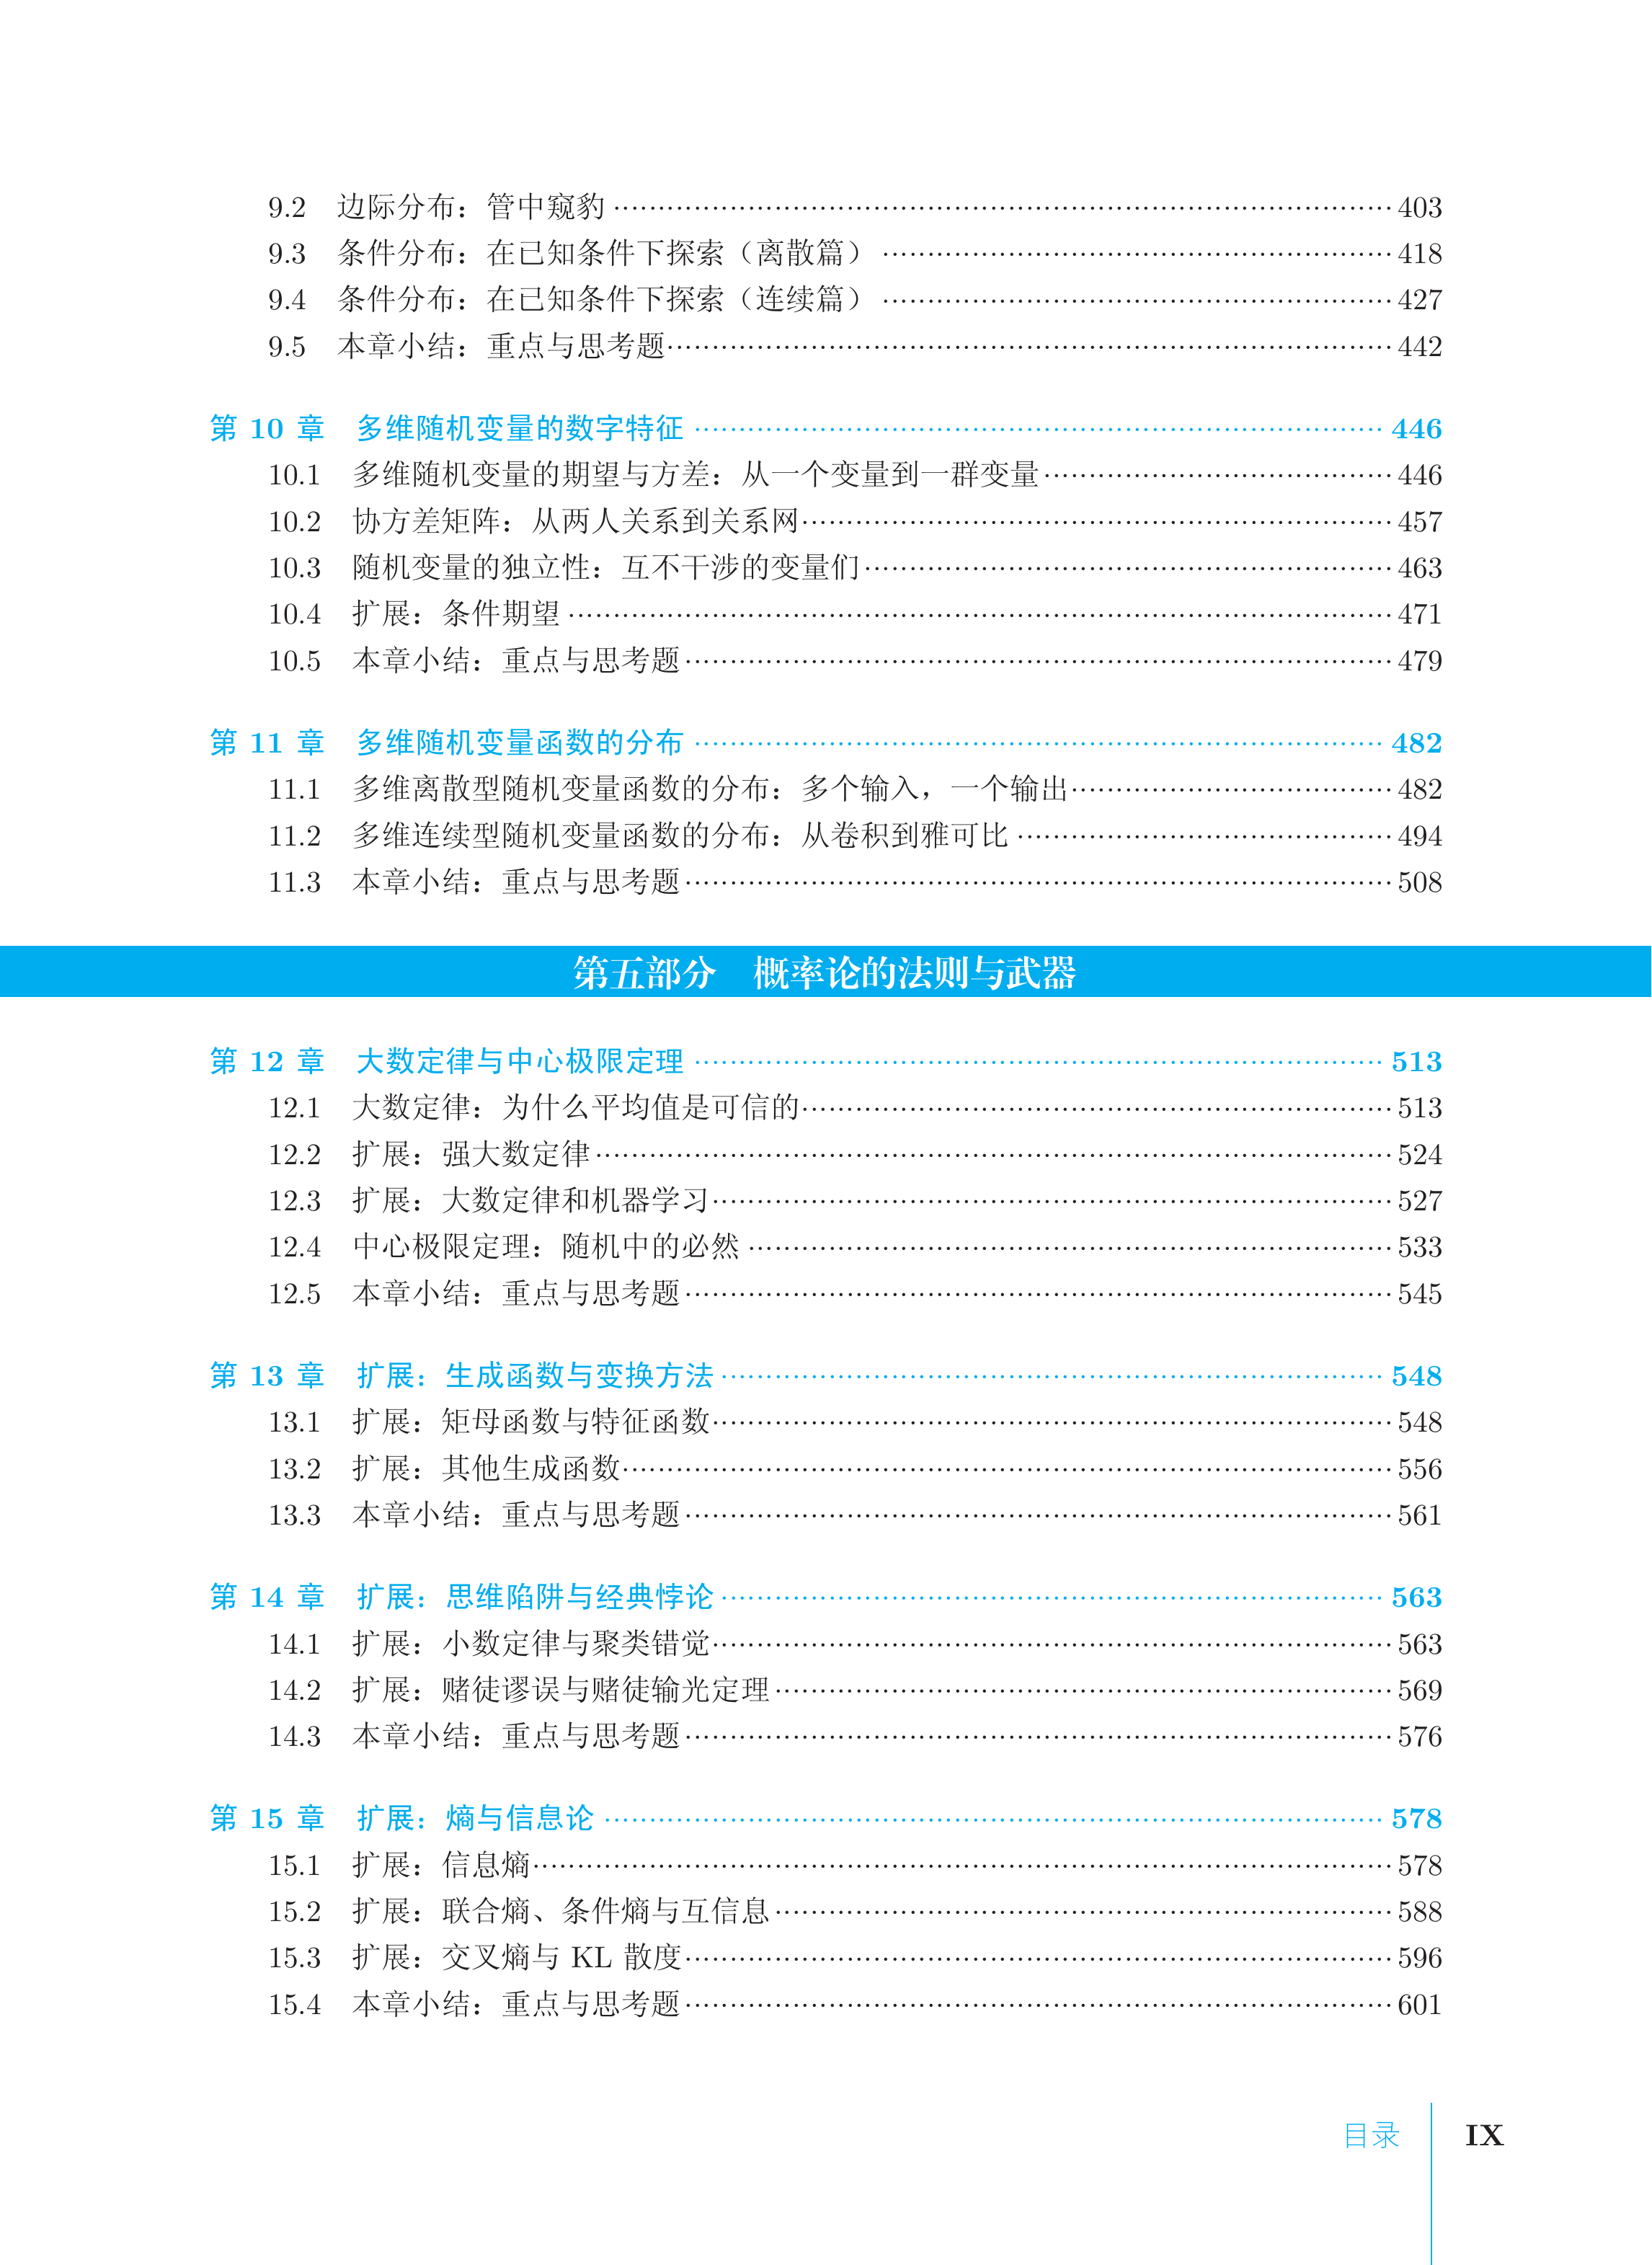
附这本书的目录: