武辰作品索引

知乎作品库

回答 · 7

知乎原文

如何通俗易懂地讲解什么是 PCA(主成分分析)?

PCA是一种基本的数据降维技术。在知乎或者百度搜索PCA,会找到很多关于PCA的介绍。

以最简单的模型为例:如何把二维数据压缩至一维。

数据压缩的目标是:让新数据的方差尽可能地大。这个标准能使得新数据尽可能地不丢失原有数据的信息,因为方差越大,数据间的差异越大。

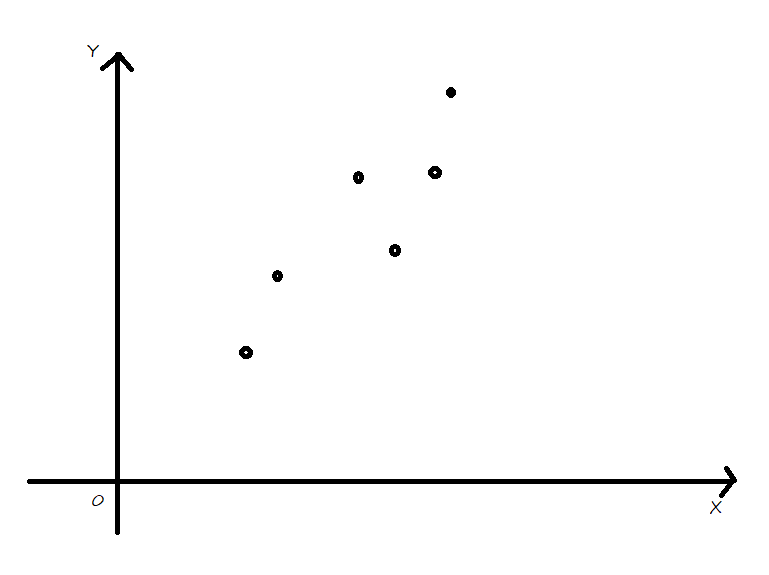
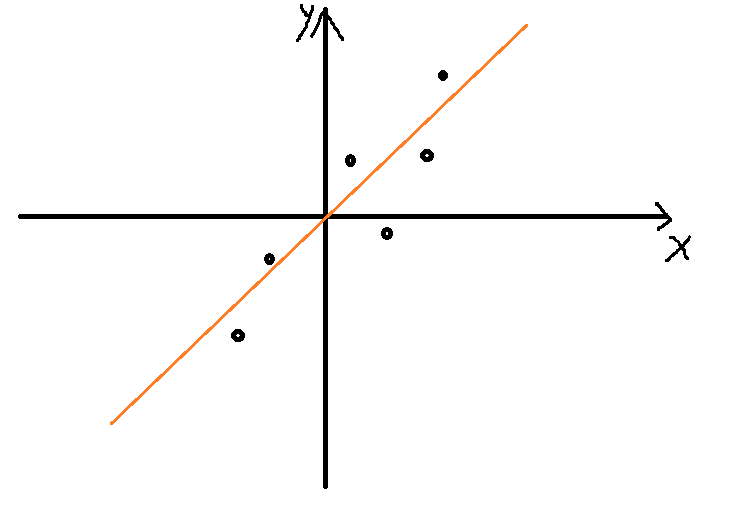
如下图所示:有六个点,每个点有两个特征,分别对应x轴和y轴。需要把他们压缩成一维的数据,即每个点只有一个特征。

因此要寻一条直线,让所有点投影到该直线上。该直线上的刻度即为新数据的值。
原文配图

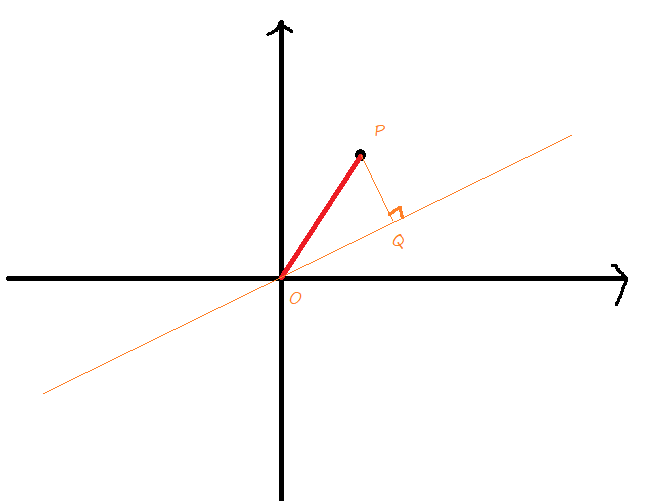
首先进行中心化处理。中心化的好处在于,我们寻求的直线必定经过原点。如下图所示,只需从所有经过原点的直线中,找一条直线,使得各个数据的方差最大。
原文配图

如下图所示,设P是样本的一个数据。注意到这样一个性质:由于OP的距离是定的,因此过原点作任何一条直线,记Q是P在该直线上的投影点,都有 OQ2+PQ2OQ^{2}+PQ^{2} =定值。

原文配图


显然知道 OQOQ (带正负号的长度)是数据 P(xp,yp)P(x_{p},y_{p}) 压缩后的值。

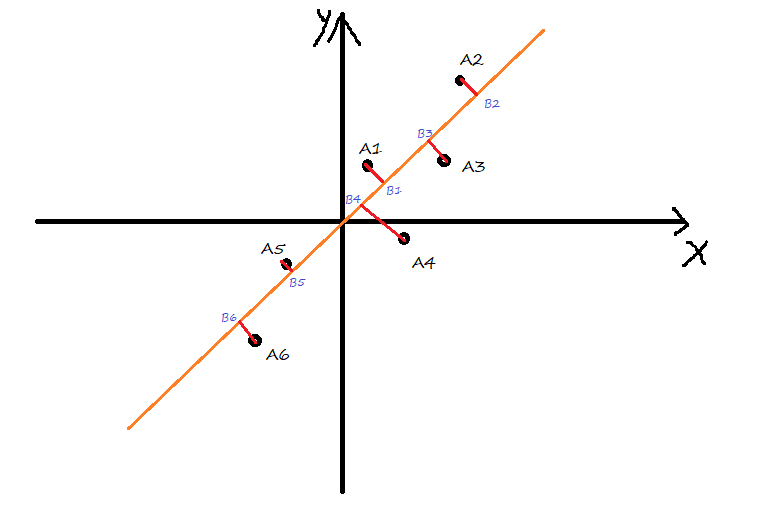
那么如下图所示:对于 A1A_{1} 到 A6A_{6} 六个点,分别作直线的垂线,交直线于 B1B_{1} 到 B6B_{6} 六个点。直线可以看做数轴,坐标系的原点就是数轴的原点。记 B1B_{1} 到 B6B_{6} 六个点的刻度分别为 b1,…,b6b_{1},…,b_{6} 。那么 b1,…,b6b_{1},…,b_{6} 就是降维后的数据。

原文配图

由于数据已经做了中心化处理,所以 b1+b2+…+b6=0b_{1}+b_{2}+…+b_{6}=0 。一般性的具体证明如下:

设第 ii 个点的坐标是 (xi,yi)(x_i,y_i),这条直线的单位方向向量是 u=(ux,uy)u=(u_x,u_y)。比如直线的斜率为 kk 时,可以取 u=(1,k)1+k2u=\frac{(1,k)}{\sqrt{1+k^2}}。

投影后的坐标,就是这个点的坐标和单位方向向量的点积:

bi=(xi,yi)⋅u=uxxi+uyyib_i=(x_i,y_i)\cdot u=u_xx_i+u_yy_i

把六个投影坐标加起来:

∑i=16bi=ux∑i=16xi+uy∑i=16yi=0\sum_{i=1}^{6}b_i=u_x\sum_{i=1}^{6}x_i+u_y\sum_{i=1}^{6}y_i=0

最后一步是因为中心化时,横坐标和纵坐标各自减去了自己的平均值,所以这两组坐标各自加起来都是 0。

也就说明 bb 的均值为0。那么 bb 的方差为: b12+b22+b32+b42+b52+b62n\frac{b_{1}^{2}+b_{2}^{2}+b_{3}^{2}+b_{4}^{2}+b_{5}^{2}+b_{6}^{2}}{n} .

回想我们的目标是让压缩后的数据方差最大,即让 ∑i=16bi2\sum_{i=1}^{6}{b_{i}^{2}} 最大。

记点 AiA_{i} 到直线的距离为 did_{i} ,那么有 di2d_{i}^{2} + bi2b_{i}^{2} =定值。

于是 ∑i=16bi2+∑i=16di2\sum_{i=1}^{6}{b_{i}^{2}}+\sum_{i=1}^{6}{d_{i}^{2}} =定值。

使 ∑i=16bi2\sum_{i=1}^{6}{b_{i}^{2}} 最大,那么等价于 ∑i=16di2\sum_{i=1}^{6}{d_{i}^{2}} 最小。

到这里,问题就差不多解决了。那电脑怎么找到这条线?先算中心化数据的协方差矩阵,再找最大特征值对应的特征向量。这个向量指的,就是刚才那条直线的方向。

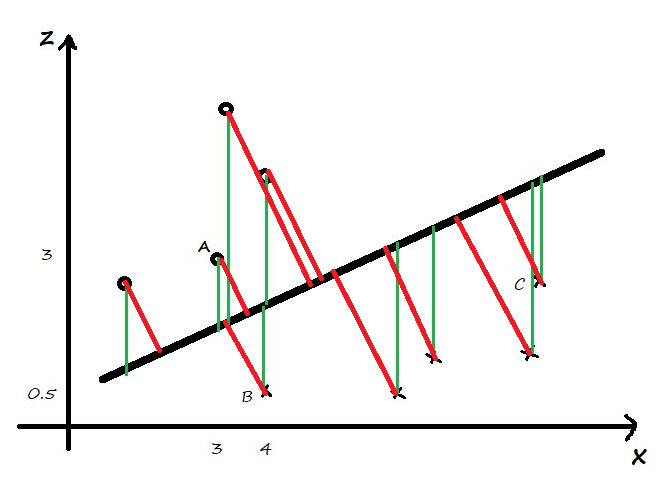
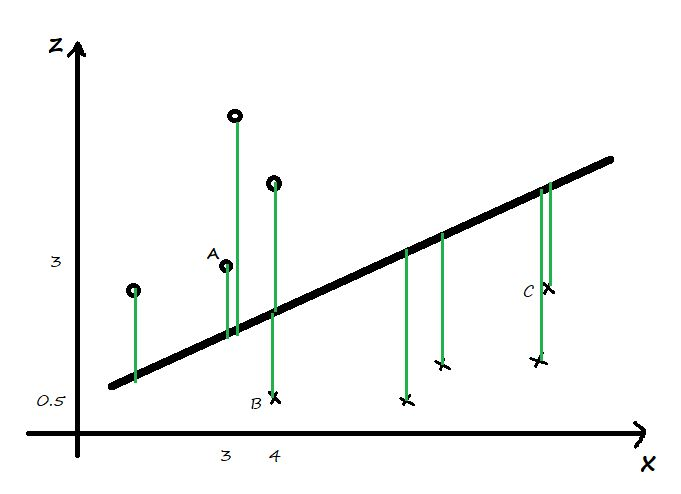
这个结果很美妙,在这里和一元线性回归作比较。如下图所示,一共有九个点。我们要进行一元线性回归,所采取的策略是让平方损失最小,通俗地来说,就是让九条绿线的平方和最小。
原文配图

如果是采用PCA,如下图所示,我们采取的策略是让九条红线的平方和最小。

原文配图

做一元回归,是拿 X 猜 Y。X 定下来以后,我们只看猜出来的 Y 和真实的 Y 差多少,所以量的是图里的绿线。PCA 是把整个点投到线上,量的是图里的红线,也就是点到直线的垂直距离。

类似地,对于n维数据,投影到更小的k维空间也能同样地进行类比。


这篇是从几何上讲 PCA 的:我们是怎么找到那条线的?我在《大白话概率论:从数学直觉到 AI 视野》里,还从协方差矩阵的角度讲了这个问题,也讲了实际计算 PCA 时为什么会用到奇异值分解(SVD)。如果你想接着往下看,可以翻翻书里协方差矩阵那一节。

知乎原文

久赌必输能从数学模型上解释么?

“久赌必输”很多人都听过。“久赌必输”有两种解释:第一种解释是“只要赌得够多,那么不可能一直赢,迟早会输”;第二种解释是“只要赌得足够多,那么迟早会输光”,这种解释也叫做“赌徒输光定理”。第二种解释比第一种解释更强。这里用一个模型看看,第二种解释在什么情况下成立。

假设你一共的赌资有 aa 元,这个 aa 可以包含你所有的财产和你能借到的所有财产。接下来,我们算算一直赌下去,你有多大可能输光这笔赌资。

首先简化赌博模型:假设一次赌博是抛一次均匀的硬币,若正面,则你赢1元;若反面,则你输1元。这里先把规则定得公平一点:每局赢和输的机会各一半,上一局的输赢也不影响下一局。

另一个假定是:对手拿出来赌的钱,比你多得多。比如说,你常年和朝阳社区的张三、李四、王阿姨打麻将,他们的资产可能和你差不多。几个月后,这三个人都输得破产了,但是你仍然要继续赌博。由于这三个人破产了,你只能去另一个小区找新的伯伯奶奶们赌博。在这个模型里,我们就把这些对手的赌资合在一起看。

接下来,把他们看成一个对手。你们各带一笔钱,赌的过程中谁也不再加钱,哪一方先输光,赌局就结束。


记 pxp_{x} 为:你一开始的资产为 xx 元并迟早破产的概率。我们要算的就是,你从自己的这笔赌资出发,先于对手输光的概率。

记与你赌博的玩家们的赌资为 hh .要注意这个 hh 远远比 aa 大。

设你一开始的资产为 xx 元。当你进行第一次赌博后,你的资产有 12\frac{1}{2} 的概率变成 x+1x+1 ,有 12\frac{1}{2} 的概率变成 x−1x-1 。

由定义,你的资产为 x+1x+1 时,你破产的概率为 px+1p_{x+1} ;你的资产为 x−1x-1 时,你破产的概率为 px−1p_{x-1} 。

于是可以得到这样一个递推式:

px=12px+1+12px−1p_{x}=\frac{1}{2}p_{x+1}+\frac{1}{2}p_{x-1}

这个递推式是解决这个问题的核心。

可以对递推式作这样的变换:

12(px+1−px)=12(px−px−1)\frac{1}{2}(p_{x+1}-p_{x})=\frac{1}{2}(p_{x}-p_{x-1})

即 px+1−px=px−px−1p_{x+1}-p_{x}=p_{x}-p_{x-1}

如果令 qx=px+1−pxq_{x}=p_{x+1}-p_{x} ,不难发现{ qx{q_{x}} }是一个最简单的等差数列。

所以对于任意的 xx ,有 px−px−1=dp_{x}-p_{x-1}=d .

试图求 pap_{a} .由递推式,得到:

pa−pa−1=dp_{a}-p_{a-1}=d

pa−1−pa−2=dp_{a-1}-p_{a-2}=d

…………

p1−p0=dp_{1}-p_{0}=d

以上 aa 个式子相加,得:

pa−p0=adp_{a}-p_{0}=ad

这里的 p0p_{0} 为:你一开始有0元时,你破产的概率。这是一个极端情况,显然为1.

所以 pa=1+adp_{a}=1+ad (*)

接下来求 dd .


由定义,ph+ap_{h+a} 为你一开始有 a+ha+h 赌资时,你破产的概率。这显然为0。因为这时对手这笔钱已经输光,赌局结束了。

继续,有如下递推:

pa+h−pa+h−1=dp_{a+h}-p_{a+h-1}=d

pa+h−1−pa+h−2=dp_{a+h-1}-p_{a+h-2}=d

…………

p1−p0=dp_{1}-p_{0}=d

以上 a+ha+h 个式子相加,得:

pa+h−p0=(a+h)dp_{a+h}-p_{0}=(a+h)d

又因为 ph+a=0p_{h+a}=0 , p0=1p_{0}=1 ,

所以 d=−1a+hd=-\frac{1}{a+h}

代入(*)式,得 pa=1+a−1a+h=ha+hp_{a}=1+a\frac{-1}{a+h}=\frac{h}{a+h}

也就是说,你迟早要破产的概率是 ha+h\frac{h}{a+h}。换句话说,你输光的概率,就是对手的本金占总本金的比例。比如你有10元,朋友有90元,哪怕每局都公平,你输光的概率也有90%。

由于 hh 远远比 aa 大,所以这个概率几乎为1.

比方说,假设你有1个亿的资产,你赌博的玩家的总资产为1万亿。那么

pa=1万亿1亿+1万亿≈0.9999p_{a}=\frac{1万亿}{1亿+1万亿}\approx0.9999

也就是说,在这个例子里,如果一直赌到一方输光,你输光的概率大约是99.99%。

上面算的还是每局都公平的情况。现实里有些赌局还会抽成,有些是赢一次赚得少、输一次赔得多。光看赢的机会有多大,不能判断划不划算。有些人可能会说“自己赌了几年,没有破产,反而赢了一些钱,你这不是扯淡吗?”。赌了几年还赢着,跟这个模型并不矛盾。我们算的是一直赌到一方输光时,你先输光的概率;也有可能是对手先输光。尽管这样,我也不赞同“小赌怡情”。赌博是一个无底洞,小赌很可能会被卷入到“久赌”。

知乎原文

概率(Probability)的本质是什么?

概率论是一门年轻的学科。为现代概率论打下基础的人是前苏联数学家柯尔莫哥洛夫,他在1933年以公理化的方式严格地定义了概率。

要说清楚概率的本质,必然要牵扯到测度论的内容。测度论是严格定义概率的基础。然而测度论对大多数人并不友好。

我这里用不太严谨的角度来解释什么是概率,希望我的解释能够帮助大多数初学者加深对概率的理解。


从数学上看,概率可以理解成一个函数。

说到函数,读者可以回想高一上学期的内容:函数满足三个条件:定义域、函数关系、值域。

首先,这个函数的取值都在[0,1]里。这就是概率的取值范围。概率不能大于1,也不能小于0。

定义域是事件域。事件域这个概念比较难理解,我待会会有详细举例。先看“样本空间”。什么是样本空间?样本空间是一个集合,组成这个集合的元素是样本点。什么是样本点?样本点是一个随机现象的最基本的可能的结果。什么是随机现象?并不总是出现相同结果的现象叫做随机现象。问到这里就不能再往下问了,因为已经没办法追本溯源了。

在一些概率论教材中,抛弃了“随机现象”的概念,指出“随机试验”的概念:①试验可在相同条件下重复进行;②每次试验只有一个结果出现且结果事前不能预知;③每次试验所有可能出现的结果已知。

随机试验所有可能出现的结果所组成的集合称为试验的样本空间。

事件域就是样本空间的某些子集组成的全部集合。

上面的文有些枯燥,我举一个例子:

同时抛两枚硬币,观察正面还是反面向上(这是一个随机现象)。

这个随机现象产生了四个最基本的结果:(正,反)、(反、正)、(反、反)、(正、正)。分别对应于(一正一反向上)、(一反一正向上)、(两个反面向上)、(两个正面向上)。

这四个最基本的结果就是四个样本点。

我们为了简化描述,把正面记为1,把反面记为0。因此这四个样本点就是(1,0)、(0,1)、(1,1)、(0,0)。

样本空间就是样本点的集合:{ (1,0),(0,1),(1,1),(0,0) }

接下来最难理解的是事件域:事件域就是样本空间的某些子集组成的集合类。

比如,事件“两个硬币的结果都是正面向上”,对应的事件是{ (1,1) };事件“至少有一个硬币的结果是正面向上”则对应于{ (1,1),(1,0),(0,1) }。

我们可以把所有的事件写出来,以下就是事件域(事件域是一个集合,这个集合的元素也是集合,所以你会看到最后面有两层集合号):

{ ∅,

{(0,0)},

{(0,1)},

{(1,0)},

{(1,1)},

{(0,0),(0,1)},

{(0,0),(1,0)},

{(0,0),(1,1)},

{(0,1),(1,0)},

{(0,1),(1,1)},

{(1,0),(1,1)},

{(0,0),(0,1),(1,0)},

{(0,0),(0,1),(1,1)},

{(0,0),(1,1),(1,0)},

{(1,1),(0,1),(1,0)},

{(0,0),(0,1),(1,0),(1,1)} }

这个事件域有16个元素。16是怎么来的呢?回想事件域的定义:样本空间的某些子集的集合类。而样本空间有4个元素,一共有 C40+C41+C42+C43+C44=24=16C_{4}^{0}+C_{4}^{1}+C_{4}^{2}+C_{4}^{3}+C_{4}^{4}=2^{4}=16 种取法,因此事件域的元素有16个。

上面我们把 16 个事件都列出来了。接下来还差一步:怎么给事件分配概率?还是拿这两枚硬币来说。如果两枚硬币都是公平的,而且互不影响,这四个结果出现的机会就一样大。「至少有一个正面」占了其中三个,所以它的概率是 3/4。

这个例子里,我们数一数再相除就行了。但不是每道题都能这么算。不管怎么算,给事件分配概率都得守三条规矩:

公理一(非负性):任何事件的概率都不能是负数。一件事的可能性,总不能是负的吧?

公理二(规范性):必然事件的概率是 1。比如这两枚硬币抛出去,不管结果是什么,刚才列出来的四种结果里总有一种会发生。

公理三(可列可加性):如果有一系列事件,它们两两互斥,也就是不可能同时发生两个,那么它们中至少有一个发生的概率,就等于各自概率的总和。这里的「可列」就是说,哪怕有无限多个,也能把它们一个个数下去。

一个给事件分配数字的规则,满足了这三条,就可以叫作这个事件域上的概率测度。

知乎原文

如何通俗易懂地解答双信封悖论?

令 XX 和 YY 分别表示你和对方的数值, mm 表示两封信中数量更小的数值。打开信封看到 x 元以后,容易误以为下面两种情况各占一半: P(Y=2x|X=x)=P(Y=x/2|X=x)=12P(Y=2x|X=x)=P(Y=x/2|X=x)=\frac{1}{2} 。我们先不看金额,只算眼前这一对信封。对这一对来说, P(Y=2m|X=m)=1P(Y=2m|X=m)=1 ,且 P(Y=m|X=2m)=1P(Y=m|X=2m)=1 。

接下来自然是比较你开始的数值的数学期望与交换后你获得的数值的数学期望。

开始的数值的数学期望比较好计算: E(X)=12(2m)+12m=32mE(X)=\frac{1}{2}(2m)+\frac{1}{2}m=\frac{3}{2}m

交换后你获得的数值的数学期望:

P(X=m)[2mP(Y=2m|X=m)+mP(Y=m|X=m)]P(X=m)[2mP(Y=2m|X=m)+mP(Y=m|X=m)]

+P(X=2m)[mP(Y=m|X=2m)+2mP(Y=2m|X=2m)]+P(X=2m)[mP(Y=m|X=2m)+2mP(Y=2m|X=2m)]

上面的式子用到了两次重期望公式,也叫作期望的全概率公式。

由于有 P(X=m)=P(X=2m)=12P(X=m)=P(X=2m)=\frac{1}{2},

P(Y=2m|X=m)=1P(Y=2m|X=m)=1 , P(Y=m|X=2m)=1P(Y=m|X=2m)=1 ,

P(Y=m|X=m)=P(Y=2m|X=2m)=0P(Y=m|X=m)=P(Y=2m|X=2m)=0

代入得交换后获得数值的数学期望为 32m\frac{3}{2}m 。

数学期望是没有变化的。也就是说,没看金额就决定换不换,平均拿到的钱是一样的。可如果你已经打开信封,看到了 100 元,另一封可能是 50 元,也可能是 200 元。这两种情况各占多大概率,要看题目是怎么放钱的,不能把刚才那个「各一半」直接搬过来。

进一步地,可以计算出最优策略。详见:

武辰:双信悖论的解释与最优策略

知乎原文

大一新生想要理解 1+2+3+…=-1/12 要先学习什么?

那个式子是错的。很多答主已经做出了非常详细的解释。

这里给一个类似容易踩坑的数学结论。

令 S=1+x+x2+x3+x4+…S =1+x+x^{2}+x^{3}+x^{4}+…

那么 xS=x+x2+x3+x4+x5+…xS =x+x^{2}+x^{3}+x^{4}+x^{5}+…

两式相减: (1−x)S=1(1-x)S=1

所以: S=11−xS=\frac{1}{1-x}

即: 1+x+x2+x3+x4+…=11−x1+x+x^{2}+x^{3}+x^{4}+…=\frac{1}{1-x}

取 x=2x=2

则 1+2+22+23+24+…=11−2=−11+2+2^{2}+2^{3}+2^{4}+…=\frac{1}{1-2}=-1

这显然是错误的式子。

问题出在哪呢?x=2x=2 处并不在收敛域内。

知乎原文

有哪些让人拍案叫绝的智障设计?

微信群群主解散群时,我这边显示“您已被群主移出群聊”。

虽然我可以通过群聊人数或者其他线索知道这只是群主解散了群,但是有些人未必知道。他们可能会心想:“我是不是哪里得罪他了?他怎么把我踢出来了?”这样一来可能会造成很大的误会。

知乎原文

有哪些看似精妙实则很蠢的设计?

很多手机端或电脑端的主流输入法都有“删后调序”功能:

比如我想输入“哪里”,我用拼音输入“nali”,然后待选框出来的第一个是“那里”,第二个是“哪里”。

我不小心点了第一个,于是我删掉它,重新输入“nali”。由于我记得“哪里”在第二个,所以我接下来下意识地点了第二个,结果还是输出的“那里”。

原来输入法自作聪明,它能捕获到你删除词语这个行为,凭此判定你刚刚输入的词语不是你想要的,于是它自动把词意相近的词语替换到第一个。就拿刚刚的例子来说:输入“nali”,第一次的顺序是“那里”、“哪里”,你选了“那里”然后删掉重新输入后,第二次的顺序自动调成了“哪里”、“那里”。

这种自动调整自以为聪明,实际上非常傻,不仅没必要,反而甚至让用户重输第三次、第四次…给很多用户造成极其不好的体验(评论区1000多活生生的例子)。


-------第一次更新-------

评论区还有不少人把我说的情况等同于“基于选字频率高低而进行动态排序的词频记忆”功能。这个自作聪明的设计不是“词频记忆”,它和“词频记忆”功能本质上是不同的。

“词频记忆”指的是,比如:我的名字是“武辰”,输入法没有“武辰”词条,我输入“wuchen”,手动选择了“武辰”,那么输入法会自动记忆“武辰”,下次我输入“wuchen”的时候就会出现“武辰”。另外,如果我输入“武辰”的频率大于“无尘”,那么候选列表显示的顺序一般会按照以上频率排列,下次我就不用翻好几页找想要的词了。

这个功能是好的,也是几乎所有人都需要的功能,但它和我正文提到的那个自作聪明的“删后调序”功能根本不是一回事。


-------第二次更新-------

为什么评论区还是有那么多人把“删后调序”等同于“动态词频”或者等同于“记忆词频”呢…

针对评论区部分评论回复:

①这明明是你自己的锅,怪什么输入法?

答:举个例子:你正在田径场跑马拉松,赛道旁的桌子上有两个饮水机,前边的是坏的,后边的是好的。你第一圈先用前边的饮水机,发现是坏的,于是再用后边的。等你喝完继续跑之后,你一个贴心的朋友可能觉得你是白痴,认为你下一轮还会先用前边的饮水机,于是悄悄地把两个饮水机换了位置。

第二轮,你吸取教训,直接跑过去用后边的饮水机。结果发现后边的是坏的,你又得用前边的。

更要命的是,你不知道这个贴心的朋友何时出现!有时候他会悄悄换顺序,有时候他不换!

我认为,一般人都知道第二圈用后边的饮水机吧?

另外,如果你一定要避免这种情况,那么只有放慢速度,先甄别哪个是坏的饮水机。就好比,你如果一定要打对字,必须在选词前花上一秒仔细看究竟是“那里”还是“哪里”。抱歉,我每天要打大量的字,不是和乌龟在对话,“删后调序”这个功能和正常人的本能、思维、反应速度、逻辑是冲突的!


②要是没这个功能,你每次打名字都得自己手动选 / 要是没这个功能,你每次常打的词语都在后面甚至要翻好几页。

答:“删后调序”功能不等于“词频记忆”功能!如果是“词频记忆”,你第一次按下空格选下的词,词频更多了,那么下次更应该巩固在第一位。但是为何第二次选的时候反而掉进了第二位?


-------第三次更新-------

有哪些让人拍案叫绝的智障设计?

我昨天逛知乎的时候无意发现已经有前辈写出来这个智障功能了。


-------第四次更新-------

知乎应该是一个高品质的问答社区。可为什么评论区还有“这个功能就是捕捉我常用的词语然后放前面”、“把词频高的词语放前面不好吗?”这种回复呢?

希望大家把回答看完再发表高见。

知乎原文

非常神奇的数学结论有哪些?

一个正整数可以拆分成若干个正整数之和,如何拆,使得这些正整数之积最大?

首先显然,拆开的数不能出现1。

其次,当一个数 k≥4k≥4 ,我们可以把 kk 分解为 22 和 k−2k-2 ,注意到 2(k−2)≥k2(k-2)≥k ,因此,大于3的整数就不用考虑了。因为只要出现大于3的整数 kk ,可以把 kk 拆成 2+(k−2)2+(k-2) 。

也就是说,需要让拆分的数尽可能出现2和3。

进一步地,首先保证尽可能多的3,其次再保证剩下的是2。

因为 2*2*2<3*32*2*2<3*3 。

更神奇的是,如果把整数换成正实数,这个问题还会和自然常数e扯上关系。

假设原来的数是S,我们准备把它拆成n份。根据均值不等式,既然已经确定了份数,那么均分的时候,乘积最大。所以,我们只需要比较:

P(n)=(Sn)nP(n)=\left(\frac{S}{n}\right)^n

问题就变成了:n取多少,这个乘积最大?

直接求导有点麻烦,我们先取个对数。对数越大,原来的乘积也越大,所以找最大值的结果不会变:

ln⁡P(n)=nln⁡S−nln⁡n\ln P(n)=n\ln S-n\ln n

为了找到最大值在哪里,我们先暂时把n当成可以连续变化的正数,然后求导:

ddnln⁡P(n)=ln⁡Sn−1\frac{\mathrm d}{\mathrm dn}\ln P(n)=\ln\frac{S}{n}-1

当n小于S/e的时候,导数是正的,增加份数,乘积会变大。而当n大于S/e的时候,导数变成负的,再增加份数,乘积反而会变小。

所以,这个函数的最高点就在n=S/e。这个时候,每一份刚好等于e。e就是这么出现的。

不过,真正拆分的时候,份数只能是整数。所以我们还要把S/e左右两边能取到的整数份数分别算一下,看看哪种分法的乘积更大。

比如6.6/e≈2.43,那就比较分成两份和三份:两个3.3的乘积是10.89,三个2.2的乘积是10.648,所以分成两份更好。

如果S/e小于1,就取1份,也就是不拆。

知乎原文

有哪些看起来很简单但做起来很难的数学题?

1.商场每天平均来1000名顾客,平均每个顾客购物50元。假定不论客流多少,不影响每位顾客平均50元的消费水平,证明:商场平均每天的购物额为50000元。

这道题有意思的地方在于,每个人花多少钱是随机的,一天会来多少人也是随机的。

我们先看当天来了多少人。如果来了800人,那么当天购物额的平均值就是800×50=40000元;如果来了1200人,那么当天购物额的平均值就是1200×50=60000元。也就是说,当天来了多少人,平均购物额就是这个人数的50倍。

接下来,再把客流不同的这些情况合起来取平均。每一种情况下,平均购物额都是人数的50倍,所以最后也是平均人数的50倍,也就是1000×50=50000元。

这个问题就叫“随机个随机变量求和”的问题。


2.n个正实数的和是常数,在什么情况下它们的积最大?


提供另一个好玩的思路:因为 (a+b2)2(\frac{a+b}{2})^{2} 总是大于等于 abab 。也就是说,对于两个正数 a,ba,b ,我取算术平均值 (a+b2,a+b2)(\frac{a+b}{2},\frac{a+b}{2}) 来分别替换 a,ba,b ,新的两个数的和不变,但是积不会变小,而且两个数不相等的时候,积会变大。如此,我对这 nn 个数的每两个数都用算术平均值来替代,经过很多次以后,这 nn 个数字都足够接近了。也就是说,当 nn 个数相等时,它们的积最大。


3.一个正整数可以拆分成若干个正整数之和,如何拆,使得这些正整数之积最大?

是不是和上一题有点类似?不过,上一题有几个数是固定的,这一题连拆成几个数都可以自己选。

我们先看4及以上的数。结论是:尽量拆成3。如果最后剩下1,就把一个3拿出来,和这个1合在一起,改成2+2;如果最后剩下2,就直接留下这个2。

为什么呢?我们一步一步看。

首先,不要拆出1,因为乘1等于没乘。如果拆出了1,把它加到别的数上,积就会变大。

其次,5及以上的数都可以继续拆,而且积会变大。比如5拆成3+2,积就从5变成了6。一般地,一个数k≥5,拆成3+(k−3),积就变成3(k−3),比原来的k大。

所以最后只需要考虑2、3、4。而4可以换成2+2,积不变。这样,我们只需要考虑2和3。

那2和3怎么选呢?三个2加起来是6,两个3加起来也是6,但是2×2×2=8,3×3=9。所以,如果拆出了三个2,就把它们换成两个3,积又会变大。

这样一来,2最多只能留下两个,其他的都拆成3就行了。比如10,拆成3+3+2+2,积是36;如果拆成3+3+3+1,积反而只有27。

至于1、2、3,允许不拆就保留原数。如果要求至少拆成两个正整数,那么2拆成1+1,3拆成1+2,1就没法拆了。


2026年10月30日更新:我的第一本书终于出版了!

这些年,我在知乎写了不少概率论和数学相关的回答。现在,我的第一本书《大白话概率论:从数学直觉到AI视野》终于由清华大学出版社出版了。这半年有不少朋友一直在等,非常感谢大家的耐心和支持~

这是一本适合自学的概率论与数理统计教材,700多页,延续了我写回答时的讲法:用大白话,讲得很详细,把公式背后的道理讲清楚,也把各个知识点之间的联系串起来。

书中还结合了交叉熵、KL散度等AI相关内容,并设有“AI视野”和“Python实验室”。此外,也收录了2024—2026年考研数学一、数学三的部分概率论真题,以及大厂算法岗面试概率题的详细解答。

如果你喜欢这篇回答的讲法,也想系统地学一遍概率论,可以看看这本书。 下方放了购书卡片,感谢大家支持~

知乎原文

证明事件互斥不独立,独立不互斥?

这是一个错误的结论。
反例:考虑不可能事件A,与任意事件B。A与B互斥,且A与B独立。

详见:

武辰:独立和互斥是什么关系?独立和不相关是什么关系?