知乎原文
十个人赛跑第一名和一百人赛跑的第十名,谁厉害?
先说结论:“鸡头”强于“凤尾”。
2019年6月19日12点更新:很多人反映看不懂我的回答。于是我在这里先提炼出一个直观版答案(严谨版的答案在分割线后):
一般情况下,题主的问题可以等价于:
从 区间上随机抽10个样本,其最大值为 ;再从 区间随机抽100个样本,其中排名第10大的样本为 。问在数学期望的意义下, 与 的大小关系。
首先从 区间上随机抽10个点,那么这10个点把数轴分为11条线段。每一条线段的在数学期望的意义下应该是相等的。于是每一条线段的长度的数学期望是 。那么最大值的那个点的数学期望是 。
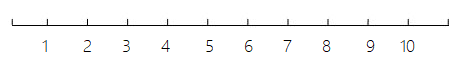
同样的道理,从 区间随机抽100个样本,那么这100个点把数轴分为101条线段。每一条线段的数学期望是 。从大到小排名第10名的那个点,在它的左边已经有90条线段,于是从大到小排名第十名的数学期望是 。
。
因此10个人中的“鸡头”比100个人中前10名的“凤尾”要强。
以下是原答案:
下面用次序统计量和贝塔分布再算一遍。
你不了解这两个概念也没关系,在必要的时候我会给出定义,你可以当现成的结论记。
这里假设两组人都是从同一个总体里独立随机抽出来的,成绩是连续的。我们先不比平均用时,只比这两个人平均能超过总体里多少比例的人。比如一个人比总体里90%的人快,就记成0.9。随机抽一个人,这个数在0到1之间服从均匀分布。于是问题变成:
记 为服从 区间上的均匀分布。从 随机抽10个样本,其最大值为 ;再从 随机抽100个样本,其中排名第10大的样本为 。问在数学期望的意义下, 与 的大小关系。
把样本 从小到大排好,排在第 个的值记作 ,叫第 个次序统计量。比如 就是这组样本的最小值, 就是最大值。
如果样本是独立地从同一个总体抽出来的,设总体的密度函数是 ,分布函数是 ,那么 的密度函数是:
再看贝塔分布。如果 在 内的密度是下面这个式子,在区间外的密度为0,就说它服从贝塔分布,记作 。这里的 和 都大于0。
可以发现两者很相似。我们知道, 的密度函数为1,分布函数为 。
因此,从小到大排第 的样本(记为 )的密度函数为:
这正是贝塔分布的密度函数的形式。
于是
如果 ,算期望时,把密度乘上 再积分:
这个积分就是贝塔函数 ,代进去化简,得到 。
套用公式得,
前期准备工作做好了,一言以蔽之:从 抽 个样本,则从小到大排名第 号的样本的数学期望是 。
注:①特别地,这抽 个样本中,最小值的数学期望是 ,最大值的数学期望是 。这是一个很有用的结论,很多考研题可以通过这个结论秒杀;
②这个结论也可以直观地看出来。数轴上 上随机取 个点,那么这 个点把数轴分为 个部分。每一部分的在数学期望的意义下应该是相等的。于是 这个结论就很自然地得到了。
现在开始算结论。
从 随机抽10个样本,其最大值为 ,其期望为 ;
从 随机抽100个样本,第10大就是从小到大数第91个,也就是 。从0数到这个点,要经过91段,所以它的期望是 。
。
按平均百分位来比,十人组的第一名略强。
如果把这两个人直接拉来比一场呢?把随机分组前的110人放在一起排,只有总榜前10名全是百人组的人,十人组第一才会输。反过来算,十人组第一大约有63%的机会赢。
有小朋友不禁要问了:10人中的第一名,可能相当于100人中的第几名呢?
列方程式:
解得
因此10人中的第一名,在数学期望的意义下,相当于100人中的第9.182名。这和用户“曾加”的回答是一样的。
可能还会有小朋友不禁要把这个问题一般化: 个人中的第一名,与 个人中的第 名,孰大?
容易验证:
甚至再一般化: 个人中的第 名,与 个人中的第 名,孰大?
容易验证:
上面两条不等式在 时成立。如果 ,两组人数和要比的名次都一样,当然是等号。也就是说,按平均百分位来比,「鸡头」比「凤尾」强一点。
最后按照惯例,向读者抛出两个思考题:
1.皮皮欢乐中学的初中部和高中部分别有1000名学生。初中部的学生的百米成绩的分布是 ,高中部的学生的百米成绩的分布是 。
(1)从初中部和高中部分别抽1名学生出来进行赛跑,求初中部学生获胜的概率;
(2)从初中部和高中部分别抽4名学生出来进行赛跑,求初中部学生获得冠军的概率和初中部学生集体垫底的概率(求概率之前,不妨直观猜测下哪个概率更高?)。
2. 坤坤中学的初中部和高中部分别有1000名学生。初中部的学生的篮球水平服从 ,高中部的学生的篮球水平服从 。从高中部随机抽5人,再从初中部随机抽一批人。初中部最强的人比高中部这5人里最弱的人还强,这件事的概率能达到90%吗?为什么?
我在《大白话概率论》的「次序统计量」一节里也讲了前面切线段的办法:在0到1之间随机取3个点,切成4段,所以三个点从小到大的平均位置就是四分之一、二分之一、四分之三。书里讲贝塔分布时,我还解释了为什么这些点排好序以后,每个位置上的点都服从贝塔分布。