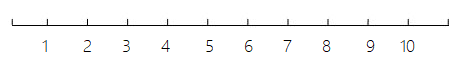武辰作品索引

知乎作品库

回答 · 6

知乎原文

十个人赛跑第一名和一百人赛跑的第十名,谁厉害?

先说结论:“鸡头”强于“凤尾”。
原文配图

2019年6月19日12点更新:很多人反映看不懂我的回答。于是我在这里先提炼出一个直观版答案(严谨版的答案在分割线后):

一般情况下,题主的问题可以等价于:

从(0,1)(0,1) 区间上随机抽10个样本,其最大值为 aa ;再从 (0,1)(0,1) 区间随机抽100个样本,其中排名第10大的样本为 bb 。问在数学期望的意义下, aa 与 bb 的大小关系。

首先从(0,1)(0,1) 区间上随机抽10个点,那么这10个点把数轴分为11条线段。每一条线段的在数学期望的意义下应该是相等的。于是每一条线段的长度的数学期望是 111\frac{1}{11} 。那么最大值的那个点的数学期望是 1011\frac{10}{11} 。

原文配图
一条线段里10个点,把线段分成了11条小线段.

同样的道理,从 (0,1)(0,1) 区间随机抽100个样本,那么这100个点把数轴分为101条线段。每一条线段的数学期望是 1101\frac{1}{101} 。从大到小排名第10名的那个点,在它的左边已经有90条线段,于是从大到小排名第十名的数学期望是 91101\frac{91}{101} 。

1011>91101\frac{10}{11}>\frac{91}{101} 。

因此10个人中的“鸡头”比100个人中前10名的“凤尾”要强。


以下是原答案:

下面用次序统计量和贝塔分布再算一遍。

你不了解这两个概念也没关系,在必要的时候我会给出定义,你可以当现成的结论记。

这里假设两组人都是从同一个总体里独立随机抽出来的,成绩是连续的。我们先不比平均用时,只比这两个人平均能超过总体里多少比例的人。比如一个人比总体里90%的人快,就记成0.9。随机抽一个人,这个数在0到1之间服从均匀分布。于是问题变成:

记 U(0,1)U(0,1) 为服从 (0,1)(0,1) 区间上的均匀分布。从 U(0,1)U(0,1) 随机抽10个样本,其最大值为 aa ;再从 U(0,1)U(0,1) 随机抽100个样本,其中排名第10大的样本为 bb 。问在数学期望的意义下, aa 与 bb 的大小关系。

把样本 x1,x2,…,xnx_1,x_2,\ldots,x_n 从小到大排好,排在第 kk 个的值记作 x(k)x_{(k)},叫第 kk 个次序统计量。比如 x(1)x_{(1)} 就是这组样本的最小值,x(n)x_{(n)} 就是最大值。

如果样本是独立地从同一个总体抽出来的,设总体的密度函数是 p(x)p(x),分布函数是 F(x)F(x),那么 x(k)x_{(k)} 的密度函数是:

pk(x)=n!(k−1)!(n−k)![F(x)]k−1[1−F(x)]n−kp(x)p_k(x)=\frac{n!}{(k-1)!(n-k)!}[F(x)]^{k-1}[1-F(x)]^{n-k}p(x)

再看贝塔分布。如果 XX 在 0<x<10<x<1 内的密度是下面这个式子,在区间外的密度为0,就说它服从贝塔分布,记作 X∼Be(a,b)X\sim\mathrm{Be}(a,b)。这里的 aa 和 bb 都大于0。

p(x)=Γ(a+b)Γ(a)Γ(b)xa−1(1−x)b−1p(x)=\frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}x^{a-1}(1-x)^{b-1}

可以发现两者很相似。我们知道,U(0,1)U(0,1) 的密度函数为1,分布函数为 xx 。

因此,从小到大排第 kk 的样本(记为 x(k)x_{(k)})的密度函数为:

n!(k−1)!(n−k)!xk−1(1−x)n−k\frac{n!}{(k-1)!(n-k)!}x^{k-1}(1-x)^{n-k}

这正是贝塔分布的密度函数的形式。

于是 x(k)∼Be(k,n+1−k)x_{(k)}\sim Be(k,n+1-k)

如果 X∼Be(a,b)X\sim\mathrm{Be}(a,b),算期望时,把密度乘上 xx 再积分:

𝔼[X]=Γ(a+b)Γ(a)Γ(b)∫01xa(1−x)b−1dx\mathbb{E}[X]=\frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}\int_0^1 x^a(1-x)^{b-1}\,\mathrm{d}x

这个积分就是贝塔函数 B(a+1,b)B(a+1,b),代进去化简,得到 𝔼[X]=aa+b\mathbb{E}[X]=\frac{a}{a+b}。

套用公式得, E(x(k))=kn+1E(x_{(k)})=\frac{k}{n+1}


前期准备工作做好了,一言以蔽之:从 U(0,1)U(0,1) 抽 nn 个样本,则从小到大排名第 kk 号的样本的数学期望是 kn+1\frac{k}{n+1} 。

注:①特别地,这抽 nn 个样本中,最小值的数学期望是 1n+1\frac{1}{n+1} ,最大值的数学期望是 nn+1\frac{n}{n+1} 。这是一个很有用的结论,很多考研题可以通过这个结论秒杀;

②这个结论也可以直观地看出来。数轴上 (0,1)(0,1) 上随机取 nn 个点,那么这 nn 个点把数轴分为 n+1n+1 个部分。每一部分的在数学期望的意义下应该是相等的。于是 E(x(k))=kn+1E(x_{(k)})=\frac{k}{n+1} 这个结论就很自然地得到了。

现在开始算结论。

从 U(0,1)U(0,1) 随机抽10个样本,其最大值为 x(10)x_{(10)} ,其期望为 1011\frac{10}{11} ;

从 U(0,1)U(0,1) 随机抽100个样本,第10大就是从小到大数第91个,也就是 x(91)x_{(91)}。从0数到这个点,要经过91段,所以它的期望是 91101\frac{91}{101}。

1011>91101\frac{10}{11}>\frac{91}{101} 。

按平均百分位来比,十人组的第一名略强。

如果把这两个人直接拉来比一场呢?把随机分组前的110人放在一起排,只有总榜前10名全是百人组的人,十人组第一才会输。反过来算,十人组第一大约有63%的机会赢。


有小朋友不禁要问了:10人中的第一名,可能相当于100人中的第几名呢?

列方程式: 1011=x101\frac{10}{11}=\frac{x}{101}

解得 x≈91.818x\approx91.818

101−91.818=9.182101-91.818=9.182

因此10人中的第一名,在数学期望的意义下,相当于100人中的第9.182名。这和用户“曾加”的回答是一样的。


可能还会有小朋友不禁要把这个问题一般化: aa 个人中的第一名,与 abab 个人中的第 bb 名,孰大?

容易验证: aa+1>ab+1−bab+1\frac{a}{a+1} > \frac{ab+1-b}{ab+1}

甚至再一般化:aa 个人中的第 kk 名,与 abab 个人中的第 bkbk 名,孰大?

容易验证: a+1−ka+1>ab+1−bkab+1\frac{a+1-k}{a+1} > \frac{ab+1-bk}{ab+1}

上面两条不等式在 b>1b>1 时成立。如果 b=1b=1,两组人数和要比的名次都一样,当然是等号。也就是说,按平均百分位来比,「鸡头」比「凤尾」强一点。


最后按照惯例,向读者抛出两个思考题:

1.皮皮欢乐中学的初中部和高中部分别有1000名学生。初中部的学生的百米成绩的分布是 U(12,14)U(12,14) ,高中部的学生的百米成绩的分布是 U(10,13)U(10,13)。

(1)从初中部和高中部分别抽1名学生出来进行赛跑,求初中部学生获胜的概率;

(2)从初中部和高中部分别抽4名学生出来进行赛跑,求初中部学生获得冠军的概率和初中部学生集体垫底的概率(求概率之前,不妨直观猜测下哪个概率更高?)。

2. 坤坤中学的初中部和高中部分别有1000名学生。初中部的学生的篮球水平服从 U(0,20)U(0,20),高中部的学生的篮球水平服从 U(0,100)U(0,100)。从高中部随机抽5人,再从初中部随机抽一批人。初中部最强的人比高中部这5人里最弱的人还强,这件事的概率能达到90%吗?为什么?

我在《大白话概率论》的「次序统计量」一节里也讲了前面切线段的办法:在0到1之间随机取3个点,切成4段,所以三个点从小到大的平均位置就是四分之一、二分之一、四分之三。书里讲贝塔分布时,我还解释了为什么这些点排好序以后,每个位置上的点都服从贝塔分布。
知乎原文

如何评价2019年高考全国卷I数学的压轴题?

我打算从统计学的角度分析压轴题的原理。

我先讲一个小例子。我们现在要通过比赛来决定徐徐和坤坤谁的三分球命中率高。可以有两种比赛方式。第一种方式是:徐徐和坤坤分别投十次球,看谁命中的次数多(或者徐徐和坤坤分别投若干次球,可以不相等,然后比较谁的命中率高);第二种方式是徐徐和坤坤进行多轮比赛。每一轮比赛中,徐徐和坤坤分别投一个球。经过多轮比赛,直到其中一个人比另一个人命中的次数多4次时,比赛停止。这两种方式都是可行的方式。第一种方式是最简单可行的方式。第二种方式技巧性更高些,也是我们今天要讲的主题。

原文配图

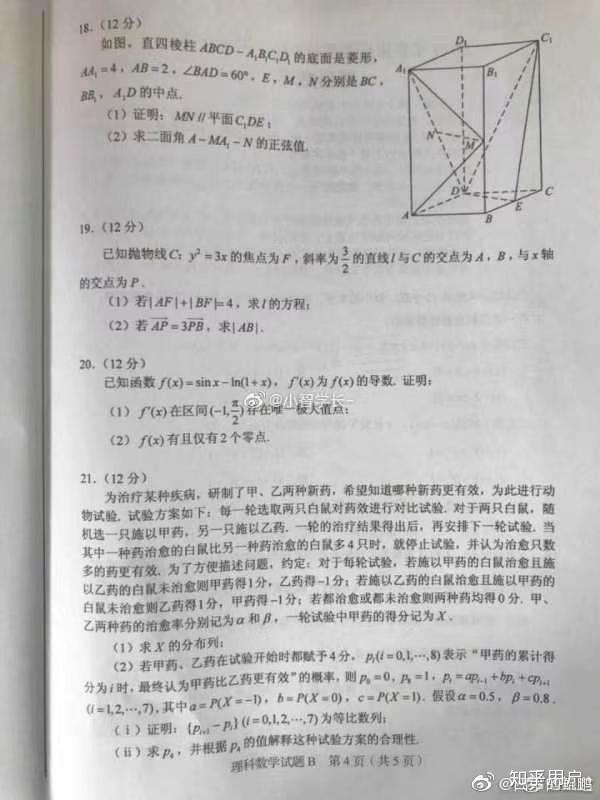
今年数学卷的最后一题(21题)是一道概率论与统计学方面的题。在统计学中检验两种药效的优劣有很多种方法。这道题提到的方法是其中一种。

一个最常见且自然的方法是:药物甲和药物乙分别用在 nn 个不同的小白鼠身上。记药物甲治愈了 aa 只小白鼠,药物乙治愈了 bb 只小白鼠。直观的想法是:若 a>ba>b ,则说明甲比乙更有效。当然直观的想法缺乏严谨性。如果考虑实验遵循的二项分布,可以精确地算出检验的拒绝域与两类错误。

本文以这道题为背景,并且对这道题经过稍微的改动,介绍另一种检验方法:进行若干轮实验。每一轮实验中,拎出一对幸运的小白鼠出来,其中一个吃药品甲,另一个吃药品乙。然后观察哪只小白鼠被治愈了,记录下来,然后进入下一轮试验。直到其中一种药物治愈的小白鼠的数目比另一种药物多4个,试验就停止。(为什么是4个?事实上,你也可以设置为1个,这样的话可能第一轮就分出胜负了,这种情况下检验的随机性太大;或者你也可以设置为10个或更多,这样的话几乎能保证实验检验的结果与真实结果接近(类似大数定律,实验次数越多,与真实情况越接近)。但是这样的话试验可能要进行很多轮,会浪费实验经费、时间成本、和可怜的小白鼠的生命)

再补充一点,乒乓球、羽毛球中有这样的规则:当达到赛点后,如果双方比分接近,那么再继续若干轮比赛,直到一方率先比另一方多2分,就判定领先的人获胜,这背后的思想与本题的思想是一致的。

记 Xj=1X_{j}=1,若药物甲成功治愈第 jj 个小白鼠;

Xj=0X_{j}=0 ,若药物甲未能治愈第 jj 个小白鼠;

Yj=1Y_{j}=1 ,若药物乙成功治愈第 jj 个小白鼠;

Yj=0Y_{j}=0 ,若药物乙未能治愈第 jj 个小白鼠。

当 |(X1+X2+……+Xn)−(Y1+Y2+……+Yn)||(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n})| 首次达到4时,则试验结束。若此时 (X1+X2+……+Xn)−(Y1+Y2+……+Yn)=4(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n})=4 ,则说明药物甲比药物乙的效果好。若此时 (Y1+Y2+……+Yn)−(X1+X2+……+Xn)=4(Y_{1}+Y_{2}+……+Y_{n})-(X_{1}+X_{2}+……+X_{n})=4 ,则说明药物乙比药物甲的效果好。

做这个检验关心的问题是弃真错误和取伪错误。先看取伪错误。什么是取伪错误?我们首先假定(即 H0H_{0} ):药物甲比药物乙好。如果的确药物甲比药物乙好,且实验的结果显示药物甲比药物乙好,那么我们没有犯错误。如果的确药物甲比药物乙好,但实验的结果显示药物乙更好,那么就犯了弃真错误。另一方面,如果药物乙比药物甲好,但实验的结果显示药物甲更好,那么就犯了取伪错误。

如果你第一次接触弃真错误和取伪错误两个概念,你可能对上面的描述有些犯晕。再举个例子:企业面试某个人,最后的结果有四种:①招到了有能力的人,②招到了没能力的人,③拒绝了有能力的人,④拒绝了没能力的人。结果①和④是好结果,没有犯错误。但是结果②和③是犯了错误的。拒绝了有能力的人,是弃真(顾名思义,放弃了真正有能力的人);招到了没能力的人,是取伪(顾名思义,是录取了没有能力的人)。

多说一句,在其他条件不变的情况下,弃真错误和取伪错误不能同时降低。你降低了弃真错误,必定会提升取伪错误。比如,你想降低弃真错误,即尽量不要拒绝有能力的人,那么你就要放低招人的标准。而放低了招人的标准,更加有可能会招到没能力的人。

当然弃真错误和取伪错误不是绝对的。你可以把有能力的人定义为“真”,也可以把有能力的人定义为“伪”。

回到这个问题,如果甲的药实际更好,实验却判乙更好,这叫弃真;如果乙的药实际更好,实验却判甲更好,这才叫取伪。

那么,判错的概率是多少呢?

设药物甲有效的概率是 p1p_{1} ,药物乙有效的概率是 p2p_{2} 。

则药物甲有效、药物乙无效的概率是 p1(1−p2)p_{1}(1-p_{2}) ,此时分数的差距(即 (X1+X2+……+Xn)−(Y1+Y2+……+Yn)(X_{1}+X_{2}+……+X_{n})-(Y_{1}+Y_{2}+……+Y_{n}) )是+1;药物乙有效、药物甲无效的概率是 p2(1−p1)p_{2}(1-p_{1}),此时分数的差距是-1。我们记这两种情况为“有效实验”。另外的情况是:分数差距不变,即两种药物都有效或者两种药物都无效,此时对应的概率为 p1p2+(1−p1)(1−p2)p_{1}p_{2}+(1-p_{1})(1-p_{2}) 。

综合来看,分数差距增加1的概率为:

P=P(P=P( 增加1 || 增加1或减少1 ))

=p1(1−p2)p1(1−p2)+p2(1−p1)=\frac{p_{1}(1-p_{2})}{p_{1}(1-p_{2})+p_{2}(1-p_{1})} (*)

对应地,分数差距减少1的概率为 1−P1-P 。

根据赌徒输光定理,赌徒每次以概率 pp 赢1元钱,那么在净输 mm 元之前,先净赢 mm 元的概率为 11+(1−pp)m\frac{1}{1+\left(\frac{1-p}{p}\right)^m}。(至于这个式子怎么来的,可以参考为什么说久赌必输?,这篇文章有轻微的涉及。如果有机会我会新开一篇文章讲述这个结论是怎么来的,现在你只需把这个当现成的结论即可)

接下来具体解释“赢了 mm 元之前,先输了 mm 元”的含义。背景是赌徒和另一个人在进行赌博,每个人的初始资产有 mm 元。其中一方输光所有的钱即为破产。“其赢了 mm 元之前,先输了 mm 元”指的就是赌徒破产。

同样的道理,可以把每一次有效实验看作是一次赌博。令 r=(1−P)/Pr=(1-P)/P,这里的 PP 就是(*)式算出的概率。甲先领先4分的概率是 11+r4\frac{1}{1+r^4},乙先领先4分的概率是 r41+r4\frac{r^4}{1+r^4}。如果 P=12P=\frac12,两边各有一半的机会。

原题里,甲的治愈率是50%,乙是80%。去掉打平的轮次,甲赢一轮的概率只有20%,所以最后误判甲更好的概率是 1257\frac{1}{257},不到0.4%。

这道题用到的两类错误和赌徒输光定理,我在《大白话概率论》里都展开讲了。两类错误用的是招聘的例子,赌徒输光从两个人各带多少钱开始算。

知乎原文

算命是确有其事还是空口大话?

网上或者生活中有很多有关“算命很准”的故事,这些故事并不能说明算命先生有超能力。哪怕这些故事都是真的,甚至哪怕你亲身经历过。

很多人认为算命很准,很可能是因为掉入了“归因谬误”、“强加因果”、“幸存者偏差”等逻辑陷阱和统计学陷阱。其次,算命先生说的话大多含糊其辞,不论结局如何都能用他的话圆过去。另外,对于有些容易受心理暗示的人来说,算命先生的话更容易应验。

这里不讲枯燥的理论,仅举三个有趣的例子。

第一个例子:100对夫妻找算命先生算他们将来会生男孩还是女孩,算命先生胡猜也能大概猜对一半。猜对的那一半夫妻中,有不少人会因此觉得算命先生很厉害。这个例子可以修改成其他的情况,如“你的丈夫以后会出轨”、“你在40多岁会有一场大病”等等。这些事件发生的概率本来就不会太小。

第二个例子:有一天杰克收到了一封信,这封信的内容是预测下一次足球比赛皇马会赢。他没有在意。几天后结果出来了,皇马果真赢了。接着他又收到了第二封信,说下一场比赛巴萨会赢,果不其然,巴萨赢了。这样连续十次,杰克都收到了正确的预测信。这个时候,如果第11封信写着“支付1000英镑,我会告诉你下一场比赛的结果,然后你可以通过赌球赚取更多的钱,快加入我们吧!”杰克很可能会稀里糊涂地上钩。

事实上,写信的人在第一场比赛之前,写了1024封信,其中512封信预测皇马会赢,另外512封预测皇马不会赢,然后分别寄给不同的人。比赛结束后,写信的人只给猜对的那一半继续寄信,再把他们对半分:一半预测下一场某支球队会赢,另一半预测这支球队不会赢。每轮人数减半,十轮以后,正好有一个人连续收到了十次正确的预测信。事实上,一开始可以寄更多信,比如2048、4096这样的量级。现在是互联网时代,一次性群发个几十万封邮件也是很常见的操作,那么在这个数量级下,会出现好几百个连续十次收到正确预测信的人——也对应着那些说算命先生正确预测出自己运势并深信不疑的人。

第三个例子:如果你抛一枚硬币,连续十次都是正面向上,你会不会认为这枚硬币有问题?如果只看这一枚硬币,连出十次正面确实很少见。但是如果做这样的实验:一个报告厅内坐了1024(2的10次方)名学生,每名学生都发了一枚硬币。这1024枚硬币都是一样的,而且都是正常的硬币,即正反面均匀。接下来,每个学生连续抛这枚硬币10次。可以算出,有约63%概率会出现至少一个“不幸”的学生,ta连续抛十次的结果都是正面向上。也就是说,哪怕这枚硬币是完全均匀完全公平的,仍然有概率出现极端情况,而且这个概率不算太低。如果你就是那个“不幸”的学生(设身处地地想一想),而且你不知道周围学生抛硬币的结果,那么你是不是会认为眼前的硬币是有问题的呢?这个例子也可以用在很多看起来很“玄学”实际上没什么大惊小怪的情况,比如算命。

知乎原文

在赌场每次下注的金额都是之前输的金额的2.5倍,只要赢一把就可以翻本,是不是不必赢?

可以先设想一个简单的游戏。假设你和小美进行多次抛硬币赌博。每轮抛硬币前,你可以声明任意金额x。如果硬币出现正面,则小美给你x元;如果硬币出现反面,则你给小美x元。

假设:①每把独立,赢和输的机会各一半;②资金和时间都不设上限,小美也一直接受下注;③只要双方结清了钱,那么你可以随时结束整个游戏。

你能保证一定赢钱吗?

有同学可能会这样想:由于每局获胜的概率都是 12\frac{1}{2} ,那么每轮游戏中,我的收支的数学期望为 12x+12(−x)=0\frac{1}{2}x+\frac{1}{2}(-x)=0 。那是不是说,我怎么下都不能保证赢钱?

在上面这些假设下,我有个几乎肯定能净赚1元的办法。

我可以采取如下策略:

第一局我声明1元。如果赢了,我就结束游戏。这样我能获胜1元。

如果第一局输了,那么第二局我声明2元。如果第二局赢了,我就结束游戏,那么我最终获胜1元。

如果第二局我再输了,那么第三局我声明4元。如果第三局赢了,我就结束游戏,那么我最终获胜1元。

也就是说:下一局的赌注都是前一局赌注的两倍。一旦我赢了,就结束游戏。这和题主的想法类似,都是输了就加注,赢一把就收手。

接下来证明:只要撑到第一次赢,这一轮就能净赚1元。

要是可以一直抛下去,第一次正面几乎肯定会出现。在这个策略中,第 nn 轮下注 2n−12^{n-1} 元。假设我在第 n+1n+1 轮第一次赢,这表示之前我已经连续输了 nn局,那么我已经输了 1+2+22+23+…+2n−1=2n−11+2+2^{2}+2^{3}+…+2^{n-1}=2^{n}-1 元。

在第 n+1n+1 轮我赢了 2n2^{n} 元。那么我最后的收益为 2n−(2n−1)=12^{n}-(2^{n}-1)=1 元。这就完成了证明。


再看一个变形。上面的策略是“如果输了,那么下一局的赌金翻倍”。如果策略变成“如果输了,那么下一局的赌金是上一局的三倍”。情况会变成怎么样呢?

同样的分析步骤就不再赘述了,最后的收益是 3n−(3n−1)2=(3n+1)23^{n}-\frac{(3^{n}-1)}{2}=\frac{(3^{n}+1)}{2} 元。前面连输得越多,第一次赢时的净收益越大,前提是你还能下得起那一把。


但是别急着高兴!以上的分析是基于一定的条件的。在现实生活中,你的资金是有限的。从1元开始翻倍,前19把都输的话,已经输掉了524,287元。第20把要下524,288元,两笔加起来,一共得准备1,048,575元。如果本金只有100万元,第20把就已经下不起了。如果本金够,但单注上限是100万元,那第21把才会碰到上限。

回想一下,要走到第20把,前19把都得输。连输这么多把的概率很小,可它不是零。另外,游戏还假定小美能够陪你一直赌下去。假如小美赢了你2万就拍屁股走人了,那么你就没有回本的机会了。

我在《大白话概率论》里用63元举了个例子:还是从1元开始翻倍,63元刚好够下六把。六把里只要赢一把就停,净赚1元;六把全输,就亏63元。六次独立抛硬币有64种等可能的结果,只有一种是六次全输,另外63种都赚1元。把账放在一起算,平均不赚不亏。所以,看起来经常能赢一块,不等于这套玩法能赚钱。

你也可以自己做一下这个实验。准备一个比较均匀的硬币和记录虚拟资产的小本本就可以。

知乎原文

为什么样本方差(sample variance)的分母是 n-1?

一、先上个核武器:拿具体的例子算一遍

这个问题在教材和网上已经有很多解答了。如果你还是云里雾里的,我们干脆拿 2、4、6、8 这四个数,把每一种情况都算一遍。

一个盒子里有四个小球,上面分别写着 2、4、6、8。这就是我们的总体。总体均值是 5,总体方差是 [(2−5)²+(4−5)²+(6−5)²+(8−5)²] ÷ 4=5。这个 5 先记住,等会儿拿它来对照。

现在从盒子里随机抽两次。第一次抽完把球放回去,再抽第二次。所以(2,4)和(4,2)是两种抽法,总共 16 种,每种出现的机会一样。

每抽到一组数,先算这两个数的平均值,再算它们离平均值的平方和。比如抽到(2,4),平均值是 3,平方和是 (2−3)²+(4−3)²=2。分母用 n,也就是除以 2,得 1;分母用 n−1,也就是除以 1,得 2。

剩下的也照这个方法算。16 种情况分别是:

  • (2,2):均值 2,除以 2 得 0,除以 1 得 0。
  • (2,4):均值 3,除以 2 得 1,除以 1 得 2。
  • (2,6):均值 4,除以 2 得 4,除以 1 得 8。
  • (2,8):均值 5,除以 2 得 9,除以 1 得 18。
  • (4,2):均值 3,除以 2 得 1,除以 1 得 2。
  • (4,4):均值 4,除以 2 得 0,除以 1 得 0。
  • (4,6):均值 5,除以 2 得 1,除以 1 得 2。
  • (4,8):均值 6,除以 2 得 4,除以 1 得 8。
  • (6,2):均值 4,除以 2 得 4,除以 1 得 8。
  • (6,4):均值 5,除以 2 得 1,除以 1 得 2。
  • (6,6):均值 6,除以 2 得 0,除以 1 得 0。
  • (6,8):均值 7,除以 2 得 1,除以 1 得 2。
  • (8,2):均值 5,除以 2 得 9,除以 1 得 18。
  • (8,4):均值 6,除以 2 得 4,除以 1 得 8。
  • (8,6):均值 7,除以 2 得 1,除以 1 得 2。
  • (8,8):均值 8,除以 2 得 0,除以 1 得 0。

现在分别看这 16 个结果的平均值。除以 2 的一列加起来是 40,平均是 40÷16=2.5;除以 1 的一列加起来是 80,平均是 80÷16=5。总体方差就是 5,所以用样本自己的均值算,除以 2 平均只算到一半,改成除以 1,平均才对上。这里说的是反复抽样的平均结果,单次抽样算出来的数还是会有偏差。

二、一个有趣但不严谨的角度

一个简单的结论:在形如 ∑i=1n(xi−c)2\sum_{i=1}^{n}{(x_{i}-c)^{2}} 的形式中,使 ∑i=1n(xi−c)2\sum_{i=1}^{n}{(x_{i}-c)^{2}} 取得最小值的 cc 是 x‾\bar{x} 。

证明: ∑i=1n(xi−c)2\sum_{i=1}^{n}{(x_{i}-c)^{2}}

=∑i=1n[xi−x‾−(c−x‾)]2=\sum_{i=1}^{n}{[x_{i}-\bar{x}-(c-\bar{x})]^{2}}

=∑i=1n(xi−x‾)2+∑i=1n(c−x‾)2=\sum_{i=1}^{n}{(x_{i}-\bar{x})^{2}}+\sum_{i=1}^{n}{(c-\bar{x})^{2}}

≥∑i=1n(xi−x‾)2\geq\sum_{i=1}^{n}{(x_{i}-\bar{x})^{2}}

即 ∑i=1n(xi−c)2≥∑i=1n(xi−x‾)2\sum_{i=1}^{n}{(x_{i}-c)^{2}}\geq\sum_{i=1}^{n}{(x_{i}-\bar{x})^{2}} ……①

由此可猜测,用 ∑i=1n(xi−x‾)2n\frac{\sum_{i=1}^{n}{(x_{i}-\bar{x})^{2}}}{n} 去估计方差可能会偏小,因为 ∑i=1n(xi−x‾)2\sum_{i=1}^{n}{(x_{i}-\bar{x})^{2}} 已经是在所有 ∑i=1n(xi−c)2\sum_{i=1}^{n}{(x_{i}-c)^{2}} 形式中最小的了。

这个角度能看出为什么会偏小。要算恰好偏小多少,就把上面等式里的 cc 换成总体均值 μ\mu。

∑i=1n(Xi−X‾)2=∑i=1n(Xi−μ)2−n(X‾−μ)2\sum_{i=1}^n(X_i-\bar X)^2=\sum_{i=1}^n(X_i-\mu)^2-n(\bar X-\mu)^2

独立同分布抽样时,右边第一项的期望是 nσ2n\sigma^2。第二项的期望是 nVar⁡(X‾)=σ2n\operatorname{Var}(\bar X)=\sigma^2。所以用样本均值算出来的平方和,平均刚好少掉一份总体方差,只剩 (n−1)σ2(n-1)\sigma^2。这就是为什么除以 n−1n-1,而不是 nn。

事实上,类似的结论还有: E([x−c]2)≥E([x−E(x)]2)E([x-c]^2)\geq E([x-E(x)]^2) ……②

即在所有 E([x−c]2)E([x-c]^2) 形式中,使得 E([x−c]2)E([x-c]^2) 取最小值的 cc 是 E(x)E(x) 。

更一般地,如果允许用 x 来预测 y,有一个很基础的结论: E([y−f(x)]2)≥E([y−E(y|x)]2)E([y-f(x)]^2)\geq E([y-E(y|x)]^2) ……③

这个结论的直观意义是:在均方误差的准则下,用条件期望去估计 yy 能够使得误差最小。

结论①②③很类似,背后的数学思想都是一样的。

三、再看一个更高级的角度:线性回归里的秩

在带截距的 rr 元线性回归中,假设设计矩阵满列秩、n>r+1n>r+1,误差均值为零、同方差且互不相关。误差项方差的无偏估计量是 Σ(y−ỹ)2n−(r+1)\frac{\Sigma(y-\tilde{y})^{2}}{n-(r+1)} 。特别地,取 r=0r=0 ,就是上面的情况。

这里 MM 是把 yy 投影到设计矩阵 XX 的列空间上的矩阵,ỹ=My\tilde y=My。设计矩阵有 r+1r+1 列,其中一列是截距。

证明: E(Σ(y−ỹ)2)=E(y′(I−M)y)E(\Sigma(y-\tilde{y})^{2})=E(y'(I-M)y)

=(Xβ)′(I−M)Xβ+σ2tr(I−M)=(X\beta)'(I-M)X\beta + \sigma^{2} tr(I-M)

=σ2tr(I−M)=\sigma^{2} tr(I-M)

=σ2[tr(I)−tr(M)]=\sigma^{2} [tr(I)-tr(M)]

=σ2[R(I)−R(M)]=\sigma^{2} [R(I)-R(M)]

=σ2[n−(r+1)]=\sigma^{2} [n-(r+1)]

若取 r=1r=1 ,则是一元线性回归的特例。


这个 2、4、6、8 的例子出自我的《大白话概率论:从数学直觉到 AI 视野》,书里在「统计量」这一节还有对样本方差的完整解释。

知乎原文

如何看待虎扑和 NGA 吵得不可开交的概率题?

这道题表述没歧义,也没有牵扯到频率学派与贝叶斯学派之争。

我简单复述一下题主的问题:

有三个一样的盒子,每个盒子里放两个球。一个盒子里是两个红球,一个是两个蓝球,还有一个是一红一蓝。先随机选一个盒子,再从这个盒子里随机摸出一个球。摸出来的是红球,问盒子里剩下的那个球也是红球的概率是多少?

P(抽到的盒子是“红红” | 第一次摸到了红球)

= P(抽到的盒子是“红红”,第一次摸到了红球)/ P(第一次摸到了红球)

= ( 13\frac{1}{3} )/( 12\frac{1}{2} )=2/3

理解这个问题的核心思想是:先摸盒子再摸球。摸完球并观测其颜色后,球所在的盒子是三个盒子中的哪个盒子的概率会发生改变。

给三个红球编个号:双红盒里的叫红1、红2,红蓝盒里的叫红3。先随机选盒,再随机摸球,这三个红球被摸到的机会一样。摸到红1或红2,盒子里剩下的就是红球;摸到红3,剩下的就是蓝球。所以在已经摸到红球的情况下,三种可能里有两种符合,答案就是三分之二。

如果换个问法:随机选一个盒子,不摸球,只告诉你里面至少有一个红球。那双红盒和红蓝盒才是各占一半。

这个问题在著名的统计学教材《Statistical Inference》里有提及。答案就是2/3。

关于这类简单而具有迷惑性的题还有很多,如三门问题、三囚犯问题、星期二男孩问题,针对这三个问题,可以参考:

有趣的数学——违反直觉的囚犯问题和三门问题


还在纠结三门问题?不如用代码暴力验证(附Python代码)

最后,开个脑洞:如果第一次摸到的是红球,把球放回原来的盒子,打乱后再从这个盒子里摸一次,第二次摸到红球的概率是多少?(5/6)

第一次摸到红球后,双红盒占三分之二,红蓝盒占三分之一。放回再摸,双红盒一定出红球,红蓝盒只有一半的机会出红球。所以双红盒的三分之二全算进去,红蓝盒的三分之一只算一半,加起来就是五分之六。

知乎原文

房间内有 100 人,每人有 100 块,每分钟随机给另一个人 1 块,最后房间内的财富分布怎样?

可能题主没有把问题表述清楚,导致大家回答的方向不一致。

先纠正两个大家在这个问题下犯的常见的错误:

1.均匀分布和分布均匀其实是两码事。

分布均匀表示大家的财富都差不多,比如基本上都是100元左右。

均匀分布表示大家的财富取值在某个区间内是等可能的。比如财富的取值区间是[50,150],那么在这个区间里,财富取任何值的人都有,且数量都是差不多的。比如财富为60元左右的人数、财富为100元左右的人数和财富为130元左右的人数差不多。

2.平方的期望和期望的平方不一定相等。

事实上,它俩的差就是方差:E(X2)−[E(X)]2=D(X)≥0E(X^{2})-[E(X)]^{2}=D(X)\geq0


回到正题,这个问题有三种理解:

1.一旦没钱,则立即退出游戏;

2.一旦没钱,则立即去银行借一元;

3.没钱的人不需要给钱给其他人,但是仍然可以接受他人的给予。

这三种情况我都用代码模拟了,代码贴在最后。模拟里每轮一起结算:先选好把钱给谁,等所有转账都完成,再看谁没钱。

如果是第一种理解的话,那么一直玩下去,几乎肯定只剩下两个人。这两个人在每轮中,每个人只把1元分给对方,那么各自的财富不变。这个思路也可以参考我的这篇文章:为什么说久赌必输?

这次跑到第 14,933,906 轮,剩下两个人,手里分别有 2,579 块和 7,421 块。为什么会剩两个?只要还剩三个人以上,就有机会让其他人围成一圈互相给钱,留一个人只出不进,直到他没钱退出。不管现在钱怎么分,这件事在接下来一万轮内都有一个固定的、大于零的机会发生。又因为每个人都不能把钱给自己,一轮下来至少有两个人收到钱,所以不会一下只剩一个。

如果是第二种理解的话,玩很多轮后,每个人扣掉欠款后的余额近似服从正态分布。一个直观的理解是:首先每轮大家的金额都要减1元,这个是不需要考虑的,因为一视同仁。然后,另外99个人,每个人都有九十九分之一的概率给你一元。你这轮收到多少,要看有几个人选中了你,平均是一元,收到两元或更多也不算少见。根据中心极限定理,玩很多轮以后,余额近似服从正态分布。平均还是100元,但玩得越久,分布就越宽。

模拟里,第 100 轮和第 10,000 轮,这 100 个人余额的标准差分别是 9.5 块和 98.3 块。平均都还是 100 块,但后一次的余额分布要宽得多。

如果是第三种理解的话,按这个规则模拟,玩到后面,财富分布近似是指数分布。

这一种跑了 5 次,每次 30 万轮。前 15 万轮不统计,后半程每隔 1,000 轮记一次这 100 个人的余额。75,000 条余额记录里,至少有 100 块的占 37.1%,至少有 200 块的占 13.7%,至少有 300 块的占 5.0%。门槛每提高 100 块,达到门槛的记录数差不多就只剩原来的三分之一,这就是这里说的「像指数分布」。

模拟代码

代码用 Python 和 NumPy,随机种子是 42。

import numpy as np

N, START = 100, 100
rng = np.random.default_rng(42)


def choose_other(n, size):
    # 先从 n-1 个选项里抽,再跳过自己。
    target = rng.integers(n - 1, size=size)
    return target + (target >= np.arange(n))


def changes(n, rounds):
    # 每人都给 1 块。数出每个人这一轮收到几块。
    target = choose_other(n, (rounds, n))
    labels = target + n * np.arange(rounds)[:, None]
    received = np.bincount(labels.ravel(), minlength=rounds * n)
    return received.reshape(rounds, n) - 1


# 1. 没钱就退出。
money = np.full(N, START)
rounds = 0
while len(money) > 2:
    # 一次生成几千轮;有人出局时,后面的轮次作废。
    path = money + changes(len(money), 4096).cumsum(axis=0)
    exits = np.flatnonzero((path <= 0).any(axis=1))
    k = int(exits[0]) if exits.size else len(path) - 1
    money = path[k]
    money = money[money > 0]
    rounds += k + 1
print("退出:轮数、剩下两人的余额", rounds, sorted(money.tolist()))

# 2. 可以一直欠钱。比较第 100 轮和第 10000 轮。
path = START + changes(N, 10_000).cumsum(axis=0)
print("允许欠钱:两次余额的标准差",
      path[[99, 9999]].std(axis=1).round(1).tolist())

# 3. 没钱的人只收不付。每一轮同时结算。
levels = np.array([100, 200, 300])
hits = np.zeros(3, dtype=int)
samples = 0
for _ in range(5):
    money = np.full(N, START)
    for t in range(1, 300_001):
        pay = money > 0
        target = choose_other(N, N)
        money += np.bincount(target[pay], minlength=N) - pay
        if t > 150_000 and t % 1000 == 0:
            hits += (money[:, None] >= levels).sum(axis=0)
            samples += N
print("不许欠钱:记录数、达到三个门槛的比例(%)",
      samples, (100 * hits / samples).round(1).tolist())

知乎原文

假设有个游戏,你可以无偿获得五千元,但有百万分之一的几率会当场毙命。那么你会玩多少次游戏?

百万分之一的概率有多低?举个具体点的例子:香港大约有400万男人。凤姐决定在香港随机抛4个绣球给四个男人,则任何一个男人被绣球砸到的概率大约为百万分之一。如果你去过香港,可以设身处地地假想一下这个情况。

对于大多数人来说,这个游戏肯定是要玩的。问题在于:你打算玩多少次?

只玩一次的话,明显不过瘾。如果玩很多次的话,又容易嗝屁。根据几何分布的结论,你期望在第100万次的时候挂掉;另一方面,如果你真的打算玩100万次,那么你将会有 1−1e≈0.6321-\frac{1}{e}\approx0.632 的概率在这100万次尝试中死亡。我想你肯定不会玩100万次。

玩多少次取决于你能接受的死亡概率。0.632这个概率太高,0.000001这个概率太低。对我而言,如果死亡率低于万分之一,那么我就会尝试去做。当然,我可以首先把这个“死亡接受率”一般化,定义为 β\beta 。对于我而言, β=0.0001\beta=0.0001 。

那么最多能玩多少次游戏,使得我挂掉的概率小于 β\beta 呢?

(1−0.000001)n=1−β(1-0.000001)^{n}=1-\beta

把 β=0.0001\beta=0.0001 代入,算得 n≈100n\approx100 。

也就是说,我打算玩100次就撒手。我在这100次的尝试内死亡的概率不会高于万分之一,且如果活下来了,能赚到50万。

对于有些心大的人,只要死亡概率小于百分之一,就会去做铤而走险。而有些胆小的人,哪怕死亡概率小于千万分之一也不会去做。

你的“死亡接受率 β\beta ”是多少呢?不妨计算下你能承受的尝试次数: n≈ln(1−β)ln0.999999n\approx\frac{ln(1-\beta)}{ln0.999999}

知乎原文

生男生女概率各 50%,每个家庭都生到第一个男孩就不再生,那么产生的男女比例是多少?

不知道大家有没有玩过三国杀的甄姬。她的一个技能是:你可以从牌堆顶抽出一张牌。若为黑色牌,你获得此牌,然后你可以重复此流程。

原文配图

我们可以把“牌是黑色”类比于“生了女孩”,“牌是红色”类比于“生了男孩”。

接下来求甄姬每次获得牌数的数学期望。记翻到红牌为“试验成功”,那么这是一个几何分布的模型。(几何分布的介绍可以见这篇文章:武辰:中美合拍的西游记到底何时开机?——谈概率论中的几何分布)

按这个假设,抽牌的次数的数学期望是2次。即每轮游戏中,甄姬平均要抽出2张牌。已知抽出的最后一张牌一定是红牌,且甄姬不能获得红牌,因此甄姬每轮能够获得的牌数的数学期望是1张。

回到抽牌环节。上文提到每轮游戏中,甄姬平均要抽出2张牌。其中有且只有一张牌是红色的,于是我们可以知道:每轮游戏中,平均要抽出一张一张红牌和一张黑牌。

对应于生孩子的模型:平均每对夫妻会生出一个男孩和一个女孩。因此男孩与女孩的数量的数学期望是相等的。

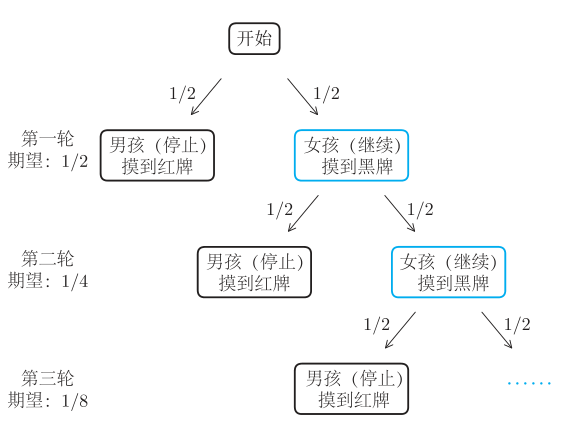
我们也可以一胎一胎地看。比如有 800 个家庭,第一胎平均有 400 个男孩、400 个女孩。生了男孩的家庭停下来,剩下的继续生。到第二胎,平均又是 200 个男孩、200 个女孩;第三胎,平均又是 100 个男孩、100 个女孩。你看,每一轮继续生的家庭越来越少,可这一轮出生的男孩和女孩,平均还是一样多。所以家庭足够多时,把所有孩子加起来,男女比例还是接近一比一。

原文配图
生男生女与「洛神」翻牌的概率树(《大白话概率论》第 2 章)

当然甄姬摸牌的数学期望不严格为1。首先由于木牛流马的存在,牌堆中的红牌比黑牌多一张。其次甄姬判定完一张黑牌后,牌堆的黑牌数减少。因此红黑牌的比例并不严格为1:1。

知乎原文

怎么理解互斥事件和相互独立事件?

事件 AA 与事件 BB 独立的定义是: P(AB)=P(A)P(B)P(AB)=P(A)P(B) 。

事件 AA 与事件 BB 互斥的定义是:集合 AA 与集合 BB 没有相同的样本点,即 A∩B=ϕA\cap B=\phi 。( ϕ\phi 代表空集, A∩BA\cap B 也可以简记为 ABAB )

如果事件 AA 与事件 BB 发生的概率都不为0,那么独立和互斥有这样一层关系:互斥不独立,独立不互斥。

证明:若 A、BA、B 互斥,则 AB=ϕAB=\phi ,那么 P(AB)=P(ϕ)=0P(AB)=P(\phi)=0 ,而 P(A)P(B)≠0P(A)P(B)\ne0 ,因此 P(AB)≠P(A)P(B)P(AB)\ne P(A)P(B) ,即A、BA、B 不独立。

另一方面,若 A、BA、B 独立,则有 P(AB)=P(A)P(B)P(AB)=P(A)P(B) 。接下来用反证法:假设A、BA、B互斥,则 AB=ϕAB=\phi ,那么 P(AB)=P(ϕ)=0P(AB)=P(\phi)=0 ,而 P(A)P(B)≠0P(A)P(B)\ne0 ,则 P(AB)≠P(A)P(B)P(AB)\ne P(A)P(B) ,产生矛盾。因此若 A、BA、B 独立,则A、BA、B 不互斥。

“互斥不独立,独立不互斥”是在事件 AA 与事件 BB 发生的概率都不为0的情况下才有的结论。

接下来我要强调一个概念:零概率事件与不可能事件是不同的。不可能事件的定义是:若 A=ϕA=\phi ,则 AA 是不可能事件;零概率事件的定义是:若 P(A)=0P(A)=0 ,则 AA 是零概率事件。咋一看,两个定义好像没有什么区别。的确,在离散情况下,两者是等价的。但是在连续场合,零概率事件是有可能发生的。比如 XX 服从(0,1)上的均匀分布,那么事件{ X=0.5X=0.5 }发生的概率为0,因为连续型随机变量取一个点的概率为0。但是事件{ X=0.5X=0.5 }是有可能发生的。不可能事件是比零概率事件更强的定义。因此若 P(A)=0P(A)=0 ,无法推出 AA 是空集。

类似地,1概率事件与必然事件是不同的。1概率事件是指发生概率为1的事件,但是它比“必然事件”更弱些。仍然举上面的例子:事件{ X≠0.5X\ne0.5 }发生的概率为1,但是它不是必然事件,因为事件{ X=0.5X=0.5 }仍然有可能发生。

于是有如下结论:零概率事件与任何事件独立;1概率事件与任何事件独立。我在这里只证明“零概率事件与任何事件独立”:设 P(A)=0P(A)=0 ,那么对于任何事件 BB ,有 A∩B⊆AA\cap B\subseteq A ,那么 P(AB)≤P(A)P(AB)\leq P(A) ,得到 P(AB)=0P(AB)=0 。于是有 P(AB)=P(A)P(B)=0P(AB)=P(A)P(B)=0 ,即A、BA、B 独立。类似地,“1概率事件与任何事件独立”留给读者自己证明。

我们已经知道,零概率事件与任何事件独立,1概率事件与任何事件独立。那么有没有什么事件与任何事件互斥呢?答案是:不可能事件与任何事件互斥。证明很简单:设 AA 是不可能事件,则 A=ϕA=\phi ,对于任何事件 BB ,有 A∩B=ϕA\cap B=\phi ,于是A、BA、B 互斥。

最后来一个终极问题:有没有什么事件与任何事件既独立又互斥呢?答案是:不可能事件与任何事件既独立又互斥!证明很简单:首先,不可能事件与任何事件互斥,这在上一段已经证明;又因为不可能事件一定是零概率事件,而零概率事件与任何事件独立。所以不可能事件与任何事件既独立又互斥。


我在《大白话概率论:从数学直觉到 AI 视野》第 3 章里,也用图和例子讲了互斥和独立:一个问的是「能不能同时发生」,另一个问的是「知道一件事发生了,会不会改变我们对另一件事的判断」。如果你想再看几个例子,可以翻翻书里「事件的独立性」那一节。