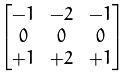武辰作品索引

知乎作品库

回答 · 5

知乎原文

对于神经网络,硕士博士不需要弄明白原理,只需要应用,是这样吗?

我觉得,如果你不从事AI理论研究的工作,你不需要对神经网络的原理有多么深刻的洞见,但是大概的直觉需要慢慢培养,而且是在实践中培养。

知乎有一些人说AI从事者的基本要求是:随时随地手撕反向传播、用纯numpy写一个神经网络等等。我觉得这些你能做到当然更好,做不到也不必强求,毕竟研究生也就两三年时间。你从大厂的AI岗抓一些算法工程师出来,让他们在不看任何资料的情况下手写反向传播公式,很多人也弄不对。

举一个具体的例子:你未必要弄懂①转置卷积为什么叫做“转置”卷积,为什么转置卷积会出现“棋盘效应”,转置卷积的梯度是怎么传播的……但是你要清楚②常见的上采样方式;转置卷积可以被双线性插值替换吗?如何解决转置卷积引起的棋盘效应?转置卷积的输入shape/输出shape与参数的关系……

如何弄清楚这些问题?多做几次对比实验,在实验中培养直觉。我曾经花了一个下午弄明白了①,但是这对我解决②没有太大帮助。而且你也未必需要马上能答出这些问题的答案,有大概的思路就行。比如你可以准备一个属于自己的有条理的code_base,相当于一个笔记本,当你遇到相关的问题的时候,通过查询code_base获取解决方案。

到实际工作后,除非纯理论研究的岗位,你会发现数学/原理对工作的用处不大。如何降低模型耗时,比如何提升准确率更重要。深刻的数学洞见可能对涨点有帮助,但是对于降低模型耗时来说,经验更重要。前处理、后处理也是大头。这些数据对于我的任务合适吗?我要如何处理这些数据,使得数据更好地服务于我的任务?通道数太多,内存会不会爆?如果很熟悉原理,那么原理可能会起到锦上添花的作用。如果不是很懂原理,那就多摸索多实验,纸上得来终觉浅,绝知此事要躬行。

知乎原文

人工智能是不是走错了方向?

关于深度学习是否是人工智能的正确方向,我比较赞同keras作者François Chollet的表述:深度学习模型仅仅是将一个向量空间映射到另一个向量空间的简单连续几何变换链。到目前为止,深度学习唯一的真正成功之处就是,给定大量的人工标注数据,它能够使用连续的几何变换将空间X映射到空间Y。做好这一点已经可以引起基本上所有行业的变革,但离达到人类水平的人工智能还有很长的路要走。

我个人觉得“集群”“涌现”应该是产生人工智能的钥匙。比如一个蚂蚁的智能度很低,但是一群蚂蚁会产生更复杂的智能。

知乎原文

怎样通俗易懂地解释反卷积?

在深度学习中,普通卷积可以缩小特征图,转置卷积可以把特征图放大。这里说的「反卷积」,指的是转置卷积。比如下面这个例子,普通卷积把 3×3 变成 2×2,转置卷积可以把 2×2 再变成 3×3。变回去的是尺寸,不是原来那 9 个数。那为什么叫「转置」?

先看普通卷积,假设一张图片只有9个像素:

x=[x1x2x3x4x5x6x7x8x9]x=\begin{bmatrix} x_{1} & x_{2} &x_{3} \\ x_{4} & x_{5} &x_{6} \\x_{7} & x_{8} &x_{9} \end{bmatrix}

如果经过kernel=2, stride=1, padding='valid'的普通卷积,那么经过卷积后的图片的分辨率是2*2。

注:这里先不考虑空洞卷积,也不额外调整转置卷积的输出尺寸。记特征图的输入分辨率大小为 in*inin*in ,卷积核大小为 f*ff*f ,步长是 ss ,padding的像素是 pp , 则经过普通卷积后输出分辨率大小的计算公式为: out=in−f+2ps+1out=\frac{in-f+2p}{s}+1 (公式1,分数部分向下取整) 同样的参数下,换成转置卷积,输出大小为 (in−1)s+f−2p(in-1) s + f- 2p (公式2)

假设普通卷积的卷积核为

w=[w1w2w3w4]w=\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix}

经过卷积后的输出 yy 为

y=[y1y2y3y4]y = \begin{bmatrix} y_{1} & y_{2} \\ y_{3} & y_{4} \end{bmatrix}

它是 [x1x2x3x4x5x6x7x8x9]\begin{bmatrix} x_{1} & x_{2} &x_{3} \\ x_{4} & x_{5} &x_{6} \\x_{7} & x_{8} &x_{9} \end{bmatrix} 经过 [w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix} 卷积得到的结果。

容易知道

y1=w1x1+w2x2+w3x4+w4x5y_{1}=w_{1}x_{1}+w_{2}x_{2}+w_{3}x_{4}+w_{4}x_{5}

y2=w1x2+w2x3+w3x5+w4x6y_{2}=w_{1}x_{2}+w_{2}x_{3}+w_{3}x_{5}+w_{4}x_{6}

y3=w1x4+w2x5+w3x7+w4x8y_{3}=w_{1}x_{4}+w_{2}x_{5}+w_{3}x_{7}+w_{4}x_{8}

y4=w1x5+w2x6+w3x8+w4x9y_{4}=w_{1}x_{5}+w_{2}x_{6}+w_{3}x_{8}+w_{4}x_{9}

可以用矩阵等价表示:

[y1y2y3y4]=[w1w20w3w400000w1w20w3w4000000w1w20w3w400000w1w20w3w4]⋅[x1x2x3x4x5x6x7x8x9]\begin{bmatrix} y_{1} \\ y_{2} \\ y_{3} \\y_{4} \end{bmatrix} = \begin{bmatrix} w_{1} & w_{2} &0 &w_{3} &w_{4} &0&0&0&0\\ 0&w_{1} & w_{2} &0&w_{3}&w_{4}&0&0&0 \\0 &0&0& w_{1} &w_{2} &0& w_{3} &w_{4} &0\\0 &0&0&0& w_{1} &w_{2} &0& w_{3} &w_{4} \end{bmatrix}\cdot \begin{bmatrix} x_{1} \\ x_{2} \\ x_{3} \\x_{4}\\x_{5} \\ x_{6} \\ x_{7} \\x_{8}\\x_{9} \end{bmatrix}

记权重矩阵 w̃=[w1w20w3w400000w1w20w3w4000000w1w20w3w400000w1w20w3w4]\tilde{w}=\begin{bmatrix} w_{1} & w_{2} &0 &w_{3} &w_{4} &0&0&0&0\\ 0&w_{1} & w_{2} &0&w_{3}&w_{4}&0&0&0 \\0 &0&0& w_{1} &w_{2} &0& w_{3} &w_{4} &0\\0 &0&0&0& w_{1} &w_{2} &0& w_{3} &w_{4} \end{bmatrix}

它的形状是4*9。

接下来看转置卷积。假设一张图片只有4个像素:

x=[x1x2x3x4]x = \begin{bmatrix} x_{1} & x_{2} \\ x_{3} & x_{4} \end{bmatrix}

经过kernel=2, stride=1, padding='valid'的转置卷积

卷积核 ww 是

[w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix}

根据公式2, yy 的形状是(3,3)即

y=[y1y2y3y4y5y6y7y8y9]y=\begin{bmatrix} y_{1} & y_{2} &y_{3} \\ y_{4} & y_{5} &y_{6} \\y_{7} & y_{8} &y_{9} \end{bmatrix}

那么 yy 是根据下面的矩阵得到的:

[y1y2y3y4y5y6y7y8y9]=[w1000w2w1000w200w30w10w4w3w2w10w40w200w3000w4w3000w4]⋅[x1x2x3x4]\begin{bmatrix} y_{1} \\ y_{2} \\ y_{3} \\y_{4}\\y_{5} \\ y_{6} \\ y_{7} \\y_{8}\\y_{9} \end{bmatrix} = \begin{bmatrix} w_{1} &0&0&0\\ w_{2} & w_{1} &0&0 \\0 &w_{2} &0 &0\\ w_{3} &0&w_{1} &0 \\ w_{4} & w_{3} &w_{2} &w_{1} \\ 0&w_{4} &0& w_{2} \\ 0&0&w_{3} &0 \\ 0&0&w_{4} &w_{3} \\ 0 &0&0 &w_{4} \end{bmatrix} \cdot \begin{bmatrix} x_{1} \\ x_{2} \\ x_{3} \\x_{4} \end{bmatrix} (公式3)

仔细看这里的权重矩阵,它的形状是(9,4),刚好是普通卷积的权重矩阵的转置。这正是转置的意义。


转置卷积还有一种直观的理解:

对于原图的输入 x=[x1x2x3x4]x = \begin{bmatrix} x_{1} & x_{2} \\ x_{3} & x_{4} \end{bmatrix}

首先对输入进行“full padding”(卷积的padding有三种形式,分别的"same""valid""full",详见最刚烈:卷积的三种模式full, same, valid以及padding的same, valid)

padding后的结果是

[00000x1x200x3x400000]\begin{bmatrix} 0 &0&0&0\\ 0 & x_{1} &x_{2}&0 \\0 &x_{3} &x_{4} &0\\ 0&0&0 &0 \end{bmatrix}

然后再经过 [w4w3w2w1]\begin{bmatrix} w_{4} & w_{3} \\ w_{2} & w_{1} \end{bmatrix} 的普通卷积,得到

y=[y1y2y3y4y5y6y7y8y9]y=\begin{bmatrix} y_{1} & y_{2} &y_{3} \\ y_{4} & y_{5} &y_{6} \\y_{7} & y_{8} &y_{9} \end{bmatrix}

这个结果和公式3的结果是一样的。

注意这里的卷积核是 [w4w3w2w1]\begin{bmatrix} w_{4} & w_{3} \\ w_{2} & w_{1} \end{bmatrix} ,是 [w1w2w3w4]\begin{bmatrix} w_{1} & w_{2} \\ w_{3} & w_{4} \end{bmatrix} 旋转 180° 得到的。前面转置的是把整个卷积写成矩阵之后的那个大矩阵。

知乎原文

不断抛骰子,抛到几点获得相应分数,抛到1点停止游戏,平均得分是多少?

“得分”指的是一次抛骰子的得分,还是直到游戏结束抛骰子的总得分?如果把“直到游戏结束的一直抛骰子的过程”定义为1次游戏:

“平均得分”的第一种理解是,先算每局的平均分,再把各局的平均分取平均;

“平均得分”的第二种理解是,每次游戏的总得分的数学期望。

先看第二种理解,可以把题主的问题一般化:

袋中有编号 1,2,....n1, 2, .... n 的 nn 个球,从中任取1个球,取到 ii 号球得 ii 分。若i>=2i>=2 ,把球放回重新摸。若 i=1i=1 ,则停止摸球。求得到总分的数学期望。

解答:

如果第一次取的球为1号球(这种情况发生的概率是 1n\frac{1}{n} ),游戏停止,得到1分;

如果第一次取的球为2号球(这种情况发生的概率是1n\frac{1}{n}),则得2分,接下来的游戏等价于重新开始;

如果第一次取的球为3号球(这种情况发生的概率是1n\frac{1}{n}),则得3分,接下来的游戏等价于重新开始;

其他同理。

所以 E(X)E(X)

=1n+2+E(X)n+3+E(X)n+……+n+E(X)n=\frac{1}{n}+\frac{2+E(X)}{n}+\frac{3+E(X)}{n}+……+\frac{n+E(X)}{n}

解方程可得 E(X)=n(n+1)2E(X)=\frac{n(n+1)}{2}

仔细品这个答案——它正好是从1加到 nn 的和。

从这个答案可以猜测:是不是和“1号球”无关?如果我把“取到1号球时,游戏停止”改为“取到10号球时,游戏停止”,结果是一样的。套用上面的过程,很容易证明。


以上求得了“一次游戏”的总得分的数学期望,而且证明了它和几号球停止无关。

那么,如果先算每局的平均分,再把各局的平均分取平均,会得到多少呢?

虽然每局的平均分等于 一次游戏的总得分一次游戏中的取球次数\frac{一次游戏的总得分}{一次游戏中的取球次数} ,

但是把各局的平均分再取平均,不能直接用 一次游戏的总得分的数学期望一次游戏中的取球次数的数学期望\frac{一次游戏的总得分的数学期望}{一次游戏中的取球次数的数学期望}

先写个python程序验证下:

import random
ball_list = list(range(1,7)) #假设袋子里一共有6个球
random.shuffle(ball_list)

total_sum = []
total_avg = []
for i in range(100000): #模拟做100000次实验
    t = []
    while True:
        single_ball = random.choice(ball_list)
        t.append(single_ball)
        if single_ball == 6: #如果摸到了6号球,则停止摸球
            break
    total_sum.append(sum(t))
    total_avg.append(sum(t)/len(t))
print(sum(total_sum)/len(total_sum)) #一次游戏的总得分的数学期望
print(sum(total_avg)/len(total_avg)) #每局先算平均分,再对各局取平均

结果验证了,一次游戏的总得分的数学期望是 n(n+1)2\frac{n(n+1)}{2} ,而且和几号球停止无关。但各局平均分再取平均,结果就和几号球停止有关了。

按每局先算平均分的算法,摸到6号球停,大约是4.075;摸到1号球停,大约是2.925。单独掷一次骰子,平均是3.5分,和几号球停没关系。


一个思路:拿骰子来说,把每次掷到的点数翻个面,1变6、2变5、3变4。两局掷的次数一样,每一对点数加起来都是7,所以两局的平均分加起来也是7。一般地,游戏停止条件为 ii 号球,这一局的平均分为 jj 的概率,等于游戏停止条件为 n+1−in+1-i 号球,这一局的平均分为 n+1−jn+1-j 的概率。

那么记 E(i)E(i) 为游戏停止条件为 ii 号球时,每局平均分的数学期望,则有

E(i)+E(n+1−i)=n+1E(i)+E(n+1-i)=n+1

比如在抛骰子的游戏中,

E(1)+E(6)=E(2)+E(5)=E(3)+E(4)=7E(1)+E(6)=E(2)+E(5)=E(3)+E(4)=7

知乎原文

为什么 CNN 里有 maxpooling,没有 minpooling?

题主有没有想过卷积层后的数值代表着什么?

模型的输入是图像,图像的数值一般代表灰度。比如灰度图的数值取值在[0,255]区间中,数值越高,代表颜色越白。

卷积层后的特征图的数值又代表什么?卷积本质上是提取特征的工具。比如下面的卷积核用来识别一个像素是否具有“左边周围的灰度值与右边周围的灰度值有较大差异”的模式或特征。

原文配图

同理,下面的卷积核用来识别一个像素是否具有“上面周围的灰度值与下面周围的灰度值有较大差异”的模式或特征。

原文配图

卷积后的数值越高,说明此模式越明显,即卷积成功提取到了特征,或者说找到了规律。如果使用minpooling,卷积好不容易提取出来的特征就被舍弃了。

知乎原文

甲有101个硬币,乙有100个硬币,两人随机撒在地面上,甲比乙正面朝上多的概率是多少?

先来一个巧妙的方法

第一轮,两个人各扔100枚硬币。第二轮,甲再扔手上剩的那一枚。

第一轮甲要是领先,最后那枚怎么扔都赢。要是落后,最后一枚最多追平。只有第一轮打平,才看甲最后那一枚是不是正面。

记第一轮打平的概率为 pp。第一轮两人扔的一样多,甲领先和乙领先的机会一样。所以没打平的那部分,甲占一半。

最后,把这两种能赢的情况加起来:

P(第一轮甲乙相等)P(第二轮甲正面)+P(第一轮甲比乙正面多)

= p⋅12+1−p2p\cdot\frac{1}{2}+\frac{1-p}{2}

= 12\frac{1}{2}


接下来是两个一本正经的方法。

方法一:把正反面对调

记 x1x_{1} =甲的101个硬币中,正面向上的个数

x2x_{2} =乙的100个硬币中,正面向上的个数

y1y_{1} =甲的101个硬币中,反面向上的个数

y2y_{2} =乙的100个硬币中,反面向上的个数

把所有硬币都翻个面,刚才数正面,现在就变成数反面了。正反面一样可能,所以「甲的正面更多」和「甲的反面更多」的概率一样。

有 P(x1>x2)=P(y1>y2)P(x_{1}>x_{2})=P(y_{1}>y_{2})

接下来有个关键:甲总共只多一枚。所以正面和反面不可能都比乙多,也不可能都不比乙多。换句话说,甲的正面更多,就等于甲的反面没有乙多,或者跟乙一样多。写成式子就是:

P(x1>x2)P(x_{1}>x_{2})

=P(101−x1<101−x2)=P(101-x_{1}<101-x_{2})

=P(y1<y2+1)=P(y_{1}<y_{2}+1)

=P(y1≤y2)=P(y_{1}\leq y_{2})

因此 P(y1>y2)=P(y1≤y2)P(y_{1}>y_{2})=P(y_{1}\leq y_{2})

又因为 P(y1>y2)+P(y1≤y2)=1P(y_{1}>y_{2})+P(y_{1}\leq y_{2})=1

所以 P(x1>x2)=12P(x_{1}>x_{2})=\frac{1}{2}


方法二:用二项分布算

记x=抛101个硬币,正面向上的个数

y=抛100个硬币,正面向上的个数

x和y都符合二项分布,且相互独立。它们的分布律为:

Px(x=k)=C101k(12)101P_{x}(x=k)=C_{101}^{k}(\frac{1}{2})^{101}

k=0,1,...,101k=0,1,...,101

Py(y=m)=C100m(12)100P_{y}(y=m)=C_{100}^{m}(\frac{1}{2})^{100}

m=0,1,...,100m=0,1,...,100

那么 Px,y(x=k,y=m)=C101kC100m(12)201P_{x,y}(x=k, y=m) = C_{101}^{k}C_{100}^{m}(\frac{1}{2})^{201}

简记为 Px,y(x,y)=C101xC100y(12)201P_{x,y}(x, y) = C_{101}^{x}C_{100}^{y}(\frac{1}{2})^{201}

令 u=x−yu=x-y

v=yv=y

其中 v∈Zv\in Z 且 0≤v≤1000\leq v \leq 100

u∈Zu\in Z 且 −v≤u≤101−v-v\leq u \leq 101-v

知道了正面差多少,也知道乙有几个正面,就能把甲的正面数算回来。所以把原来式子里的 xx 换成 u+vu+v,yy 换成 vv,就得到:

Pu,v(u,v)=C101u+vC100v(12)201P_{u,v}(u,v)=C_{101}^{u+v}C_{100}^{v}\left(\frac12\right)^{201}

甲赢,就是正面数的差大于0。在上面的取值范围里,把这些情况的概率加起来:

P(x>y)=P(u>0)=∑u=1101∑v=0101−uC101u+vC100v(12)201P(x>y)=P(u>0)=\sum_{u=1}^{101}\sum_{v=0}^{101-u}C_{101}^{u+v}C_{100}^{v}\left(\frac12\right)^{201}

这个和不用一项一项算。把乙的100枚硬币全翻过来,原来甲的正面数加上乙的反面数,就成了这201枚硬币的正面总数,也就是 x+100−yx+100-y。甲要赢,这个数就得超过100。201是奇数,正面和反面不会打平;两边又一样可能,所以答案还是一半。
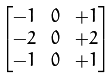
知乎原文

有哪些统计学专业反直觉的知识?

我在这里拾人牙慧,用初等的语言解释其他答主的观点中的一个小角度。

设 X1,X2,X3X_{1},X_{2},X_{3} 独立同分布于标准正态分布。

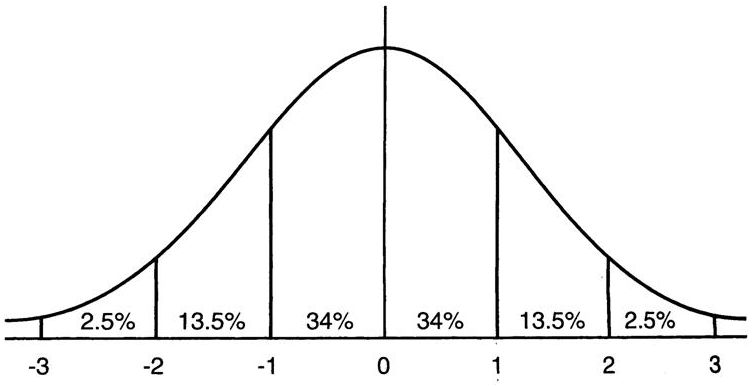
考察 Y1=X12Y_{1}=X_{1}^{2} ,我们知道标准正态的密度图像长这样:

原文配图

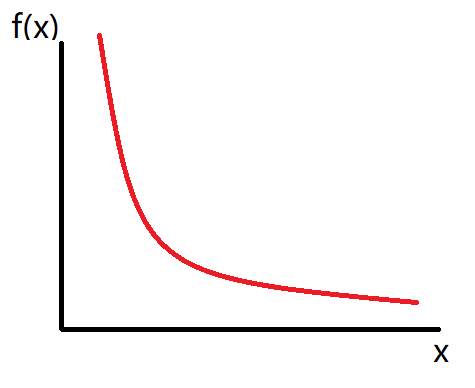
这个图像的特点是中间高,两边低。即 X1X_{1} 的绝对值大部分比较小,从图中可以看出,有68%的概率在(0,1)之间。那么对于 Y1Y_{1} 来说,同样地,取值越大,其密度越低。 Y1Y_{1} 的密度函数大概是单调下降的形状:

原文配图

考察 Y2=X12+X22Y_{2}=X_{1}^{2}+X_{2}^{2}。这两个平方各自的曲线都往下走。算出来,加在一起的曲线这回也还是往下走的。

到目前为止,这仍然是符合直觉的。

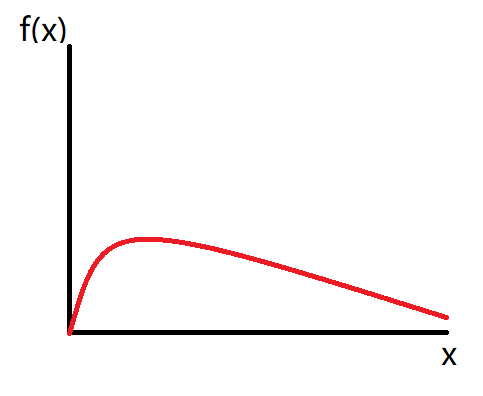
考察 Y3=X12+X22+X32Y_{3}=X_{1}^{2}+X_{2}^{2}+X_{3}^{2} ,顺着这个直觉, Y3Y_{3} 的密度图像似乎也该往下走。但是其密度图是下图的形状,峰值反而不在接近0的地方。

原文配图

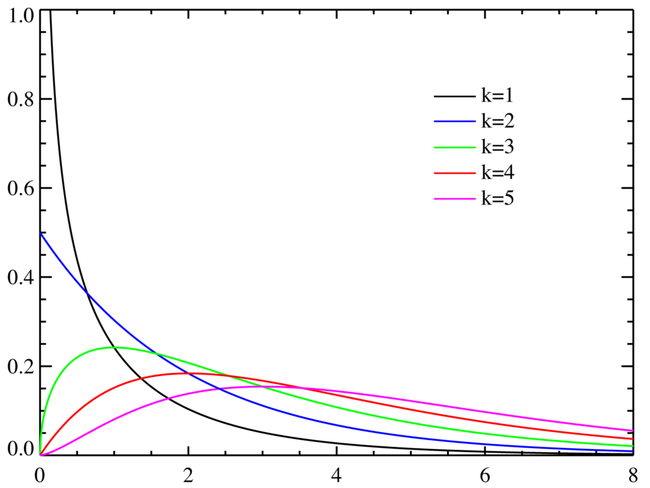
统一来说,YiY_{i} 服从自由度为 ii 的卡方分布。下图是不同自由度的卡方分布的密度图像。可以看出,从3自由度开始,密度图像的形态发生了本质的变化。

评论区的王希给出了一个简单的解释,让我茅塞顿开。我想到一个类似的直观的解释:把这三个数当成空间里的一个点。平方和很小,这个点就只能落在原点附近的小球里。把小球半径缩到一半,平方和的范围变成原来的四分之一,可球里的概率差不多只剩八分之一。越贴近0,概率掉得比区间缩得还快,所以曲线反而抬不起来。

原文配图

再补充一个: XiX_{i} 是 (0,t)(0,t) 均匀分布上的样本。要估计参数 tt,只需要知道样本中最大的值就行。找最大值当然得把样本都看一遍。我说的是,假如已经知道最大值是8,右端点就不能比8小。其他几个数是3还是5,不会改变右端点的最大似然估计。普通指数分布就不一样了:要估发生率,得看平均等待时间的倒数;如果问的是整个分布从哪儿开始,才看样本最小值。

我在《大白话概率论》里把这两种估计放在同一节里讲过:为什么均匀分布的右端点要看最大值,指数分布的发生率却要看平均值。有兴趣的可以看看。

知乎原文

在一个圆里随机取n个点,它们在同一个半圆的概率是多少?

前几天知乎出现了这样一道题:在一个球内任取n个点,则这n个点落在同一个半球内的概率是多少?

这个链接是我的回答:

在一个球内任取n个点,则这n个点落在同一个半球内的概率是多少?

现在这道题应该比上面的题目简单,毕竟经过了降维打击。

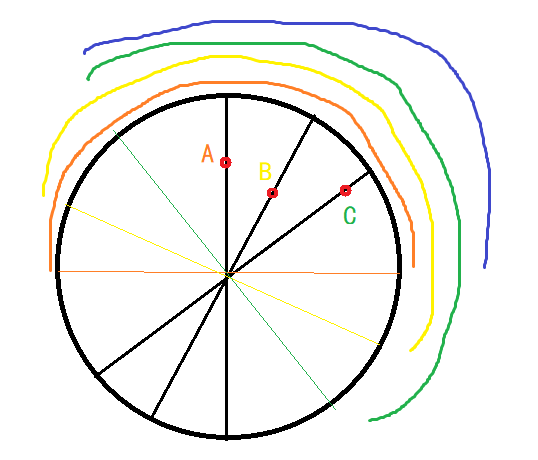
第一步,把圆看作一个池塘,把点看成鸭子。定义一只鸭子的领地:作鸭子b关于圆心的对称点b',然后连接bb',bb'的中垂线(即直径)把圆分为两个部分,b所在的半圆就是b的领地。另外,我们定义那条直径为鸭子b的“领土分割线”。

第二步:​由于对称性,对每只鸭子都作出关于圆心的对称点。这样一共有2n个点。这样,问题可以从“在圆内随机取n个点”转为:在2n个点中取n个点,其中对于每只鸭子和它的对称点,只能选一个出来。这样一共有2n2^{n}种选法。这里不是另外抽了2n个点,而是给每只鸭子找了一个正对面的点。每一对的位置先定住,再选哪一边,都是五五开。

第三步:一个简单又有趣的事实是:如果你出现在了我的领地,那么我肯定也出现在你的领地。在这个事实的基础上,我们可以推出:n只鸭子在同一半圆,等价于它们的领地有一块共同的地方。这里不算边界,不然光是圆心,就已经在每只鸭子的领地边上了。

第四步:最抽象的一步。​在2n2^{n}种选法中,有多少种选法,使得选出来的n只鸭子的领地有公共交集?我们知道,n只鸭子分别对应着n个领地和n条“领土分割线”。简单起见,可以拿n=3的情况举例:三条领土分割线把圆分为了6个部分,每个部分一一对应于一个交集,这个交集是什么?是所有领土的公共交集。那么一般地,n只鸭子的n条领土分割线,把圆分成了2n段,其中每一段一一对应于一个交集,即n只鸭子的领地有公共交集的情况。

补充一个粗糙的图示:A、B、C是三只鸭子。橙色直径是鸭子A的领土分割线,橙色圆弧所在的半圆是鸭子A的领地。鸭子B对应的是金黄色,鸭子C对应的是绿色。三只鸭子的领土有一个公共交集,就是蓝色圆弧围成的扇形。

事实上,ABC三只鸭子这样的排位只是其中一种情况(比如,我可以选择AB两只鸭子,第三只鸭子不选择点C,而选择点C关于圆心的对称点)。橙色、黄色、绿色领土分割线把圆分为了六个部分,每个部分都一一对应一种公共交集的情况。

原文配图

第五步:在2n2^{n}种选法中,一共有2n选法是存在交集的。因此概率是2n2n\frac{2n}{2^{n}}。

知乎原文

在一个球内任取n个点,则这n个点落在同一个半球内的概率是多少?

前些天有人以500元悬赏此题,我给出了答案。后来悬赏人表示此题在上世纪已有解答,于是作废悬赏。

当时的题目是:n只鸟随机出现在球内,求这些鸟出现在同一个半球的概率。

这个问题和我之前讨论过的一个问题很类似:

一道机器学习岗位面试题:求圆上任取三个点组成锐角三角形的概率

下面是我当时给的解答。

第一步:定义一只鸟a的领地:作点a关于球心的对称点a',然后连接a和a',作aa'的中垂面。这个中垂面会把球分为两个半球,a所在的半球定义为a的领地。

第二步:先把每只鸟沿着从球心出发的直线推到球面上。半球是用过球心的平面切出来的,往外推只改变鸟离球心的距离,不改变它在哪一边。

由于对称性,对每只鸟都作出关于球心的对称点。这样一共有2n个点。现在先固定这n对点,在每对里选一个:要么选这只鸟,要么选它的对称点。因为每只鸟原来都是独立均匀地出现在球内,所以每对选哪边都是五五开,各对也互不影响。这样一共有 2n2^n 种等可能的选法。这一步的转换的确不是那么好理解,可以先往下看。

第三步:一个简单又有趣的事实是:如果你出现在了我的领地里面,那么我肯定也出现在你的领地里面。在这个事实的基础上,我们可以推出:n只鸟在同一个半球,等价于它们的领地在球面上有一块共同的区域。为什么?在这块区域里挑一个点,每只鸟都让它进了自己的领地,反过来,它的领地也就装得下所有鸟了。反过来,一个能装下所有鸟的半球,它的正中也一定在每只鸟的领地里。

这里说的是领地内部,不把边界算进去。不然光是球心,就已经在所有领地的边界上了。

第四步:最抽象的一步。在 2n2^n种选法中,有多少种选法,使得选出来的n个鸟的领地有公共交集?为了便于理解,我们可以从二维的情况入手。在二维中,我们同样可以定义一个鸭子(2019年8月26日注:一个鸭子即一个点,这牵扯到另一道题,我后面会提到)的领地,即作鸭子b关于圆心的对称点b',然后连接bb',bb'的中垂线(即直径)把圆分为两个部分,b所在的半圆就是b的领地。另外,我们定义那条直径为鸭子b的“领土分割线”。

我们昨天悬赏的题目是四个鸭子(2019年8月26日注:四个鸭子的题是指:圆内随机出现四个鸭子,那么四个鸭子位于同一个半圆的概率是多少?答案是0.5),那么四个鸭子分别对应着四个领地和四条“领土分割线”。经过简单的列举,我们发现,四条领土分割线把圆分为了8个部分,每个部分一一对应于一个交集,这个交集是什么?是所有领土的公共交集。 具体怎么对应呢?随便挑其中一块,在每对鸭子和它的对称点里,选领地盖住这一块的那个点。8块就对应8种选法。

因此,回到三维的情况。我们同样定义鸟的“领土分割线”,这个领土分割线就是中垂面与球面的交线,也就是球面上的一个大圆。跟刚才一样,每一块都对应一种选法:每对点里,选领地盖住这块的那个点。所以我们只要数,这些大圆把球面分成了多少块。

你可以先简单地验证两种情况:一个大圆把球面分成2块,两个大圆把球面分成4块。再画第 kk 个大圆,它和前面的每个大圆各交两次,通常会得到 2(k−1)2(k-1) 个不同的交点。这些点把新画的大圆分成同样多的小段,每一段都把原来的一块切成两块,所以就多了 2(k−1)2(k-1) 块。也就是说,从第2个大圆开始,每次多切出2块、4块、6块……再加上第一个大圆切出的2块,一共有 n2−n+2n^2-n+2 块。

有些特殊情况,比如两个大圆重合,或者三个大圆刚好交在同一个点,切出的块数会少一点。不过球内独立均匀取点时,碰上这些情况的概率是0。

第五步:在 2n2^n 种等可能的选法中,一共有 n2−n+2n^2-n+2 种能让所有鸟落在同一个半球。所以概率是 n2−n+22n\frac{n^2-n+2}{2^n}。

(2019年8月28日注:有很多朋友反映n=3时,这个概率为1。这是没毛病的,因为任何三个点肯定在同一个半球。正如圆内任何两个点肯定在同一个半圆。)

一个经过了降维打击的类似的题目:

在一个圆里随机取n个点,它们在同一个半圆的概率是多少?

在一个圆里随机取n个点,它们在同一个半圆的概率是多少?

这道题用到了把点翻到对面的办法。我在《大白话概率论》里还讲了一道用同样想法的题:从圆周上随机取三个点,问围成锐角三角形的概率。有兴趣的可以看看。

知乎原文

100人坐飞机,第一个乘客在座位中随便选一个坐下,第100人正确坐到自己坐位的概率是?

20240624更新:

先说答案:12\frac12。不用追每个人坐哪儿,只盯着第1个和最后一个登机的人原来的座位。每次有人要随机选座,只要这两个座位都空着,他选中它们的机会就一样。第1个座位先被坐,后面的人就都能对号入座;最后一个座位先被坐,最后登机的人就坐不对了。所以两种结果各占一半。

也可以递推。记 PnP_n 为最后一个人坐对的概率。第1个人如果坐了自己的位置,最后一人一定坐对;如果坐了最后一人的位置,最后一人一定坐错;如果坐了第 kk 个位置,那就从第 kk 个人重新开始算,问题缩小成 n−k+1n-k+1 个人。

P2=12,Pn=1n+1n∑j=2n−1Pj=12(n≥3)P_2=\frac12,\qquad P_n=\frac1n+\frac1n\sum_{j=2}^{n-1}P_j=\frac12\quad(n\ge3)


登机顺序可以随机,但得说清楚谁乱坐。如果总是第一个登机的人乱坐,问实际最后登机的那个人,答案还是 12\frac12。

如果是固定一个人没登机牌,他也和其他人一起随机排队,那就不同了。他排到最后的概率是 1100\frac1{100},这时所有人都能坐对;他没排到最后时,实际最后登机的人还是五五开。所以这种规则下,最后登机的人坐对的概率是 1100+99100⋅12=101200\frac1{100}+\frac{99}{100}\cdot\frac12=\frac{101}{200}。

这道题很有意思,可以做很多扩展。

扩展一:平均有多少人没有坐到自己的位置?

曾加的答案指出:第 kk 个人登机时,他的座位被占的概率是 1102−k\frac{1}{102-k} 。

若第 ii 个人没坐到自己的位置,记 Xi=1X_i=1,否则记 Xi=0X_i=0。

记 X=∑i=1100XiX=\sum_{i=1}^{100}{X_{i}} 。

易知 E(X1)=1⋅P(X1=1)+0⋅P(X1=0)=99100E(X_{1})=1 \cdot P(X_{1}=1)+0\cdot P(X_{1}=0)=\frac{99}{100} ,

对于 2≤i≤1002\le i\le100,第 ii 个人坐错的概率就是他的座位被占的概率:

E(Xi)=P(Xi=1)=1102−iE(X_i)=P(X_i=1)=\frac1{102-i}

把每个人坐错的概率加起来:

E(X)=99100+∑i=21001102−i=1+12+13+⋯+199≈5.18E(X)=\frac{99}{100}+\sum_{i=2}^{100}\frac1{102-i}=1+\frac12+\frac13+\cdots+\frac1{99}\approx5.18

竟然是神奇的调和级数。

推广到 nn 个人,平均坐错的人数是 Hn−1=∑i=1n−11iH_{n-1}=\sum_{i=1}^{n-1}\frac1i。人数很多时,它大致按 ln⁡(n−1)\ln(n-1) 的速度增长。


扩展二:在第一个人坐错位置的条件下,平均有多少个人坐错了位置?

直观地想,这道题的答案应该只比上面的答案大一点点。因为第一个人在100个座位中乱选一个,几乎会坐错位置。即两道题的条件很接近。

严格的数学推导:

若第一个人坐错了位置,则记 AA 发生。

分两种情况算:第一个人坐对时,后面的人全能坐对,所以这时坐错人数是0。

E(X)=P(A)E(X∣A)+P(A‾)E(X∣A‾)=99100E(X∣A)E(X)=P(A)E(X\mid A)+P(\bar A)E(X\mid\bar A)=\frac{99}{100}E(X\mid A)

所以只看第一个人坐错的情况,平均坐错的人数是 E(X∣A)=10099H99≈5.23E(X\mid A)=\frac{100}{99}H_{99}\approx5.23。

结果表明,两种情况下的数学期望的差距不大。

注意,这里的结果产生了ln,之前有一个知乎问题:如何通过实验产生e。这里的思路可以作为答案。


扩展三:假如所有乘客都是疯子。那么第100个人能坐到自己座位的概率是多少?平均有多少人在自己的座位上?

这是著名的“配对问题”,一个等价的描述是:n个人把各自的帽子放在一起,然后每人随机抽取一个,平均几人拿到自己的帽子?

答案可以很直观地导出:第100个人能坐到自己座位的概率是 1100\frac{1}{100} ;事实上,每个人能坐到自己位置上的概率都是 1100\frac{1}{100} ,因此根据期望的加和法则,平均只有1人正确地坐到了自己的位置上,这个结论也与 nn 无关!

扩展四:所有人都坐错座位的概率是多少?

这里还是接着上一问:每个人都从剩下的座位里随机选。这就像把信随机塞进信封,问是不是每一封都装错了。每个人坐错的概率虽然一样,却不能直接相乘,因为一个人坐在哪儿会影响后面的人。

可以反过来数。先排除至少一个人坐对的排法:把每个人坐对的概率减掉;有两个人都坐对的排法被减了两遍,要加回来;三个人都坐对的再减掉,依此类推。这个办法就是容斥。

P(全坐错)=∑k=0n(−1)kk!=1−1+12!−13!+⋯+(−1)nn!P(\text{全坐错})=\sum_{k=0}^n\frac{(-1)^k}{k!}=1-1+\frac1{2!}-\frac1{3!}+\cdots+\frac{(-1)^n}{n!}

人数越多,这个概率越接近 1e\frac1e,大约是36.8%。这又与自然常数 ee 扯上了关系。


扩展五:人人乱坐时,人数多了,坐对人数近似服从均值为1的泊松分布。如果只有第一个人乱坐,前面算出平均有 n−Hn−1n-H_{n-1} 个人坐对。那这种情况下,坐对人数的具体分布又是什么?

一旦知道具体的分布,不仅可以算数学期望(尽管我们已经算出数学期望了),还可以计算“所有人都坐错位置的概率”、“最有可能多少人坐错位置”等问题。这个问题就抛给读者思考了(我目前也没有思路)……

飞机座位这道题,我在《大白话概率论》的面试题部分用首尾两个座位的对称性讲了一遍。至于后面这个问题:明明是随机选座,怎么最后会算出自然常数 ee?我在书里专门写了一整节,叫「自然常数 ee 与信封配对问题」。

这一节先拿3封信,把6种装法一一列出来,再用容斥算任意多封信全部装错的概率。有意思的是,每封信装没装对明明会互相影响,可要是先假装它们互不影响,两种算法在信越来越多时,算出来的概率居然都接近 1e\frac1e。书里把这两种算法放在一起对照,也讲了它们和泊松分布的关系。