首先说一个很粗糙的小结论。
我去年做了一个预测年龄的任务。任务的输入是一张人脸图片,输出是年龄。我构造了一个基于深度学习的回归模型。模型训练完成,在测试集的MAE是4(岁)。
我向产品经理汇报:“模型的平均预测误差是4岁”,产品经理似乎不清楚“平均预测误差”的含义,她问我“这意味着所有人的年龄误差都在4岁以内吗?”
我向产品经理解释了“平均预测误差”的含义。产品经理表示仍然更希望知道:模型能够保证多少比例的数据落在x岁误差以内。
某种意义来说,“平均预测误差”是积分的结果,“多少比例的数据落在x岁误差以内”也是积分的结果。这两者是否有一些联系?
把预测年龄减去实际年龄,记作 。先假设这些误差大致服从正态分布, 是均值, 是标准差。
设
则
是先减掉平均偏差,再看误差有多大。如果模型整体没有明显估高或估低,平均偏差就接近 0,这个数也就和 MAE 差不多。
根据常用结论,对于标准正态变量Y,可以计算出
得知
那么
查标准正态分布表可得这个概率约等于 0.575,也就是 57.5%。
这个结论的直观含义是,如果误差大致呈钟形,模型也没有整体估高或估低,那么约 57.5% 的预测,误差的绝对值不超过 MAE。
套在我最初提到的问题:年龄回归模型的MAE是4岁,那么大致可以猜测有 57.5% 的预测,误差在 4 岁以内。
测试集的结果显示,有58%的数据误差落在4岁以内,相差不算大。
这是一个非常粗糙的结论。上面先把误差当成正态分布来算,也假设模型没有明显估高或估低,才把 当成 MAE 来用。实际有多少,还得回到测试集里数。
再补充一个算得上精妙的思想:把数一一配对,相乘再加起来。交叉熵里,可以用排序不等式看怎么配对;图像卷积里,可以看一个卷积核怎么用乘加找边。
首先从排序不等式开始说起,排序不等式指的是:
当 ,
,
有,
其中是的一个置换。
简而言之,就是顺序和≥乱序和≥倒序和。
深度学习中的交叉熵损失函数。 是标签label, 是模型的预测结果。
交叉熵
损失函数越小,意味着预测与真实标签越接近。此时 应该越大。如果预测概率这几个数不变,只交换它们对应的类别,根据排序不等式,对某个类别 ,当 比较大时, 也应该比较大,反之同理。这是符合直觉的,当某一个类的真实label很大时,预测分数 也应该比较高,这才能保证损失函数较小。
举个例子,一张图里明明是猫。模型给「猫」90% 的概率,交叉熵就小;只给 10%,交叉熵就大。
再想一个例子:一枚公平的硬币,正反各一半。你也报五五开,已经猜对了分布,可下一次抛出的是正是反,还是说不准。这是硬币本来就有的不确定性。你要是报成九一开,平均损失就会更大。多出来的这部分,就是 KL 散度。交叉熵就是把这两部分加在一起。
最后说卷积神经网络中的卷积,卷积层的输入是图像,图像的数值一般代表灰度值。比如灰度图的数值取值在[0,255]区间中,数值越高,代表颜色越白。
卷积本质上是提取特征的工具。比如下面的卷积核用来识别一个像素是否具有“左边周围的灰度值与右边周围的灰度值有较大差异”的模式或特征。假如图片的某个区域中,右边的灰度值高于左边的灰度值,算出来的值就会比较大。这个卷积核做的其实是减法:用右边几个像素的亮度减去左边几个像素的亮度。比如左边是黑墙,右边是白墙,差就很大;如果两边差不多亮,算出来就接近零。
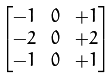
同理,下面的卷积核用来识别一个像素是否具有“上面周围的灰度值与下面周围的灰度值有较大差异”的模式或特征。
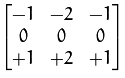
两个卷积核做的是同一件事:一个比左右两边,一个比上下两边。哪里亮度一下子变了,哪里就可能有一条边。