武辰作品索引

知乎作品库

回答 · 4

知乎原文

照镜子为什么是左右颠倒,而不是上下颠倒?

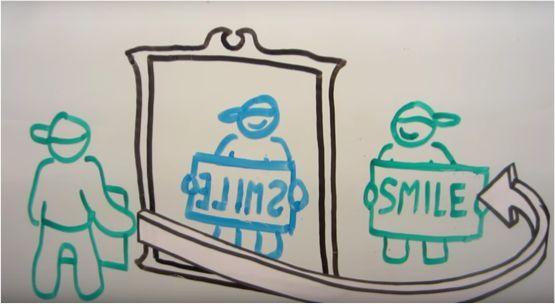
我们先不看镜子,找个朋友来试一下。

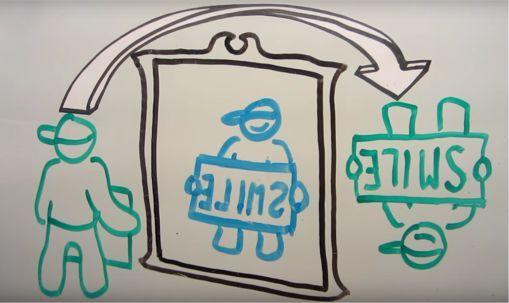
让朋友站在你前面,背对着你,然后举起右手。你从后面看,那只手就在右边。现在让他举着手,原地转过身来面对你。他没换手,举的还是他自己的右手,可从你这边看,那只手已经到了左边。

接下来换成镜子。你举右手,镜子里抬起来的手还在你看到的右边。如果真有个人站在镜子那边,面对着你,他得举左手,才能把手举到那个位置。所以你才会觉得:我举的是右手,他怎么举的是左手?

第一张图画的就是这个比法:你把镜中人当成了一个转过身来面对你的人。

原文配图

那为什么不说上下反了呢?刚才朋友转过身,手换边了,头还是在上面,脚还是在下面。可如果他不转身,而是像做前空翻那样翻半圈呢?他一样能面对你,只不过这回是倒立的,头在下面,脚在上面。拿这个倒立的人跟镜中人比,你反倒会说:怎么上下反了?

原文配图

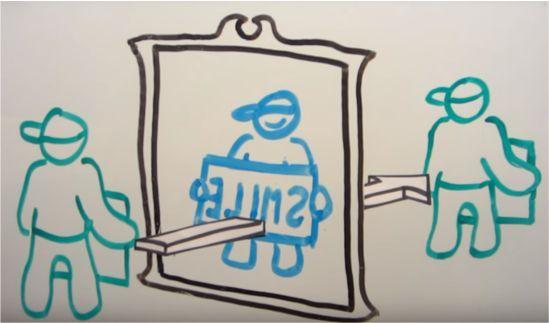
第三张图是另一种比法:不转身,想象自己直接走到镜子另一边。这样一比,左边还是左边,上边还是上边,反过来的是朝向:你朝着镜子里,镜中人朝着镜子外。

原文配图

镜子一直没变,变的是你拿谁跟它比。那镜子到底翻了哪个方向?

伸出食指,朝着镜子指一下。你的手指朝镜子指过去,镜子里的手指却朝你指过来。两根手指一里一外,正好指向相反的方向。

这就是竖着放的镜子实际翻过来的方向:前后。

知乎原文

能举一些“曼德拉效应”的实例吗?

“曼德拉效应”是一个伪科学概念,它集成了 记性差+不好好学习+三人成虎+阴谋论+造谣+伪科学 等标签。这么多人言之凿凿地回答“曼德拉效应”的经历,我称之为“曼德拉效应效应”。

知乎原文

为什么游戏里的都是伪随机,做不出真随机?希望来个简单易懂的解释?

两个原因:做不出、不适合做。

1.做不出:

真正的随机没有办法通过基于当前传统计算机框架的程序做出来。举个简单的例子,抛骰子这件事,看起来是随机的,但是骰子在离开手的时候,骰子几点朝上的结局已经确定了。只要知道离开手的那一刻的位置、动量、风力、地面等情况,就能计算出它几点朝上。

世上大多数的随机系统,只不过是一个无法精确测定输入值的混沌系统所产生的表象。纯计算机程序中的随机都是伪随机,没有办法产生真正的随机。

2.不适合做:

比如抽一张卡片,中奖的概率是0.1,抽卡的概率是独立的、完全随机的。

按直觉来说,抽10次卡片,应该至少要中奖一次,这才符合直觉。

但是连续抽10次卡片都没有中奖的概率是 0.910=0.340.9^{10}=0.34 ,这个概率是不低的。换句话说,如果实现了真正的随机,会有三分之一的玩家质疑它不是真随机。

连续抽20次卡片都没有中奖的概率是 0.920=0.120.9^{20}=0.12 ,也就是说,会有十分之一的人,出现连续20次都没中奖的情况。

所以为了避免玩家质疑,也为了避免打消玩家的积极性,厂商会设置保底。在游戏抽奖方面的随机,不仅不是真随机,甚至连伪随机都算不上(因为有保底机制),应该称之为"伪伪随机"。

知乎原文

能不能给中国象棋加几条趣味规则?

在传统规则中,一颗子被吃了就死了,这样容错率太低,不妨让每颗子多几条命。比如“将”有5条命,“兵”只有1条命。

你一回合我一回合,这样不免有些枯燥。可以弃置一枚“相”,让对方跳过一回合。

当“将”只有一条命的时候,可以获得“英姿”(额外获得一枚“兵”,放在己方的任意位置)、“英魂”(对方获得一枚“兵”,然后弃置4-x枚子,x为将领当前体力)。

兵之间的战争可以致敬火烧连营:当你失去最后一个兵的时候,可以获得一个兵。

“裸衣”:你可以主动跳过一回合,然后你在下一回合的伤害值加一。

知乎原文

甲乙两人比赛,九局五胜制。已知乙最终获胜,押注哪局谁获胜的成功率最高?

群里有人提出这个问题,作为抛砖引玉,我把我的思路分享一下。

我一开始没想到通用的解法。如果将题目中的“九局五胜”改成“三局两胜”,则可以算出押注第一局或者第二局乙获胜的成功率最高。下面假设各局独立,单局胜率不变。算乙最终获胜的概率时,可以先把三局的结果都排好;第三局就算不用打,也不影响谁先拿到两胜。

设乙获胜一局的概率为 pp , 1−p=q1-p=q

P(乙最终获胜) =C32p2q+C33p3=3p2q+p3=C_{3}^{2}p^2q+C_{3}^{3}p^3=3p^2q+p^3

由贝叶斯公式,

P(乙最终获胜|第一局乙胜) =C21pq+C22p2=2pq+p2=C_{2}^{1}pq+C_{2}^{2}p^2=2pq+p^2

P(第一局乙胜|乙最终获胜)=

=P(乙最终获胜|第一局乙胜)pP(乙最终获胜)=\frac{P(乙最终获胜|第一局乙胜)\,p}{P(乙最终获胜)}

=p(2pq+p2)3p2q+p3=1+q1+2q=\frac{p(2pq+p^2)}{3p^2q+p^3}=\frac{1+q}{1+2q}

P(第二局乙胜|乙最终获胜) 同理,结果等于 P(第一局乙胜|乙最终获胜)


P(第三局乙胜|乙最终获胜)这种情况更复杂一些,因为要考虑到第三局是否存在的问题。

P(第三局乙胜|乙最终获胜)=P(第三局乙胜,第三局存在|乙最终获胜)

=P(乙最终获胜|第三局乙胜,第三局存在)P(第三局乙胜,第三局存在)P(乙最终获胜)=\frac{P(乙最终获胜|第三局乙胜,第三局存在)P(第三局乙胜,第三局存在)}{P(乙最终获胜)}

=P(第三局乙胜,第三局存在)P(乙最终获胜)=\frac{P(第三局乙胜,第三局存在)}{P(乙最终获胜)} (1)

=P(第三局存在)P(第三局乙胜)P(乙最终获胜)=\frac{P(第三局存在)P(第三局乙胜)}{P(乙最终获胜)} (2)

=(1−p2−q2)p3p2q+p3=2q1+2q=\frac{(1-p^2-q^2)p}{3p^2q+p^3}=\frac{2q}{1+2q}

显然小于P(第一局乙胜|乙最终获胜)。当且仅当q=1,即乙获胜概率为0时,两者才相等。但是已经知道结果为乙最终获胜的条件下,q必定小于1。

(1)式成立的原因是:第三局的获胜方一定是整个赛局的获胜方。但是如果推广到九局五胜制,那么第6/7/8局的获胜方不一定是整局的获胜方。

(2)式成立的原因是:第三局是否存在,与第三局谁获胜,是相互独立的。


说回九局五胜。评论区的王希提了个好办法:先把九局的结果都排好,哪怕有些局最后没打。已知乙赢了整场,我们就只看乙至少赢五局的那些结果。乙赢的那几局排在前面还是后面,机会是一样的。所以九个位置上,排到乙赢的机会都一样,而且都超过一半:毕竟九个位置里,至少有五个是乙赢。

真打起来,前五局一定会打,第六局以后就不一定了。你押后面的局,就算那局原本排的是乙赢,没打到也算你输。所以押前五局中的任意一局乙赢就行。

知乎原文

如何用数学知识解答「在进行社区大规模核酸检测时,分成几人一组进行混检效率最高」?

假如需要对 nn 个人进行检测,病毒的携带率为 pp 。为了减少工作量,一次性将 kk 个人的唾液样本混合。如果混合样本为阴性,则说明这 kk 个人都没有患病。如果混合样本为阳性,说明这 kk 个人中至少有1个人是阳性,那么接下来对这 kk 个人的唾液分别做检测。这样的方法能够提高检测效率。

接下来求每个人的检测次数 XX 的数学期望 E(X)E(X) 。 如果E(X)E(X) 小于1,说明平均每个人做的检测次数小于1,即混合样本检测的方法能够提高效率。

XX 的取值只有两种可能: 1k\frac{1}{k} 和 1+1k1+\frac{1}{k},具体的分布律是:

P(X=1k)=(1−p)kP(X=\frac{1}{k})=(1-p)^{k}

P(X=1+1k)=1−(1−p)kP(X=1+\frac{1}{k})=1-(1-p)^{k}

可以求得 XX 的数学期望E(X)E(X)

=1k(1−p)k+(1+1k)[1−(1−p)k]=\frac{1}{k}(1-p)^{k}+(1+\frac{1}{k})[1-(1-p)^{k}]

=1−(1−p)k+1k=1-(1-p)^{k}+\frac{1}{k}

下面拿感染率1%举个例子。

于是E(X)=1−0.99k+1kE(X)=1-0.99^{k}+\frac{1}{k} 。

为了节约次数,希望E(X)E(X) 越小越好。11人一组,平均每人摊到约0.19557次检测;10人一组是0.19562次,几乎一样。和每个人单独测相比,检测次数少了大约80%。

我在《大白话概率论》里也讲了这道题:先算100个人按10人一组能少测多少次,以及换个分法还能不能更省。

知乎原文

甲乙两人下围棋,甲胜的概率为a,乙胜的概率为b,a+b=1,比对方多赢两局者获胜,求甲赢的概率?

好问题。拿乒乓球举个例子,打到10平以后,要领先两分才赢下这一局。为什么是两分,而不是一分、三分?可以用概率论解释:当双方实力不过于悬殊时,一分定胜负的偶然性比较大,而领先三分才算赢,平均又要多打一些球。两分是个比较合适的选择。


这道题可以等价地转换为赌徒问题:若甲赢一局,则乙给甲1元;若甲输一局,则甲给乙1元。初始状态下甲和乙都有2元。游戏进行下去,乙破产的概率是多少?

关于这个问题,我在这篇文章给出了初等形式的解答:

赌徒输光定理的初等证明 - 武辰的文章 - 知乎

武辰:赌徒输光定理的初等证明

可以得到乙破产的概率是 a2a2+b2\frac{a^2}{a^2+b^2}


扩展一:游戏结束时,期望进行了多少轮?

记A为甲获胜,B为乙获胜,X为游戏停止。有

E(X|A)P(A)=E(XIA)E(X|A)P(A)=E(XI_{A} )

E(X|B)P(B)=E(XIB)E(X|B)P(B)=E(XI_{B} )

E(X|A)P(A)+E(X|B)P(B)=E(XIA+XIB)=E(X)E(X|A)P(A)+E(X|B)P(B)=E(XI_{A}+XI_{B} )=E(X) (**)

E(X)=P(第一局甲赢,第二局乙赢)(E(X)+2)E(X)= P(第一局甲赢,第二局乙赢)(E(X)+2)

+P(第一局乙赢,第二局甲赢)(E(X)+2)+P(第一局乙赢,第二局甲赢)(E(X)+2)

+P(第一局甲赢,第二局甲赢)×2+P(第一局甲赢,第二局甲赢)\times2

+P(第一局乙赢,第二局乙赢)×2+P(第一局乙赢,第二局乙赢)\times 2

可以求得 E(X)=21−2abE(X)=\frac{2}{1-2ab}

当a=b=0.5时,这个值最大,等于4。这也是符合直觉的——当势均力敌的时候,最难分出胜负。


扩展二:当甲连续赢两局时,判定甲胜;当甲连续输两局时,判定乙胜。求甲获胜的概率。

我想到了以前的一个小发现。

起因是这道题(问题1):

一道机器学习岗位面试题:平均要抛多少次硬币,才能出现连续两次正面向上?

过程不再赘述,我先搬结论:设甲赢一局的概率为a;当甲连续赢两局时,进行的游戏局数的数学期望是 1a+1a2\frac{1}{a}+\frac{1}{a^{2}} 。比如甲赢一局的概率是0.5,那么平均需要进行 10.5+10.52=6\frac{1}{0.5}+\frac{1}{0.5^{2}}=6 局,才能出现甲连赢两局。

将问题展开为问题2:当甲连续赢两局时,判定甲胜;当甲连续输两局时,判定乙胜。求甲获胜的概率。(这个问题和题主的问题类似。区别在于,题主问题的胜利条件是“甲多赢两局”,问题2的胜利条件是“甲连赢两局”。另外,两个条件之间没有充分或必要关系)

问题2的解答:

P(甲胜)P(甲胜)

=P(第一局甲赢,第二局乙赢)P(甲胜|上一局乙赢)=P(第一局甲赢,第二局乙赢)P(甲胜|上一局乙赢)

+P(第一局乙赢,第二局甲赢)P(甲胜|上一局甲赢)+P(第一局乙赢,第二局甲赢)P(甲胜|上一局甲赢)

+P(第一局甲赢,第二局甲赢)×1+P(第一局甲赢,第二局甲赢)\times1

+P(第一局乙赢,第二局乙赢)×0+P(第一局乙赢,第二局乙赢)\times0

=ab×P(甲胜|上一局乙赢)=ab\times P(甲胜|上一局乙赢)

+ab×P(甲胜|上一局甲赢)+ab\times P(甲胜|上一局甲赢)

+aa+aa (*)

又有

P(甲胜|上一局乙赢)=P(甲赢)×P(甲胜|上一局甲赢)+P(乙赢)×0P(甲胜|上一局乙赢)=P(甲赢)\times P(甲胜|上一局甲赢)+P(乙赢)\times 0

P(甲胜|上一局甲赢)=P(甲赢)×1+P(乙赢)×P(甲胜|上一局乙赢)P(甲胜|上一局甲赢)=P(甲赢)\times 1+P(乙赢)\times P(甲胜|上一局乙赢)

得

P(甲胜|上一局乙赢)= a21−ab\frac{a^2}{1-ab}

P(甲胜|上一局甲赢)= a1−ab\frac{a}{1-ab}

带入(*)式,得P(甲胜)= a2+a2b1−ab\frac{a^2+a^2b}{1-ab}

神奇的地方来了,经过简单的变形,P(甲胜)恰好等于 E乙E甲+E乙\frac{E_{乙}}{E_{甲}+E_{乙}} ,

其中 E甲E_{甲} 是上文提到的,甲首次出现连赢两局时的游戏局数的数学期望, E乙E_{乙} 同理。

这个结论挺奇妙。比如甲每局有三分之二的机会赢。只等甲连赢,平均要3.75局;只等乙连赢,平均要12局。两人比谁先连赢,甲赢的概率就是 123.75+12\frac{12}{3.75+12} ,大约76%。


总结:

1.甲比乙先连赢两局的概率是 a2+a2b1−ab\frac{a^2+a^2b}{1-ab}

甲比乙先净赢两局的概率是 a2a2+b2\frac{a^2}{a^2+b^2}

2.如果一方比另一方先净赢2局才算结束游戏,则期望要比赛的局数为 21−2ab\frac{2}{1-2ab}

3. 如果不管乙有没有连赢,一直等到甲第一次连赢两局,平均要打 1a+1a2\frac{1}{a}+\frac{1}{a^{2}} 局。

4.比较结论1和结论2,当甲获胜概率大于一半的时候,选择净赢的赛制对他有利。(如何从直观上解释?)比如当a=0.9时,先连赢两局的概率是0.979,先净赢两局的概率是0.988。当然这两个概率都比一局定胜负更高。

我在《大白话概率论》里还讲了一道相关的题:抛硬币等到连续两次正面,为什么平均要抛6次。有兴趣可以看看。

知乎原文

如果可以从头重新翻译,你会换掉哪些不太好的科学名词译名?

1.“诱导公式”改为“化简公式”,因为“诱导”二字无法体现公式的内涵,而且它不是一个中性词汇。

2.“有理数”改为“比例数”。

3.几何分布和超几何分布也不太好,但我还没想到更好的。

知乎原文

人工智能领域有哪些精妙的数学原理?

首先说一个很粗糙的小结论。

我去年做了一个预测年龄的任务。任务的输入是一张人脸图片,输出是年龄。我构造了一个基于深度学习的回归模型。模型训练完成,在测试集的MAE是4(岁)。

我向产品经理汇报:“模型的平均预测误差是4岁”,产品经理似乎不清楚“平均预测误差”的含义,她问我“这意味着所有人的年龄误差都在4岁以内吗?”

我向产品经理解释了“平均预测误差”的含义。产品经理表示仍然更希望知道:模型能够保证多少比例的数据落在x岁误差以内。

某种意义来说,“平均预测误差”是积分的结果,“多少比例的数据落在x岁误差以内”也是积分的结果。这两者是否有一些联系?

把预测年龄减去实际年龄,记作 XX。先假设这些误差大致服从正态分布, μ\mu 是均值, σ\sigma 是标准差。

设 E(|X−μ|)=wE(|X-\mu|)=w

则 E(|X−μ|σ)=wσE(\frac{|X-\mu|}{\sigma})=\frac{w}{\sigma}

E(|X−μ|)E(|X-\mu|) 是先减掉平均偏差,再看误差有多大。如果模型整体没有明显估高或估低,平均偏差就接近 0,这个数也就和 MAE 差不多。

根据常用结论,对于标准正态变量Y,可以计算出 E(|Y|)=2π≈0.798E(|Y|)=\sqrt{\frac{2}{\pi}}\approx 0.798

得知 wσ=2π≈0.798\frac{w}{\sigma}=\sqrt{\frac{2}{\pi}}\approx 0.798

那么P(|X−μ|≤w)P(|X-\mu|\leq w)

=P(|X−μ|σ≤wσ)=P(\frac{|X-\mu|}{\sigma}\leq \frac{w}{\sigma})

=P(−wσ≤X−μσ≤wσ)=P(-\frac{w}{\sigma} \leq \frac{X-\mu}{\sigma}\leq \frac{w}{\sigma})

≈P(−0.798≤X−μσ≤0.798)\approx P\left(-0.798\leq \frac{X-\mu}{\sigma}\leq 0.798\right)

查标准正态分布表可得这个概率约等于 0.575,也就是 57.5%。

这个结论的直观含义是,如果误差大致呈钟形,模型也没有整体估高或估低,那么约 57.5% 的预测,误差的绝对值不超过 MAE。

套在我最初提到的问题:年龄回归模型的MAE是4岁,那么大致可以猜测有 57.5% 的预测,误差在 4 岁以内。

测试集的结果显示,有58%的数据误差落在4岁以内,相差不算大。

这是一个非常粗糙的结论。上面先把误差当成正态分布来算,也假设模型没有明显估高或估低,才把 E(|X−μ|)E(|X-\mu|) 当成 MAE 来用。实际有多少,还得回到测试集里数。


再补充一个算得上精妙的思想:把数一一配对,相乘再加起来。交叉熵里,可以用排序不等式看怎么配对;图像卷积里,可以看一个卷积核怎么用乘加找边。

首先从排序不等式开始说起,排序不等式指的是:

当 a1≥a2≥……≥ana_{1}\geq a_{2}\geq……\geq a_{n} ,

b1≥b2≥……≥bnb_{1}\geq b_{2}\geq……\geq b_{n} ,

有∑i=1naibi\sum_{i=1}^{n}{a_ib_i}≥∑i=1naibj(i)≥∑i=1naibn+1−i\geq\sum_{i=1}^{n}{a_ib_{j(i)}}\geq\sum_{i=1}^{n}{a_ib_{n+1-i}},

其中j(1),j(2),...j(n)j(1),j(2),...j(n)是1,2,...n1,2,...n的一个置换。

简而言之,就是顺序和≥乱序和≥倒序和。

深度学习中的交叉熵损失函数。 p(xi)p(x_i) 是标签label, q(xi)q(x_i) 是模型的预测结果。

交叉熵H(p,q)=−∑i=1np(xi)log(q(xi))H(p,q)=-\sum_{i=1}^n p(x_i)log(q(x_i))

损失函数越小,意味着预测与真实标签越接近。此时 ∑i=1np(xi)log(q(xi))\sum_{i=1}^n p(x_i)log(q(x_i)) 应该越大。如果预测概率这几个数不变,只交换它们对应的类别,根据排序不等式,对某个类别 ii ,当 p(xi)p(x_i) 比较大时,q(xi)q(x_i) 也应该比较大,反之同理。这是符合直觉的,当某一个类的真实labelp(xi)p(x_i)很大时,预测分数q(xi)q(x_i) 也应该比较高,这才能保证损失函数较小。

举个例子,一张图里明明是猫。模型给「猫」90% 的概率,交叉熵就小;只给 10%,交叉熵就大。

再想一个例子:一枚公平的硬币,正反各一半。你也报五五开,已经猜对了分布,可下一次抛出的是正是反,还是说不准。这是硬币本来就有的不确定性。你要是报成九一开,平均损失就会更大。多出来的这部分,就是 KL 散度。交叉熵就是把这两部分加在一起。

最后说卷积神经网络中的卷积,卷积层的输入是图像,图像的数值一般代表灰度值。比如灰度图的数值取值在[0,255]区间中,数值越高,代表颜色越白。

卷积本质上是提取特征的工具。比如下面的卷积核用来识别一个像素是否具有“左边周围的灰度值与右边周围的灰度值有较大差异”的模式或特征。假如图片的某个区域中,右边的灰度值高于左边的灰度值,算出来的值就会比较大。这个卷积核做的其实是减法:用右边几个像素的亮度减去左边几个像素的亮度。比如左边是黑墙,右边是白墙,差就很大;如果两边差不多亮,算出来就接近零。
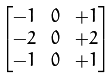
原文配图

同理,下面的卷积核用来识别一个像素是否具有“上面周围的灰度值与下面周围的灰度值有较大差异”的模式或特征。
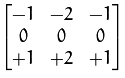
原文配图

两个卷积核做的是同一件事:一个比左右两边,一个比上下两边。哪里亮度一下子变了,哪里就可能有一条边。
知乎原文

能不能出一道很难的数学题,答案是 504,当宿舍门牌用?

王力每天都要去按摩店。按摩店有9个技师,他每天晚上挑3个技师出来,一个只按摩脚,一个只按摩背,一个只按摩头。至少需要多少天,才能穷尽所有的组合?

答:9*8*7=504。