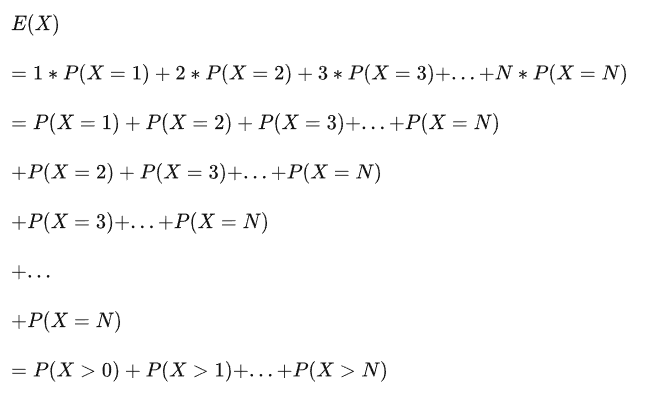武辰作品索引

知乎作品库

回答 · 3

知乎原文

投掷两个相同的骰子(比如说六面骰),取较高值,他的结果的数学期望是多少?

记得小学的时候和女同桌抢零食吃,我和同桌约定抛骰子来决定。同桌抛得比我小,闹着要再抛一次,结果仍然比我小。我指责同桌耍赖,同桌说“哪里耍赖了?结果不是一样的吗?”我当时心里隐隐约约感觉不对劲。当然,零食肯定是归我的。

后来学了概率论,我终于可以名正言顺地指责同桌耍赖了……

先说结论:

(1)假如从1 到 n 选择一个数,则数学期望是 n+12\frac{n+1}{2}

(2)假如从1 到 n 选择两个数(不重复),则较大数的数学期望是 23(n+1)\frac{2}{3}(n+1)

(3)假如从1 到 n 选择两个数(可重复),则较大数的数学期望是 (23−16n)(n+1)(\frac{2}{3}-\frac{1}{6n})(n+1)

下面提供四种解法(准确说是五种)。

【思路一】暴力枚举

这个问题其实不难,一共有36种情况,一个一个列举一遍,稍加计算,不出几分钟就可以得到答案。但是暴力枚举法没有可扩展性。

【思路二】求分布律

抛两个骰子,记第一个骰子的结果是 X1X_1 ,第二个骰子的结果是 X2X_2 ,记 Xmax=max(X1,X2)X_{max}=max(X_1,X_2)

现在需要求 XmaxX_{max} 的数学期望。那么思路自然是先求出 XmaxX_{max} 的分布律。

下面这个式子可以求出XmaxX_{max} 的分布律。

P(Xmax=k)=P(Xmax≤k)−P(Xmax≤k−1)P(X_{max}=k)=P(X_{max}\leq k)-P(X_{max}\leq k-1)

P(Xmax≤k)P(X_{max}\leq k) 是什么?是两次骰子的结果都小于等于k的概率,等于 P(X1≤k)⋅P(X2≤k)=(k6)2P(X_{1}\leq k)\cdot P(X_{2}\leq k)=(\frac{k}{6})^2

因此 P(Xmax=k)=(k6)2−(k−16)2P(X_{max}=k)=(\frac{k}{6})^2-(\frac{k-1}{6})^2

那么可以算出 $E(X_{max})=\sum_{k=1}^{6}{kP(X_{max}=k)}=\\\sum_{k=1}^{6}k[(\frac{k}{6})^2-(\frac{k-1}{6})^2]=\frac{161}{36}$

这个结论可以一般化为:

假如从1 到 n 选择两个数(可重复),则较大数的数学期望是 (23−16n)(n+1)(\frac{2}{3}-\frac{1}{6n})(n+1)

【思路三】另一种求数学期望的公式

对于离散型随机变量,数学期望的公式不仅有:

E(X)=∑k=1nkP(X=k)E(X)=\sum_{k=1}^{n}{kP(X=k)}

也有:

E(X)=∑k=1nP(X≥k)E(X)=\sum_{k=1}^{n}{P(X\geq k)}

这个公式怎么来的?我们换个办法数点数。

假如两个骰子中较大的点数是4,我们依次问:

有没有达到1点?有,记1分。

有没有达到2点?有,再记1分。

有没有达到3点?有,再记1分。

有没有达到4点?有,再记1分。

有没有达到5点、6点?没有,不记分。

最后加起来,正好是4分。如果最大点数是5,就能记5分;是6,就能记6分。也就是说,这种记分办法,和直接看最大点数,结果完全一样。

那平均点数怎么算?我们可以把这六项分别算,再加起来。

比如“有没有达到4点”这一项,有3/4的机会得1分,剩下1/4的时候得0分,所以这一项平均得3/4分。其他五项也是同样的道理。

因此,把“至少1点”“至少2点”……“至少6点”的概率加起来,就是我们要算的平均点数。

刚刚已经求得 P(Xmax≤k)=(k6)2P(X_{max}\leq k)=(\frac{k}{6})^2

因此 $E(X_{max})=\sum_{k=1}^{n}{P(X_{max}\geq k)}\\=\sum_{k=1}^{n}{(1-P(X\leq k-1))}\\=\sum_{k=1}^{n}{(1-(\frac{k-1}{6})^2)}=\frac{161}{36}$

【思路四】转换成不重复取值的情况

借鉴 @timo 的思路。抛两次骰子,分两种情况。如果两次骰子的点数一样,则相当于抛一次骰子的数学期望,显然是3.5。如果两次骰子的点数不一样,则算出对应的概率,答案是:

16×72+56×143=16136\frac{1}{6}×\frac{7}{2}+\frac{5}{6}×\frac{14}{3}=\frac{161}{36}

这里的 143\frac{14}{3} 是怎么得来的呢?

有一个一般性的结论:如果从1 到 n 选择两个不同的数,更大那个数的数学期望是 (1+n)*2/3。

这个结论是怎么来的?

我提供两种思路。

数学归纳法

第一种思路自然是更容易想到的数学归纳法。毕竟通项公式已经给出来了,用数学归纳法是最自然的解法。

当n=2或者3时,可以用简单的列举来验证 (1+n)*2/3的正确性。

当n=n时,假设命题成立。

当n=n+1时,即如果从1 到 n +1选择两个不同的数,此时分两种情况:

第一种情况,两个数字都小于等于n,这种情况的概率是 Cn2Cn+12=n−1n+1\frac{C_{n}^{2}}{C_{n+1}^{2}}=\frac{n-1}{n+1} ,在这种情况下,较大值的数学期望就等于(1+n)*2/3

第二种情况,有数字取到了n+1,这种情况的概率是 2n+1\frac{2}{n+1} ,在这种情况下,较大值的数学期望就等于n+1

于是如果从1 到 n +1选择两个不同的数,较大值的数学期望是:

n−1n+1×23(n+1)+2n+1(n+1)=23(n+2) \frac{n-1}{n+1}\times\frac{2}{3}(n+1)+\frac{2}{n+1}(n+1)=\frac{2}{3}(n+2)

考察每一个数

除了数学归纳法,还有一种思路是考察每一个数。从1 到 n 选择两个不同的数,对于每一个数k,它可能有两种情况:

(1)作为更大的数字,当其他数字是1到k-1。

(2)作为较小的数字,当其他数字是k+1到n。

当是第一种情况的时候,它就是较大的数。这种情况有k种。

当是第二种情况的时候,它就是较小的数。这种情况有n-k种。

因此考察k,它作为最较值,对总的数学期望的贡献是 k(k−1)k(k-1) ;作为较小值,另一个数对总的数学期望的贡献是 ∑j=k+1nj\sum_{j=k+1}^{n}{j}

加起来,可得,对于某个k,它对总的数学期望的贡献是

$k(k-1)+\sum_{j=k+1}^{n}{j}\\=k^2-k+\frac{n^2+n}{2}-\frac{k^2+k}{2}\\=\frac{k^2-3k+n^2+n}{2}$

对每个k,都加起来,可得:

∑k=1nk2−3k+n2+n2=23n(n−1)(n+1)\sum_{k=1}^{n}{\frac{k^2-3k+n^2+n}{2}}=\frac{2}{3}n(n-1)(n+1)

注意,从1 到 n 选择两个不同的数,一共有 n(n−1)2\frac{n(n-1)}{2} 种不同的选法。上面在计算的时候并未考虑到重复,比如(3,4)和(4,3)的情况都计算在总和里,因此需要将上面的求和除以 n(n−1)n(n-1) ,最终得到数学期望是 23(n+1)\frac{2}{3}(n+1)

总结

(1)假如从1 到 n 选择一个数,则数学期望是 n+12\frac{n+1}{2}

(2)假如从1 到 n 选择两个数(不重复),则较大数的数学期望是 23(n+1)\frac{2}{3}(n+1)

(3)假如从1 到 n 选择两个数(可重复),则较大数的数学期望是 (23−16n)(n+1)(\frac{2}{3}-\frac{1}{6n})(n+1)

从直观来看,(2)和(3)大于(1)是显而易见的,毕竟“多给了一次机会”,相当于“耍赖”。

(2)比(3)更大,是因为(3)蕴含了两个数相等的情况。两个数相等的情况退化成了情况(1),拉了后腿。


上面讲的都是从1到n这些整数里选数。如果换成在0到1之间均匀随机选两个数,较大的那个数就服从Beta(2,1)分布,数学期望是2/3,和前面的离散情况类似。

知乎原文

随机生成5位数,得到11111和得到54176的概率相同,为什么遇到前者时我们会觉得随机算法有问题?

11111和54176出现的概率一样,

但是“看起来像设计过的数字”和“看起来不像设计过的数字”出现的概率不一样。

前者指的是11111/12345/87654/13579这种看起来有规律的数字。

在1到100,000之间,看起来有规律的数字,显然少于看起来没有规律的数字。所以当你看到看起来有规律的数字出现的时候,你会觉得不可思议,因为在你眼中,小概率事件发生了。

再举一些类似的例子。

把数字换成抛硬币

假设抛十次硬币,得到下面两个序列:

A:正正正反正反反反正正

B:正正正正正反反反反反

你觉得哪个更像随机抛出来的?A看起来杂乱,B却整整齐齐:前五次全是正面,后五次全是反面,很容易让人觉得是安排好的。

但是,如果硬币公平,每次抛掷又相互独立,这两个特定序列出现的概率都是1/1024。差别在于,我们一眼就认出了B的模式,却不会同样在意A每一位的顺序。这和看到11111时的感觉是一样的。

硬币是没有记忆的。它不知道上一把是正面,不需要在这一把出个反面来“找平”。所谓的随机,就是它想怎么聚就怎么聚,它才不在乎你看得顺不顺眼。

再看看火星上的“人脸”

同样的事情也会发生在看图片的时候。看到火星地表的照片里,有块岩石像人脸,有片地形像金字塔,我们很容易往外星文明的方向想。

但是,你小时候躺在草地上看云彩,也会一会儿觉得它像马,一会儿觉得它像城堡。云彩并不是照着马或者城堡的样子做出来的,是我们的大脑在认图形。

火星的地形也可以这样看:自然过程形成了大量复杂的形状,我们从中认出了熟悉的那一类——人脸、动物、建筑。认出这些形状之后,它们就显得特别,其余那些不像什么的岩石,反而很容易被我们忽略。

知乎原文

能否直观解释为什么一个随机变量的分布函数服从均匀分布(不要求证明)?

首先要直观理解“均匀分布”,均匀分布指的是每种可能结果的取值概率都是相同的。比如抛一枚正常的骰子的结果是{1,2,3,4,5,6},每种可能都是相同的,这是(离散)均匀分布。

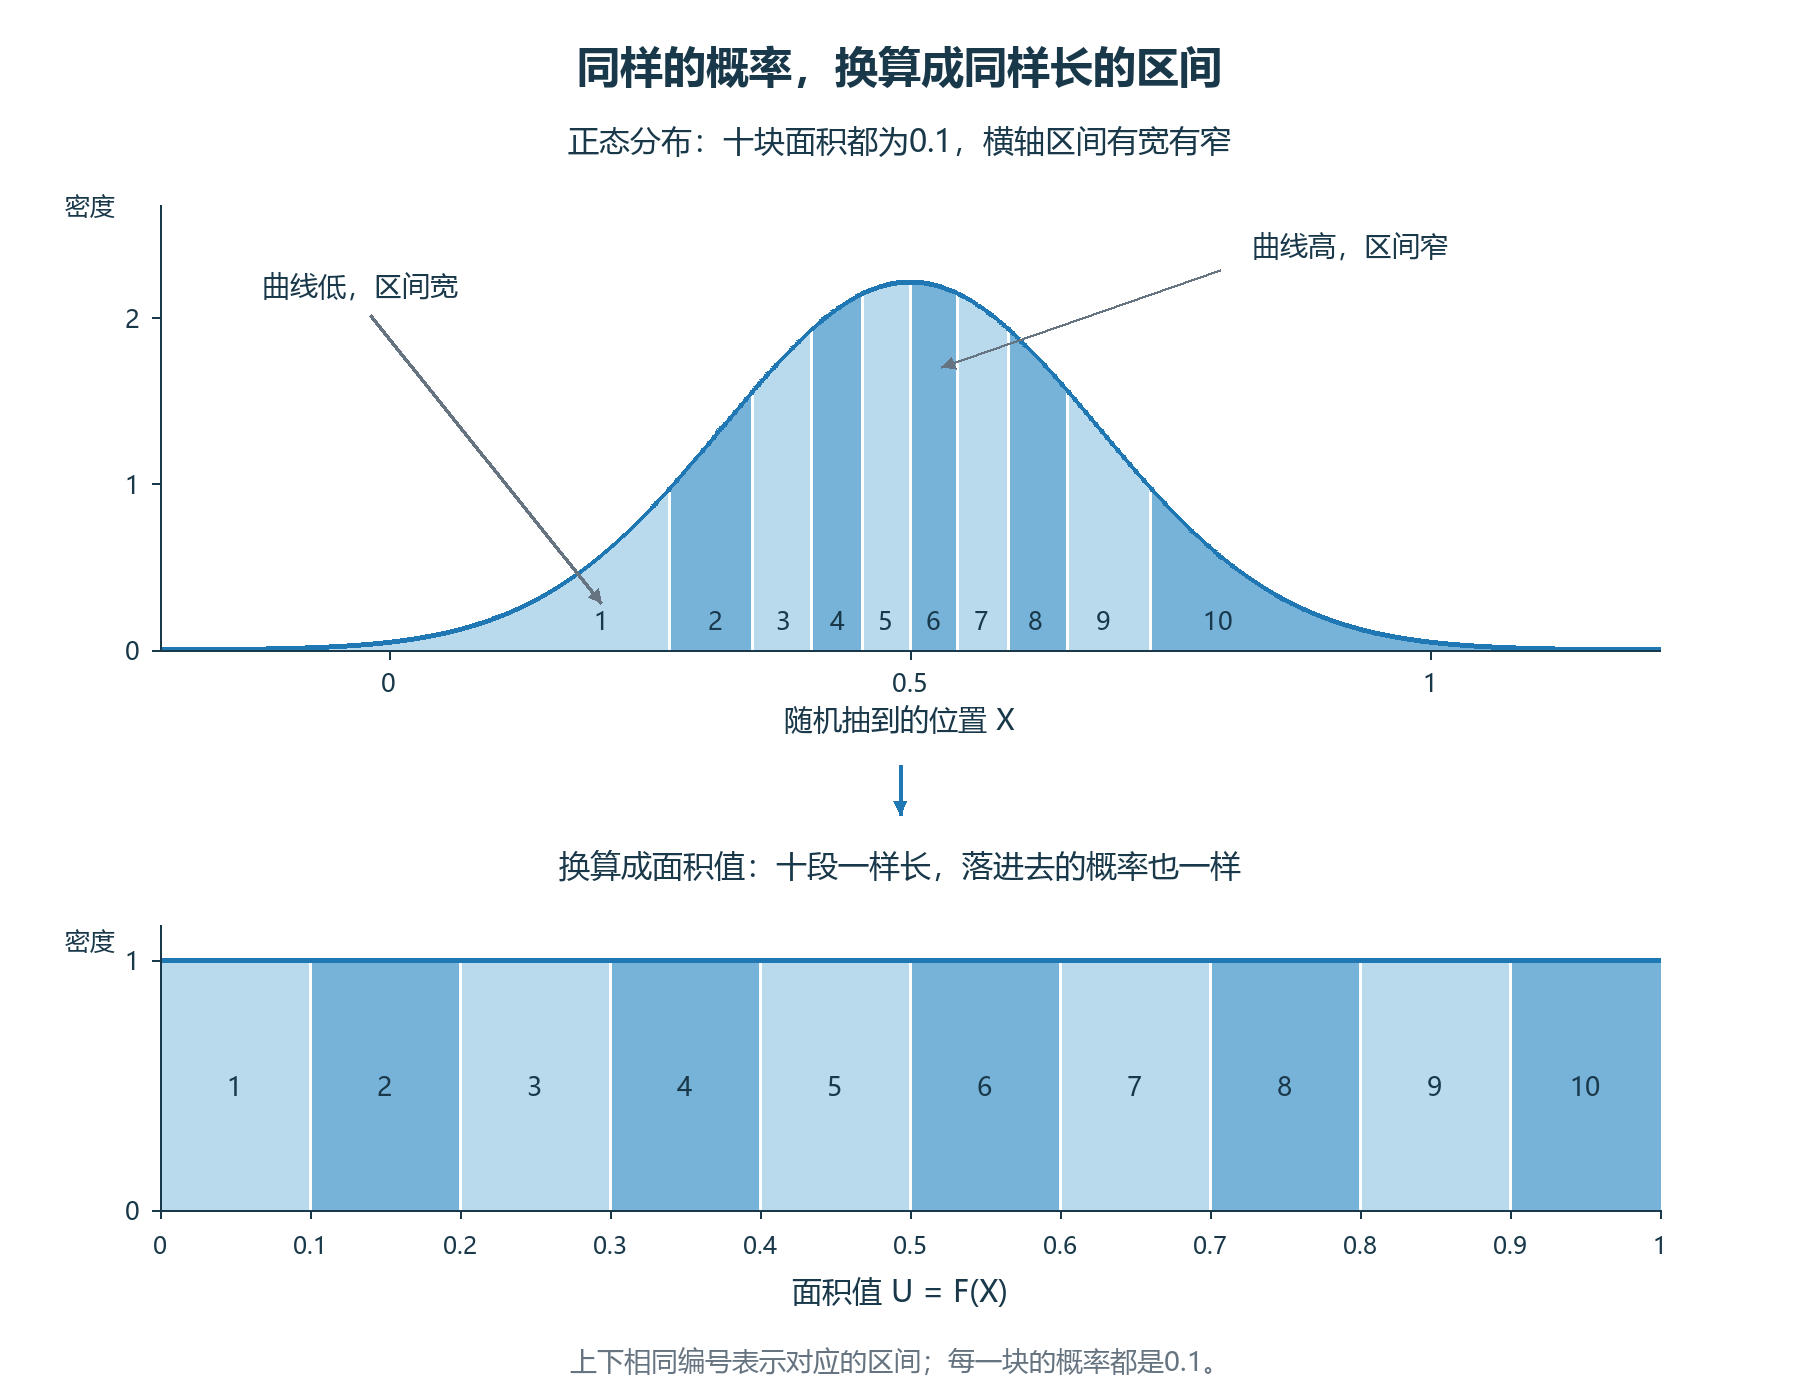
下面讨论连续型随机变量。这里说的均匀分布,是指在0到1之间,取同样长的区间,落进去的概率都相同。然后直观理解分布函数:F(a)就是概率密度曲线下方,从最左边一直累积到a的面积。

比如一个正态分布,均值为0.5。首先正态分布不是均匀分布,从正态分布中随机取一个值,该值在0.5附近的概率,肯定高于在0.1附近的概率(如果是均匀分布,那么0.5附近的概率,等于在0.1附近的概率)。

但是,如果考虑概率密度曲线下方的面积,从正态分布中随机取一个值a,然后画概率密度函数在(-∞,a)区域内与x轴围成的面积,你会发现面积在0.1附近的概率,等于在0.2附近的概率,等于在0.3附近的概率……

你可能会问,a取值在0.5附近的概率明显更高,那么对应的面积值(或者附近)的出现频率也应该更高才对。看下面这张图,虽然a在0.5附近的取值概率最高,但是对应的F(x)的变化率也是最快的,相当于把中间密集的取值拉开了,面积值就在0到1之间均匀分布了。

原文配图
从正态分布到均匀分布:上下相同编号的区间,概率都为0.1。

1.为什么恰好是均匀分布?

我们把概率密度曲线下方的总面积,从左往右切成十份,每份面积都是0.1。注意,是面积一样,不是横轴上的宽度一样。

在曲线比较高的地方,窄窄一段就能凑够0.1;在曲线比较低的地方,就得取宽一些。但是,随机抽到的a落进每一份里的概率,都是0.1,因为面积就是概率。

再看这些a对应的F(a)。a落在第一份里,F(a)就在0到0.1之间;落在第二份里,F(a)就在0.1到0.2之间……落在最后一份里,F(a)就在0.9到1之间。

你看,F(a)落进这十段区间的概率都一样,而这十段区间的长度也一样。把十份换成一百份、一千份,道理还是一样。

2.把这个想法写成公式

前面的面积解释已经回答了“为什么”。如果你还想看公式,我们再算一遍。

沿用前面正态分布的例子,把随机抽到的值写成X。每抽到一个X,就算一次F(X),得到一个0到1之间的面积值。我们把这个新的随机变量叫作U,也就是:

U=F(X)U=F(X)

上面正态分布的分布函数F一直递增,X越大,左边累积的面积也越大。所以,知道面积以后,也能反过来找到对应的位置。这个反过来找位置的函数,就记作F的反函数。

比如,F(a)=0.3,表示a左边的面积是0.3。反过来,F⁻¹(0.3)就是在问:左边面积为0.3的那个位置a,到底在哪里?

现在取0到1之间任意一个数u。F(X)不超过u,就相当于X还没有越过F⁻¹(u)这个位置。因此:

P(U≤u)=P(F(X)≤u)=P(X≤F−1(u))P(U\le u)=P(F(X)\le u)=P(X\le F^{-1}(u))

最后这个概率怎么算?F本来就是用来算“X不超过某个位置”的概率的,所以,把F⁻¹(u)这个位置代进去就行:

P(X≤F−1(u))=F(F−1(u))=uP(X\le F^{-1}(u))=F(F^{-1}(u))=u

得到的结果是:U不超过0.1的概率是0.1,不超过0.3的概率是0.3,不超过0.8的概率是0.8……这正是0到1之间均匀分布的特点。

3.反过来,能不能从均匀分布生成其他分布?

既然把X代入F,可以得到均匀分布的随机数,那我们能不能先生成均匀分布的随机数,再把它变成自己想要的分布?

可以。先生成一个0到1之间均匀分布的随机数U,再把它代入目标分布的反函数:

X=F−1(U)X=F^{-1}(U)

这就是逆变换采样法。先随机选一个面积值,再去目标分布的曲线上,找到这个面积对应的位置。

举一个指数分布的例子。参数为λ的指数分布,它的分布函数是:

F(x)=1−e−λx,x≥0,λ>0F(x)=1-e^{-\lambda x},\qquad x\ge 0,\ \lambda>0

如果我们希望左边累积的面积等于刚刚生成的U,就在上面的公式里令F(X)=U,再把X解出来:

X=−1λln⁡(1−U)X=-\frac{1}{\lambda}\ln(1-U)

于是,每生成一个均匀随机数U,就按这个公式算出一个X。这样得到的X,就服从参数为λ的指数分布。

举个具体的数,取λ=1,如果生成的U是0.5,那么算出的X约为0.693。换一个U,就得到另一个X。不断重复这个过程,就能生成一批指数分布的随机数。

前面是把随机抽到的位置换算成面积,得到均匀分布;这里是先随机选一个面积,再反过来找位置,得到想要的分布。这两个过程就这样接起来了。

知乎原文

y=int(x)如何设计一个深度神经网络逼近?

有几个回答的思路很巧妙。我按照他们的思路写代码做了一些实验,发现他们的思路是可行的。我把代码贴出来,和大家探讨。

首先按照 @dawnbreaker 的思路实现代码(y=int(x)如何设计一个深度神经网络逼近? - dawnbreaker的回答 - 知乎 y=int(x)如何设计一个深度神经网络逼近?)

情况一:如果事先不知道目标函数,即没有先验信息或归纳偏置,那么直接定义万能的全连接层即可。以下是答主的原代码:

import torch
import torch.nn as nn
import torch.optim as optim
import random

class MLP(nn.Module):
    def __init__(self, layer_sizes):
        super(MLP, self).__init__()
        self.layers = nn.ModuleList()
        for i in range(len(layer_sizes)-1):
            self.layers.append(nn.Linear(layer_sizes[i], layer_sizes[i+1]))
            self.layers.append(nn.ReLU())
                
    def forward(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

# model = MLP(layer_sizes=[1, 16, 64, 256, 64, 16, 1]).cuda()
model = MLP(layer_sizes=[1, 16, 64, 256, 64, 16, 1]).cuda()
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

epochs = 5000
batch_size = 3200

import numpy as np

for epoch in range(epochs):
    inputs = torch.rand(batch_size, 1).cuda() * 10
    targets = torch.floor(inputs)+random.random()
    # inputs = np.linspace(0,10,10000)
    # inputs = torch.FloatTensor(inputs).view(-1,1).cuda()
    # targets = torch.floor(inputs)
    # Forward pass
    outputs = model(inputs)
    loss = criterion(outputs, targets)
   
    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    
    if (epoch+1) % 1000 == 0:
        print(f'Epoch [{epoch+1}/{epochs}], Loss: {loss.item():.4f}')


model = model.cpu()
num_samples = 500

test_inputs = torch.rand(num_samples, 1) * 10
with torch.no_grad():
    predicted_outputs = model(test_inputs)

import matplotlib.pyplot as plt
plt.figure()
plt.gca().set_aspect('equal')
plt.scatter(test_inputs.numpy(), predicted_outputs.numpy(), s=1)
# plt.scatter(test_inputs.numpy(), test_inputs.floor().numpy(), s=1)
plt.xlabel('input')
plt.ylabel('pred')
plt.savefig('results.png')

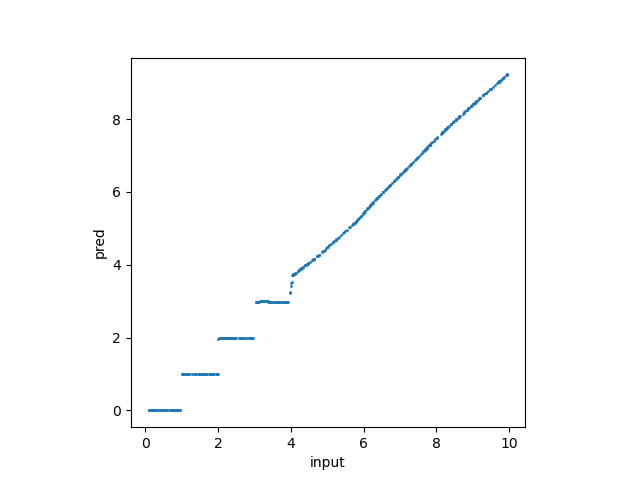
实际跑了几遍以上的代码,出现几个现象:

(1)做了多次实验,有大概一半的实验,出现prediction输出全是0的情况(对应地,loss一直维持在很高的某个数值),且无法随着训练epoch的增加而改善。暂时没有想到合理的解释。( @鄢振宇-北京大学 在评论区指出可能是哑结点的问题,即dead neuron。如果把ReLU换成LeakyReLU,该问题得到解决。为什么在这个任务下,dead neuron的出现频率如此高,且几乎无法被重新激活?)

(2)随着epoch增加,神经网络从数值较小的数据开始拟合,一直拟合到数值较大的数据( @一只吹风的笔 在其他回答的评论区提到了该现象)

原文配图
这是5000epoch的预测结果
原文配图
这是10000epoch的预测结果

如果epoch继续增加,可能会更准确。

(3)如果把数据标签增加噪声,

原代码是:

targets = torch.floor(inputs)

改成这样:

targets = torch.floor(inputs)+random.random()

出现“prediction输出全是0”的现象明显少了很多,但是训练效果更差一些,同样的epoch的条件下只能拟合(0,3)区域的数值。

原文配图

情况二:事先知道目标函数(不是损失函数,这里的目标函数,指的是神经网络需要拟合的函数)

答主给出了如下公式表达:
int(x)=argmini((x−θi−b)2)\text{int}(x)=\text{argmin}_i((x-\theta_i-b)^2)
其中 θ∈R10\theta\in R^{10} 是个长度为10的标量序列,在最优解中, θi=i\theta_i=i ;
bb 是bias,在最优解中 b=0.5b=0.5 。

首先做一个小指正,b的最优解应该是0.49999,否则会出现int(2)=1

首先写一段代码验证该公式的是否能正确拟合int(x):

import numpy as np
def int_f(x):
    theta = np.arange(10)
    f = np.argmin((x-theta-0.499)**2)
    return f
a = 2.01
print(int_f(a))

但是该公式包含argmin操作,不可导。答主提出了一个魔改的attention,我把它简化成加了temperature的softmax(softmax先给各个类别算出概率,而不是直接挑出一个类别,这一步是连续可导的,方便后面训练网络。)。写一段代码验证加了temperature的softmax是否能正确拟合int(x):

import numpy as np
def soft(x):
    theta = np.arange(10)
    logits = -(x-theta-0.499)**2
    logits = torch.FloatTensor(logits).view(1,-1)
    print(logits)
    f = torch.softmax(logits/0.005, dim=-1)
    return torch.argmax(f)
a = 1.99
print(soft(a))

temperature越小,softmax给出的概率就越集中在得分最高的那个类别上。

知道了目标函数后,开始动手实现网络。以 f(x)=argmini(x−θi)2f(x)=argmin_i(x-\theta_i)^2 为目标函数来设计神经网络,其中参数 θ\theta 最优解是[0.5,1.5,2.5,3.5,4.5,5.5,6.5,7.5,8.5,9.5]

这个形式和该答主给的形式等价,但是更简洁。

很快可以训练出比较好的结果,代码如下:

import torch
import torch.nn as nn
import torch.optim as optim
import random
import torch.nn.functional as F

class Test(nn.Module):
    def __init__(self):
        super(Test, self).__init__()
        self.params = nn.ParameterList([nn.Parameter(torch.randn(1,10))])
        # self.custom = [0.5,1.5,2.5,3.5,4.5,5.5,6.5,7.5,8.5,9.5]
        # self.params = nn.ParameterList([nn.Parameter(torch.FloatTensor(self.custom))])
        # self.params2 = nn.ParameterDict({'left':nn.Parameter(torch.FloatTensor(self.custom))})
    def forward(self, x):
        return (x-self.params[0])**2
        # return (x-self.params2['left'])**2
    
 
class My_loss(nn.Module):
    def __init__(self):
        super().__init__()
 
    def forward(self, x, y):
        # x.shape=torch.Size([3200, 10]) 模型输出
        # y.shape=torch.Size([3200, 10]) label
        T = 1
        f1 = torch.softmax(-x / T, dim=-1)  #torch.Size([3200, 10])
        f2 = torch.log(f1) #torch.Size([3200, 10])
        # print(f,y)
        return torch.mean(-1*f2*y)
    
criterion = My_loss()

a = torch.FloatTensor([1,2,3,4,5,6,7,8,9,10]).view(1,-1)
b = torch.tensor([5]).view(1,-1)
criterion(a,b)

model = Test().cuda()
# 修改参数
# model.params2=nn.ParameterDict({'left':nn.Parameter(torch.ones(10,))})
optimizer = optim.Adam(model.parameters(), lr=0.01)

epochs = 10000
batch_size = 3200


for epoch in range(epochs):
    inputs = torch.rand(batch_size, 1).cuda() * 10 #3200*1
    targets = torch.floor(inputs).long() #3200*1
    targets = F.one_hot(targets,num_classes=10).view(-1,10)
    # inputs = np.linspace(0,10,10000)
    # inputs = torch.FloatTensor(inputs).view(-1,1).cuda()
    # targets = torch.floor(inputs)
    # Forward pass
    outputs = model(inputs) #3200*10
    loss = criterion(outputs, targets)
   
    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    
    if (epoch+1) % 1000 == 0:
        print(f'Epoch [{epoch+1}/{epochs}], Loss: {loss.item():.4f}')


model = model.cpu()
num_samples = 500
print(list(model.named_parameters()))

test_inputs = torch.rand(num_samples, 1) * 10
with torch.no_grad():
    predicted_outputs = model(test_inputs)
    predicted_outputs = torch.argmin(predicted_outputs,dim=-1)

import matplotlib.pyplot as plt
plt.figure()
plt.gca().set_aspect('equal')
plt.scatter(test_inputs.numpy(), predicted_outputs.numpy(), s=1)
# plt.scatter(test_inputs.numpy(), test_inputs.floor().numpy(), s=1)
plt.xlabel('input')
plt.ylabel('pred')
plt.savefig('results.png')
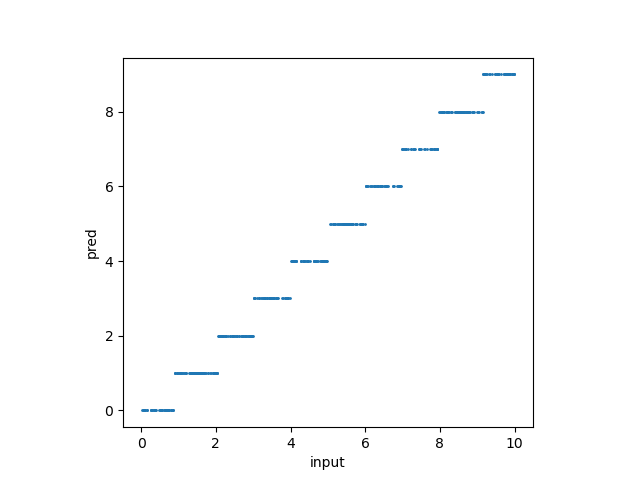
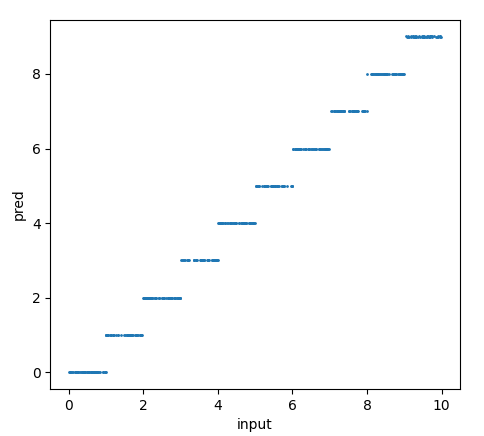
原文配图

有两个细节:

1.如果不训练,而是直接将最优参数指定给网络,那么predict出来的结果是完全正确的。

2.我原以为temperature应该要比较低,才能达到比较好的效果,但是直接用softmax,也能达到很好的效果。训练出来的参数为:

[0.1337, 1.5942, 2.5365, 3.4878, 4.4940, 5.5161, 6.5073, 7.4499, 8.4124, 9.8821]

和最优解相近。


接下来是 @Welt 的思路(y=int(x)如何设计一个深度神经网络逼近? - Welt的回答 - 知乎 y=int(x)如何设计一个深度神经网络逼近?)

答主首先提出了示性函数:$\mathbb{I}(x)=\begin{cases}1&\text{if }x\geq 0,\\ 0&\text{otherwise}. \end{cases}\\$该函数不可导,于是答主使用ReLU来近似。我没有完全弄明白(哪位朋友可以帮忙实现下?)(20231109更新:我在回答的最后面更新了如何用relu来做示性函数近似的代码)。我想到还使用sigmoid函数来近似示性函数。

如果单纯使用sigmoid来近似,误差会很大,因为只有当x的绝对值比较大的时候,sigmoid(x)才接近1或者0。如果给sigmoid函数的输入做高次幂运算,比如sigmoid(x^9),会不会更接近示性函数?

目标函数(注意,不是损失函数)是 f(x)=∑i=110sigmoid((x−θi)9)f(x)=\sum_{i=1}^{10}{sigmoid((x-\theta_i)^9)} ,其中参数 θ\theta 最优解是[1,2,3,4,5,6,7,8,9,10]

import torch
import torch.nn as nn
import torch.optim as optim
import random
import torch.nn.functional as F

class Test(nn.Module):
    def __init__(self):
        super(Test, self).__init__()
        self.params = nn.ParameterList([nn.Parameter(torch.randn(1,10))])
        # self.custom = [1,2,3,4,5,6,7,8,9,10]
        # self.params = nn.ParameterList([nn.Parameter(torch.FloatTensor(self.custom))])

    def forward(self, x):
        x = F.sigmoid((x-self.params[0])**9)
        return torch.sum(x,dim=-1,keepdim=True)
    
 
model = Test().cuda()
optimizer = optim.Adam(model.parameters(), lr=0.01)

epochs = 10000
batch_size = 3200


for epoch in range(epochs):
    inputs = torch.rand(batch_size, 1).cuda() * 10 #3200*1
    targets = torch.floor(inputs) #3200*1

    outputs = model(inputs) #3200*1
    criterion = nn.MSELoss()
    loss = criterion(outputs, targets)
   
    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    
    if (epoch+1) % 1000 == 0:
        print(f'Epoch [{epoch+1}/{epochs}], Loss: {loss.item():.4f}')


model = model.cpu()
num_samples = 500
print(list(model.named_parameters()))

test_inputs = torch.rand(num_samples, 1) * 10
with torch.no_grad():
    predicted_outputs = model(test_inputs)

import matplotlib.pyplot as plt
plt.figure()
plt.gca().set_aspect('equal')
plt.scatter(test_inputs.numpy(), predicted_outputs.numpy(), s=1)
plt.xlabel('input')
plt.ylabel('pred')
plt.savefig('results.png')

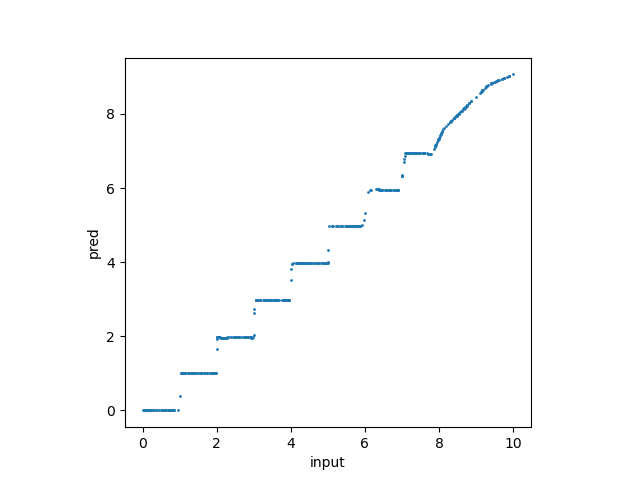
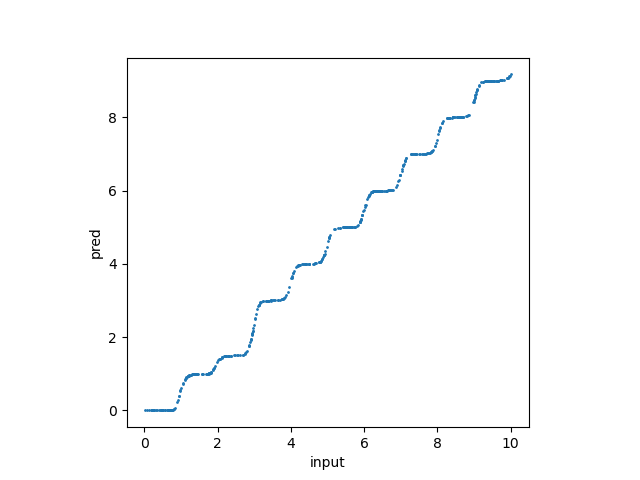
预测结果:

原文配图

看起来勉勉强强,如果幂再高一些,可能会更准确。

打印出来的训练后的模型参数是:

[ 1.9830, 3.9483, 9.0361, 5.0168, 6.9878, 2.9550, 10.0191, 6.0213, 7.9931, 1.9831]

(注意,顺序不影响)和最优参数[1,2,3,4,5,6,7,8,9,10]大体相近,不过有两个参数都在2附近,少了一个接近1的参数。


问题讨论:

用sigmoid(x^9)去近似示性函数合理吗?如果x的绝对值小于1,经过9次方后,会更加接近0,此时经过sigmoid后的结果会更加接近0.5,离示性函数的误差更大。

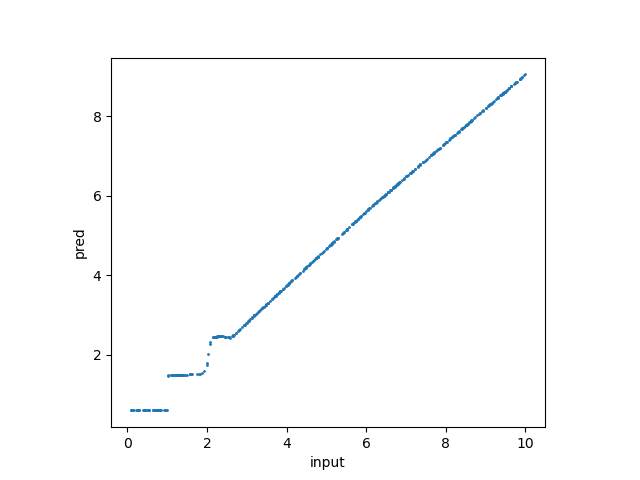
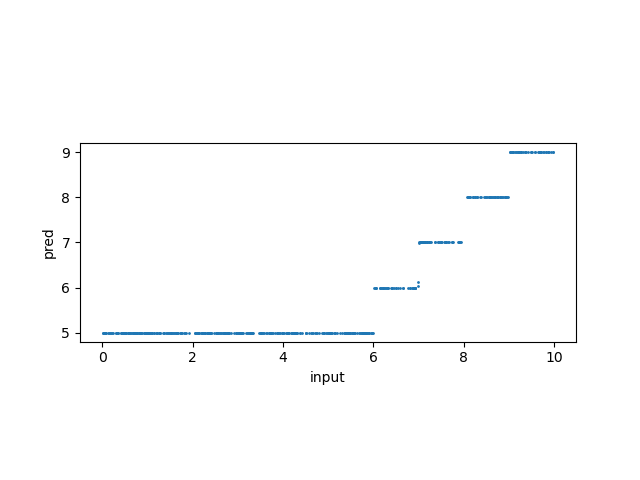
如果换成sigmoid(x*999),理论上应该更接近示性函数。但是实际训练喜忧参半:

原文配图

首先,它的确更接近阶梯函数。但是在(0,6)范围表现不好,我暂时没有找出原因。读者可以运行代码,探究问题出在哪里。


20231109更新:

答主用该连续的分段函数来近似示性函数:

$\mathbb{I}'(x,\epsilon)=\begin{cases} 0&\text{if }x<-\frac\epsilon2,\\ \frac x\epsilon+\frac12&\text{if }-\frac\epsilon2\leq x<\frac\epsilon2,\\ 1&\text{otherwise}. \end{cases}\\$

注意,epsilon要比较小,这个近似才有意义。

那么int(x)可以用该函数来表示: $f'(x)=\sum_{i=1}^{10}\mathbb{I}'(x-i,\epsilon).\\$ 答主在评论区给出了numpy实现:

import numpy as np

epsilon = 1e-7
W1 = np.ones((1, 20)) / epsilon  #(1, 20)
b1 = np.concatenate([
np.arange(-10, 0) / epsilon + 0.5,
np.arange(-10, 0) / epsilon - 0.5,
]) #(20,)

W2 = np.concatenate([np.ones(10), -np.ones(10)]) #(20,)

x = np.linspace(0, 10, 101).reshape(-1, 1) #(101, 1)
y = np.maximum(x @ W1 + b1, 0) @ W2 #(101,)
#(x @ W1).shape=(101, 20)

import matplotlib.pyplot as plt
plt.figure()
plt.gca().set_aspect('equal')
plt.scatter(x,y, s=1)
plt.xlabel('input')
plt.ylabel('pred')
plt.savefig('results.png')

我转成了pytorch实现:

import torch
import torch.nn as nn
import torch.optim as optim
import random
import torch.nn.functional as F
import numpy as np

class Test(nn.Module):
    def __init__(self):
        super(Test, self).__init__()
        epsilon = 1e-3
        # self.w1 = nn.ParameterList([nn.Parameter(torch.randn(1,20))])
        # self.b1 = nn.ParameterList([nn.Parameter(torch.randn(20,))])
        # self.w2 = nn.ParameterList([nn.Parameter(torch.randn(20,1))])
        
        self.custom_w1 = (np.ones((1, 20))/epsilon).tolist()
        self.w1 = nn.ParameterList([nn.Parameter(torch.FloatTensor(self.custom_w1))])
        
        self.custom_b1 = (np.concatenate([np.arange(-10, 0) / epsilon + 0.5,np.arange(-10, 0) / epsilon - 0.5,])).tolist()
        self.b1 = nn.ParameterList([nn.Parameter(torch.FloatTensor(self.custom_b1))])
        
        self.custom_w2 = (np.concatenate([np.ones(10), -np.ones(10)])).reshape(20,1).tolist()
        self.w2 = nn.ParameterList([nn.Parameter(torch.FloatTensor(self.custom_w2))])

    def forward(self, x):
        x = torch.mm(x,self.w1[0])
        x = x+self.b1[0]
        x = nn.ReLU()(x)
        x = torch.mm(x,self.w2[0])
        return x
    
model = Test()
optimizer = optim.Adam(model.parameters(), lr=0.01)

epochs = 100000
batch_size = 3200

for epoch in range(epochs):
    inputs = torch.rand(batch_size, 1) * 10 #3200*1
    targets = torch.floor(inputs) #3200*1

    outputs = model(inputs) #3200*1
    criterion = nn.MSELoss()
    loss = criterion(outputs, targets)
   
    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    
    if (epoch+1) % 1000 == 0:
        print(f'Epoch [{epoch+1}/{epochs}], Loss: {loss.item():.4f}')

model = model.cpu()
num_samples = 500
print(list(model.named_parameters()))

test_inputs = torch.rand(num_samples, 1) * 10
with torch.no_grad():
    predicted_outputs = model(test_inputs)

import matplotlib.pyplot as plt
plt.figure()
plt.gca().set_aspect('equal')
plt.scatter(test_inputs.numpy(), predicted_outputs.numpy(), s=1)
plt.xlabel('input')
plt.ylabel('pred')
plt.savefig('results.png')

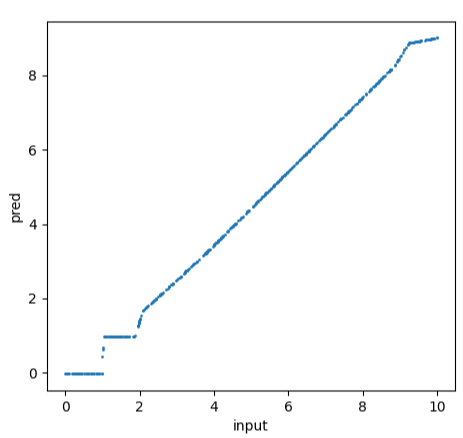
如果直接给模型的初始参数赋予最佳值,而不训练,那么拿数据去推理,发现是对得上的(这只能说明我的pytorch代码写得没有问题)。

原文配图

注意,这里有一个浮点精度的坑。epsilon = 1e-7时,参数会被放得很大。偏置中的大数加上或减去0.5,存进float32后会变成同一个数,后面再做减法,原本应该留下的差值就丢了。改成epsilon = 1e-3,可以减轻这种精度损失。

但是如果没有手动赋予最佳值,而是让模型去训练,我试了很多次,训练效果都不理想。

原文配图


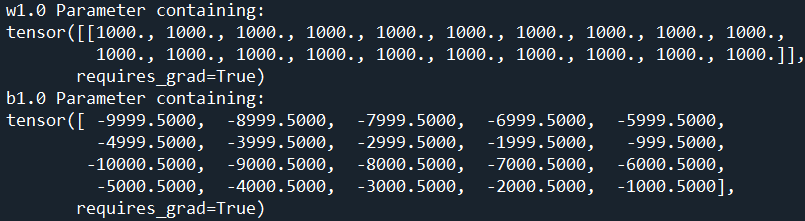
我认为根本原因是最佳参数太大了,如果epsilon = 1e-3的话,最佳参数如下图所示,最大到了10000的量级:

原文配图

一般来说,参数初始化的值的绝对值都在个位数以内,优化到几千的量级不是一件容易的事情。

如果要减少最佳参数的值,epsilon应该进一步增大(因为有些最佳参数等于1/epsilon),比如设置epsilon = 1e-1,但是epsilon增大的话,就越来越不像示性函数了,对int(x)的拟合作用就更弱了。这似乎是一个病态问题?

知乎原文

所有人面前都有个按钮,按的人数在整体人数的66%左右(56~76%)时,所有人才能活下来。你按不按?

有趣的问题。如果这个问题建立在“所有人都很聪明且想活命,所有人都知道所有人都很聪明且想活命,所有人都知道所有人都知道所有人都很聪明且想活命……”的基础上,一个简单可行的办法是:每个人自发地原地取材,构造一个发生概率为2/3的事件,根据事件的发生与否来决定是否要按。

比如抛两次硬币,结果是一正一反则按下,两次正面则不按,两次反面则从头再来。(可能存在倒霉蛋会重复几百遍甚至更多遍这个过程)

现实里,不少人可能会想:既然要有三分之二的人按,那我就按吧。如果我判断按的人会太多,我反而会选择不按。大家都抢着按的时候,不按也是在救人。

知乎原文

要基于pytorch做深度学习,但是我代码水平很低,我应该如何学习呢?

直接动手,在代码中理解深度学习的原理。复杂的代码看不懂,那就从简单的代码开始看起。

举个例子,如果你对梯度下降没有彻底弄懂,先直接写几行代码,跑一个简单的例子。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0]**2 + 2*w[1]**2
opti = torch.optim.SGD([w],lr=0.01)
loss.backward()
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)

result:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4800], requires_grad=True)

w是参数,在实际项目中几百万个参数太复杂了,那我直接指定两个参数行不行?

loss是简单的损失函数: loss=w12+2*w22loss=w_{1}^{2}+2*w_{2}^{2}

梯度可以直接口算: dlossdw=[2*w1,4*w2]\frac{d loss}{dw}=[2*w_{1},4*w_{2}]

梯度更新公式: $w=w-learning\_rate*\frac{dloss}{dw}\\=[0.5,0.5]-0.01*[1,2]\\=[0.49,0.48]$

对照代码的结果,发现结果是一致的,是不是可以加深理解梯度下降法?

多改动代码中的一些参数,多试试不同的例子,可以更深入地理解原理。


改动一:多更新一次参数,会怎样?

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0]**2 + 2*w[1]**2
opti = torch.optim.SGD([w],lr=0.01)
loss.backward()
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.step()
print("w:",w)

result:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4800], requires_grad=True)
w: tensor([0.4800, 0.4600], requires_grad=True)

可以看到,opti.step()的作用只是机械地再做一次梯度更新。

实际训练中,是不是这样一步一步地更新参数?并不是。更新完参数后,需要用新的参数跑下一批数据,然后得到新的loss,算出新的梯度。

于是应该做一些改动:更新完参数后,让梯度清零,然后重新做梯度计算。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.SGD([w],lr=0.01)
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.zero_grad()
loss = w[0].clone()**2 + 2*w[1].clone()**2
loss.backward()
print("w的梯度:",w.grad)
opti.step()
print("w:",w)

result:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4800], requires_grad=True)
w的梯度: tensor([0.9800, 1.9200])
w: tensor([0.4802, 0.4608], requires_grad=True)

由于w已经变成[0.49,0.48]

那么 $w=w-learning\_rate*\frac{dloss}{dw}\\=[0.49,0.48]-0.01*[0.98,1.92]\\=[0.4802,0.4608]$

可以和代码对得上。

这里做了两次梯度更新。如果要做很多次呢?自然而然就会用到循环了。


改动二:看看SGD还有哪些参数可以调整的?比如权值衰减。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.SGD([w],lr=0.01,weight_decay=1)
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.step()
print("w:",w)

result:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4850, 0.4750], requires_grad=True)
w: tensor([0.4702, 0.4502], requires_grad=True)

如果引入权值衰减,相当于损失函数增加了参数向量的二范数的平方,即

$loss=loss+\frac{\lambda}{2}||w||^2\\=w_{1}^{2}+2*w_{2}^{2}+\frac{\lambda}{2}(w_{1}^{2}+w_{2}^{2})$

代码中weight_decay=1,即

loss=32w12+52w22loss=\frac{3}{2}w_{1}^{2}+\frac{5}{2}w_{2}^{2}

dlossdw=[3*w1,5*w2]\frac{d loss}{dw}=[3*w_{1},5*w_{2}]

$w=w-learning\_rate*\frac{dloss}{dw}\\=[0.5,0.5]-0.01*[1.5,2.5]\\=[0.485,0.475]$

可以和代码结果对上。

注意,打印梯度的时候,你会发现w的梯度没有把权值衰减考虑进去。因为权值衰减是优化器要考虑的事情,而反向传播(求梯度)不关优化器的事情。权值衰减是在优化器阶段做的。


改动三:看看SGD还有哪些参数可以调整的?比如momentum。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.SGD([w],lr=0.01,momentum=0.1)
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.step()
print("w:",w)

result:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4800], requires_grad=True)
w: tensor([0.4790, 0.4580], requires_grad=True)

momentum方法引入了动量的概念。每次梯度更新的量不是learning_rate*grad,而是动量。

vt+1=gamma*vt+learning_rate*gradv_{t+1}=gamma*v_t+learning\_rate*grad

vtv_t 的初始值为0。在代码中gamma=0.1

在第一次更新中,

v1=0.1*0+0.01*[1,2]=[0.01,0.02]v_{1}=0.1*0+0.01*[1,2]=[0.01,0.02]

$w=w-v_1\\=[0.5,0.5]-[0.01,0.02]\\=[0.49,0.48]$

到目前为止和不带动量的SGD的结果一致。

第二次更新,

$v_{2}=0.1*v_1+0.01*[1,2]\\=[0.001,0.002]+[0.01,0.02]\\=[0.011,0.022]$

$w=w-v_2\\=[0.49,0.48]-[0.011,0.022]\\=[0.479,0.458]$

和代码的结果一致。


改动四:除了SGD,我能不能使用其他优化器?比如adagrad?

SGD对于每一个参数都使用同一个学习率。adagrad则对每一个参数使用不同的学习率:梯度越大,学习率越小;梯度越小,学习率越大。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.Adagrad([w],lr=0.01,lr_decay=0, weight_decay=0, initial_accumulator_value=0)
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.zero_grad()
loss = w[0].clone()**2 + 2*w[1].clone()**2
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
opti.step()
print("w:",w)

output:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4900], requires_grad=True)
w的梯度: tensor([0.9800, 1.9600])
w: tensor([0.4830, 0.4830], requires_grad=True)

adagrad会维护一个和w同维度的tensor sts_t ,t代表步数,默认 s0=0s_0=0

首先看第一步( ⊙\odot 符号指的是对应元素的点乘):

$s_1=s_0+grad\odot grad\\=s_0+[1,2]\odot[1,2]\\=[1,4]$

$w=w-\frac{learning\_rate}{\sqrt{s_1}}\odot grad\\=[0.5,0.5]-\frac{0.01}{[1,2]}\odot[1,2]\\=[0.49,0.49]$

再来看第二步:

$s_2=s_1+grad\odot grad\\=s_1+[0.98,1.96]\odot[0.98,1.96]\\=[1,4]+[0.9604,3.8416]\\=[1.9604,7.8416]$

$w=w-\frac{learning\_rate}{\sqrt{s_2}}\odot grad\\=[0.49,0.49]-\frac{0.01}{[\sqrt{1.9604},\sqrt{7.8416}]}\odot[0.98,1.96]\\=[0.483,0.483]$

笔算结果和代码一致。adagrad本质上是对学习率做了一个修正: learning_ratest\frac{learning\_rate}{\sqrt{s_t}} 。从adagrad的公式可以看出,某个参数的梯度越大,其对应的学习率越小。在本例子中, w2w_2 比 w1w_1 的梯度大,对应的学习率更小,大和小相抵消后,w1w_1 和 w2w_2 更新的步长刚好相同。

而且可以从公式中看出,adagrad算法需要维护一个和w形状一致的张量 sts_t 。也就是说,引入adagrad后,显存会至少增加一倍参数量的级别。


改动五:既然之前尝试了SGD/Adagrad,那么我干脆把几个常见的优化器都尝试一遍,比如RMSprop

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.RMSprop([w],lr=0.01,alpha=0.5, eps=0,momentum=0,weight_decay=0,)
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.zero_grad()
loss = w[0].clone()**2 + 2*w[1].clone()**2
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
opti.step()
print("w:",w)

output:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4859, 0.4859], requires_grad=True)
w的梯度: tensor([0.9717, 1.9434])
w: tensor([0.4744, 0.4744], requires_grad=True)

RMSprop是基于adagrad的改进,adagrad累加梯度平方的公式是 st+1=st+grad⊙grads_{t+1}=s_t+grad\odot grad

RMSprop的移动平均公式是 st+1=α⋅st+(1−α)grad⊙grads_{t+1}=\alpha \cdot s_t+(1-\alpha)grad\odot grad ,也就是说,多了一个可调节的超参数。

首先看第一步: $s_1=0.5s_0+0.5\cdot grad\odot grad\\=0.5s_0+0.5\cdot[1,2]\odot[1,2]\\=[0.5,2]$

$w=w-\frac{learning\_rate}{\sqrt{s_1}}\odot grad\\=[0.5,0.5]-\frac{0.01}{[\frac{1}{\sqrt{2}},\sqrt{2}]}\odot[1,2]\\=[0.4859,0.4859]$

再来看第二步:

$s_2=0.5s_1+0.5\cdot grad\odot grad\\=0.5s_1+0.5\cdot[0.9717,1.9434]\odot[0.9717,1.9434]\\=[0.25,1]+[0.4721,1.8884]\\=[0.7221,2.8884]$

$w=w-\frac{learning\_rate}{\sqrt{s_2}}\odot grad\\=[0.4859,0.4859]-\frac{0.01}{[\sqrt{0.7221},\sqrt{2.8884}]}\odot[0.9717,1.9434]\\=[0.474465,0.474465]$

笔算结果和代码结果有万分之一的误差,可能是由于笔算多次四舍五入的差异导致。

如果令参数alpha=0,在这个例子里,梯度更新公式就变成 w=w−learning_ratew=w-learning\_rate 。它仍然根据梯度决定方向:梯度为正就减,为负就加,只是步长不再随梯度大小变化。


改动六:目前已经试了momentum和RMSprop,而adam结合了以上两种优化思想,接下来试试adam

adam的梯度更新公式如下:

$m_t=\beta_1m_{t-1}+(1-\beta_1)g_t\\v_t=\beta_2v_{t-1}+(1-\beta_2)g_{t}^{2}\\w=w-learning\_rate\cdot\frac{\frac{m_t}{1-\beta_1^t}}{\sqrt{\frac{v_t}{1-\beta_2^t}}}$

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
loss = w[0].clone()**2 + 2*w[1].clone()**2
opti = torch.optim.Adam([w],lr=0.01,eps=0,betas=(0.5,0))
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
print("w:",w)
opti.step()
print("w:",w)
opti.zero_grad()
loss = w[0].clone()**2 + 2*w[1].clone()**2
loss.backward(retain_graph=True)
print("w的梯度:",w.grad)
opti.step()
print("w:",w)

output:

w的梯度: tensor([1., 2.])
w: tensor([0.5000, 0.5000], requires_grad=True)
w: tensor([0.4900, 0.4900], requires_grad=True)
w的梯度: tensor([0.9800, 1.9600])
w: tensor([0.4799, 0.4799], requires_grad=True)

首先看第一步:

m1=0.5⋅[0,0]+0.5⋅[1,2]=[0.5,1]m_1=0.5\cdot[0,0]+0.5\cdot[1,2]=[0.5,1]

v1=[1,2]⋅[1,2]=[1,4]v_1=[1,2]\cdot [1,2]=[1,4]

$w=w-0.01\cdot\frac{\frac{[0.5,1]}{0.5}}{[1,2]}\\=[0.5,0.5]-[0.01,0.01]\\=[0.49,0.49]$

然后看第二步:

m2=0.5⋅[0.5,1]+0.5⋅[0.98,1.96]=[0.74,1.48]m_2=0.5\cdot[0.5,1]+0.5\cdot[0.98,1.96]=[0.74,1.48]

v2=[0.98,1.96]⋅[0.98,1.96]v_2=[0.98,1.96]\cdot[0.98,1.96]

$w=w-0.01\cdot\frac{\frac{[0.74,1.48]}{0.75}}{[0.98,1.96]}\\=[0.49,0.49]-0.01\cdot\frac{\frac{[0.74,1.48]}{0.75}}{[0.98,1.96]}\\=[0.4799,0.4799]$

注:Adam的weight_decay是起作用的。比如刚开始w1=0.5,原来的梯度是1;如果weight_decay=1,优化器用的梯度就变成1.5。只是这个例子比较特殊,又设置了eps=0,梯度放大之后,Adam公式里的分子、分母也跟着放大,最后抵消了,所以看起来参数更新没变。AdamW则是在更新参数时,额外减去learning_rate*weight_decay*w。


改动七:试试结合学习率调整策略来看梯度下降的结果。

pytorch中学习率调整策略分为三种:

(1)基于既定规则,比如等间隔调整(step)、指数衰减调整(exponential)等

(2)基于监控目标,自适应调整,比如ReduceLROnPlateau

(3)自定义调整

下面的代码以自定义调整为例,自定义了lambda函数,调整后的学习率等于初始学习率乘以epoch轮数。注意本例子中学习率调整的时机在梯度更新之前。

import torch
w = torch.tensor([0.5,0.5],requires_grad=True)
opti = torch.optim.Adam([w],lr=0.01,eps=0,betas=(0.5,0))
scheduler = torch.optim.lr_scheduler.LambdaLR(opti, lr_lambda=lambda x:x)
for epoch in range(2):
    loss = w[0].clone()**2 + 2*w[1].clone()**2
    loss.backward(retain_graph=True)
    print("\n===当前轮数:",epoch)
    print("w的梯度:",w.grad)
    print("梯度更新前的w:",w)
    scheduler.step()
    print("当前学习率:",scheduler.get_lr()[0])
    opti.step()
    print("梯度更新后的w:",w)
    opti.zero_grad()

output:

===当前轮数: 1
w的梯度: tensor([1., 2.])
梯度更新前的w: tensor([0.5000, 0.5000], requires_grad=True)
当前学习率: 0.01
梯度更新后的w: tensor([0.4900, 0.4900], requires_grad=True)

===当前轮数: 2
w的梯度: tensor([0.9800, 1.9600])
梯度更新前的w: tensor([0.4900, 0.4900], requires_grad=True)
当前学习率: 0.02
梯度更新后的w: tensor([0.4699, 0.4699], requires_grad=True)

第一轮的学习率=0.01*1,不变,因此结果和【改动六】一致。

第二轮的学习率=0.01*2=0.02,因此第二轮中,

$w=w-0.02\cdot\frac{\frac{[0.74,1.48]}{0.75}}{[0.98,1.96]}\\=[0.49,0.49]-0.02\cdot\frac{\frac{[0.74,1.48]}{0.75}}{[0.98,1.96]}\\=[0.4699,0.4699]$

和代码结果一致。


用简单的例子去跑代码,多调整一些不同的参数。然后对比笔算结果和代码结果是否一致。这种方法既可以加深对深度学习基础知识的理解,也可以更快入门pytorch代码。
知乎原文

一个人扔六面的骰子,数值1到6,扔到几就向前走几格,可以无限扔,问他恰好走到第2023格的概率是多少?

答案约等于数学期望的倒数:2/7。

这道题可以选择的步数是{1,2,3,4,5,6},如果改成{3,4},答案也一样是2/7。即每次随机等概率地走3步或者4步,恰好走到2023的概率是2/7。改成{2,5}也一样,改成{2,3,4,5}也一样……

这个问题可以一般化:记可以选择的步数集合为{ x1,x2,...,xnx_{1},x_{2},...,x_{n} },记E为集合的平均数,即 E=x1+x2+...+xnnE = \frac{x_{1}+x_{2}+...+x_{n}}{n} ,当目标格子足够远时,恰好走到它的概率约等于 1E\frac{1}{E} ,即刚好是平均数的倒数。

比如说抛硬币,正面则向前走1步,反面则向前走2步,则恰好走到第2023格的概率约等于 23\frac{2}{3} 。


直观但不严谨的理解:

类似甜咖啡苦回味的思路,由于所有可能性是相等的,所有可能的步数走一遍可以到达第x1+x2+...+xnx_{1}+x_{2}+...+x_{n}个格子,但是中途只停靠了n个格子,因此某个格子被停靠的概率是nx1+x2+...+xn\frac{n}{x_{1}+x_{2}+...+x_{n}},这刚好是平均数的倒数。


第二种思路:

借鉴灵剑的思路,记M为最大的可选步数,记q(k)为所有可选步数中,大于k的概率,记p(m)为恰好走到第m个格子的概率。

当m很大的时候,可以近似认为p=p(m)=p(m+1)=p(m+2)......

于是有 1−p=(q(1)+...+q(M))p1-p=(q(1)+...+q(M))p (可以这样理解:p表示恰好停靠到第2023个格子的概率,那么1-p表示路过第2023个格子的概率。q(1)*p表示走到第2022个格子的时候,有q(1)的概率会路过第2023个格子,因为在所有可选步数中,有q(1)的概率是大于1的,在这道题中,骰子有六种选择,q(1)等于5/6,在第2022个格子的时候,如果再扔一次骰子,它有5/6的概率直接路过第2023个格子;q(2)*p表示走到第2021个格子的时候,有q(2)的概率会路过第2023个格子,后面以此类推)

注意 q(0)q(0) 显然等于1(因为所有可能的步数都是正数)

得到 p=1q(0)+q(1)+...+q(M)p=\frac{1}{q(0)+q(1)+...+q(M)}

这个式子已经很简洁漂亮了。但是还能再进一步:

概率论中有一个常用的结论:

原文配图

比如某次走了3步,那么“大于0”“大于1”“大于2”各贡献一个1,后面都是0,加起来正好是3。其他步数也一样。最后把这些贡献取平均,就得到了平均步数。

于是 p=1Ep=\frac{1}{E}


注意还需要满足一个前提:所有可能的步数需要覆盖所有较大的格子。比如可选步数只有2和4的话,那么无论如何都到不了奇数位的格子。

有兴趣的小伙伴可以研究下可选步数中包含零或者负数的情况。

这道题最后用到的期望公式,我在《大白话概率论》里还用灯泡寿命的例子拆开讲过。有兴趣可以看看。

知乎原文

哪些数学书让你相见恨晚?

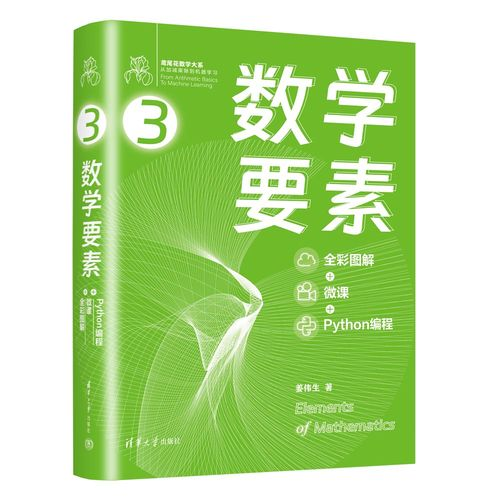
推荐生姜的《数学要素》。

原文配图

我一直在寻找有没有一本能够深入浅出、数形结合、生动形象、由浅入深,既不晦涩难懂,但又不浅尝辄止的数学书;一本不以考试为目的,但是实用地教学现代数学基本概念和框架,并能将数学知识应用在计算机甚至生活领域的数学书。当我看到《数学要素》这本书,我的心里冒出了4个字——就是它了。

以我熟悉的概率论部分为例,我想分享我看完概率章节的想法。

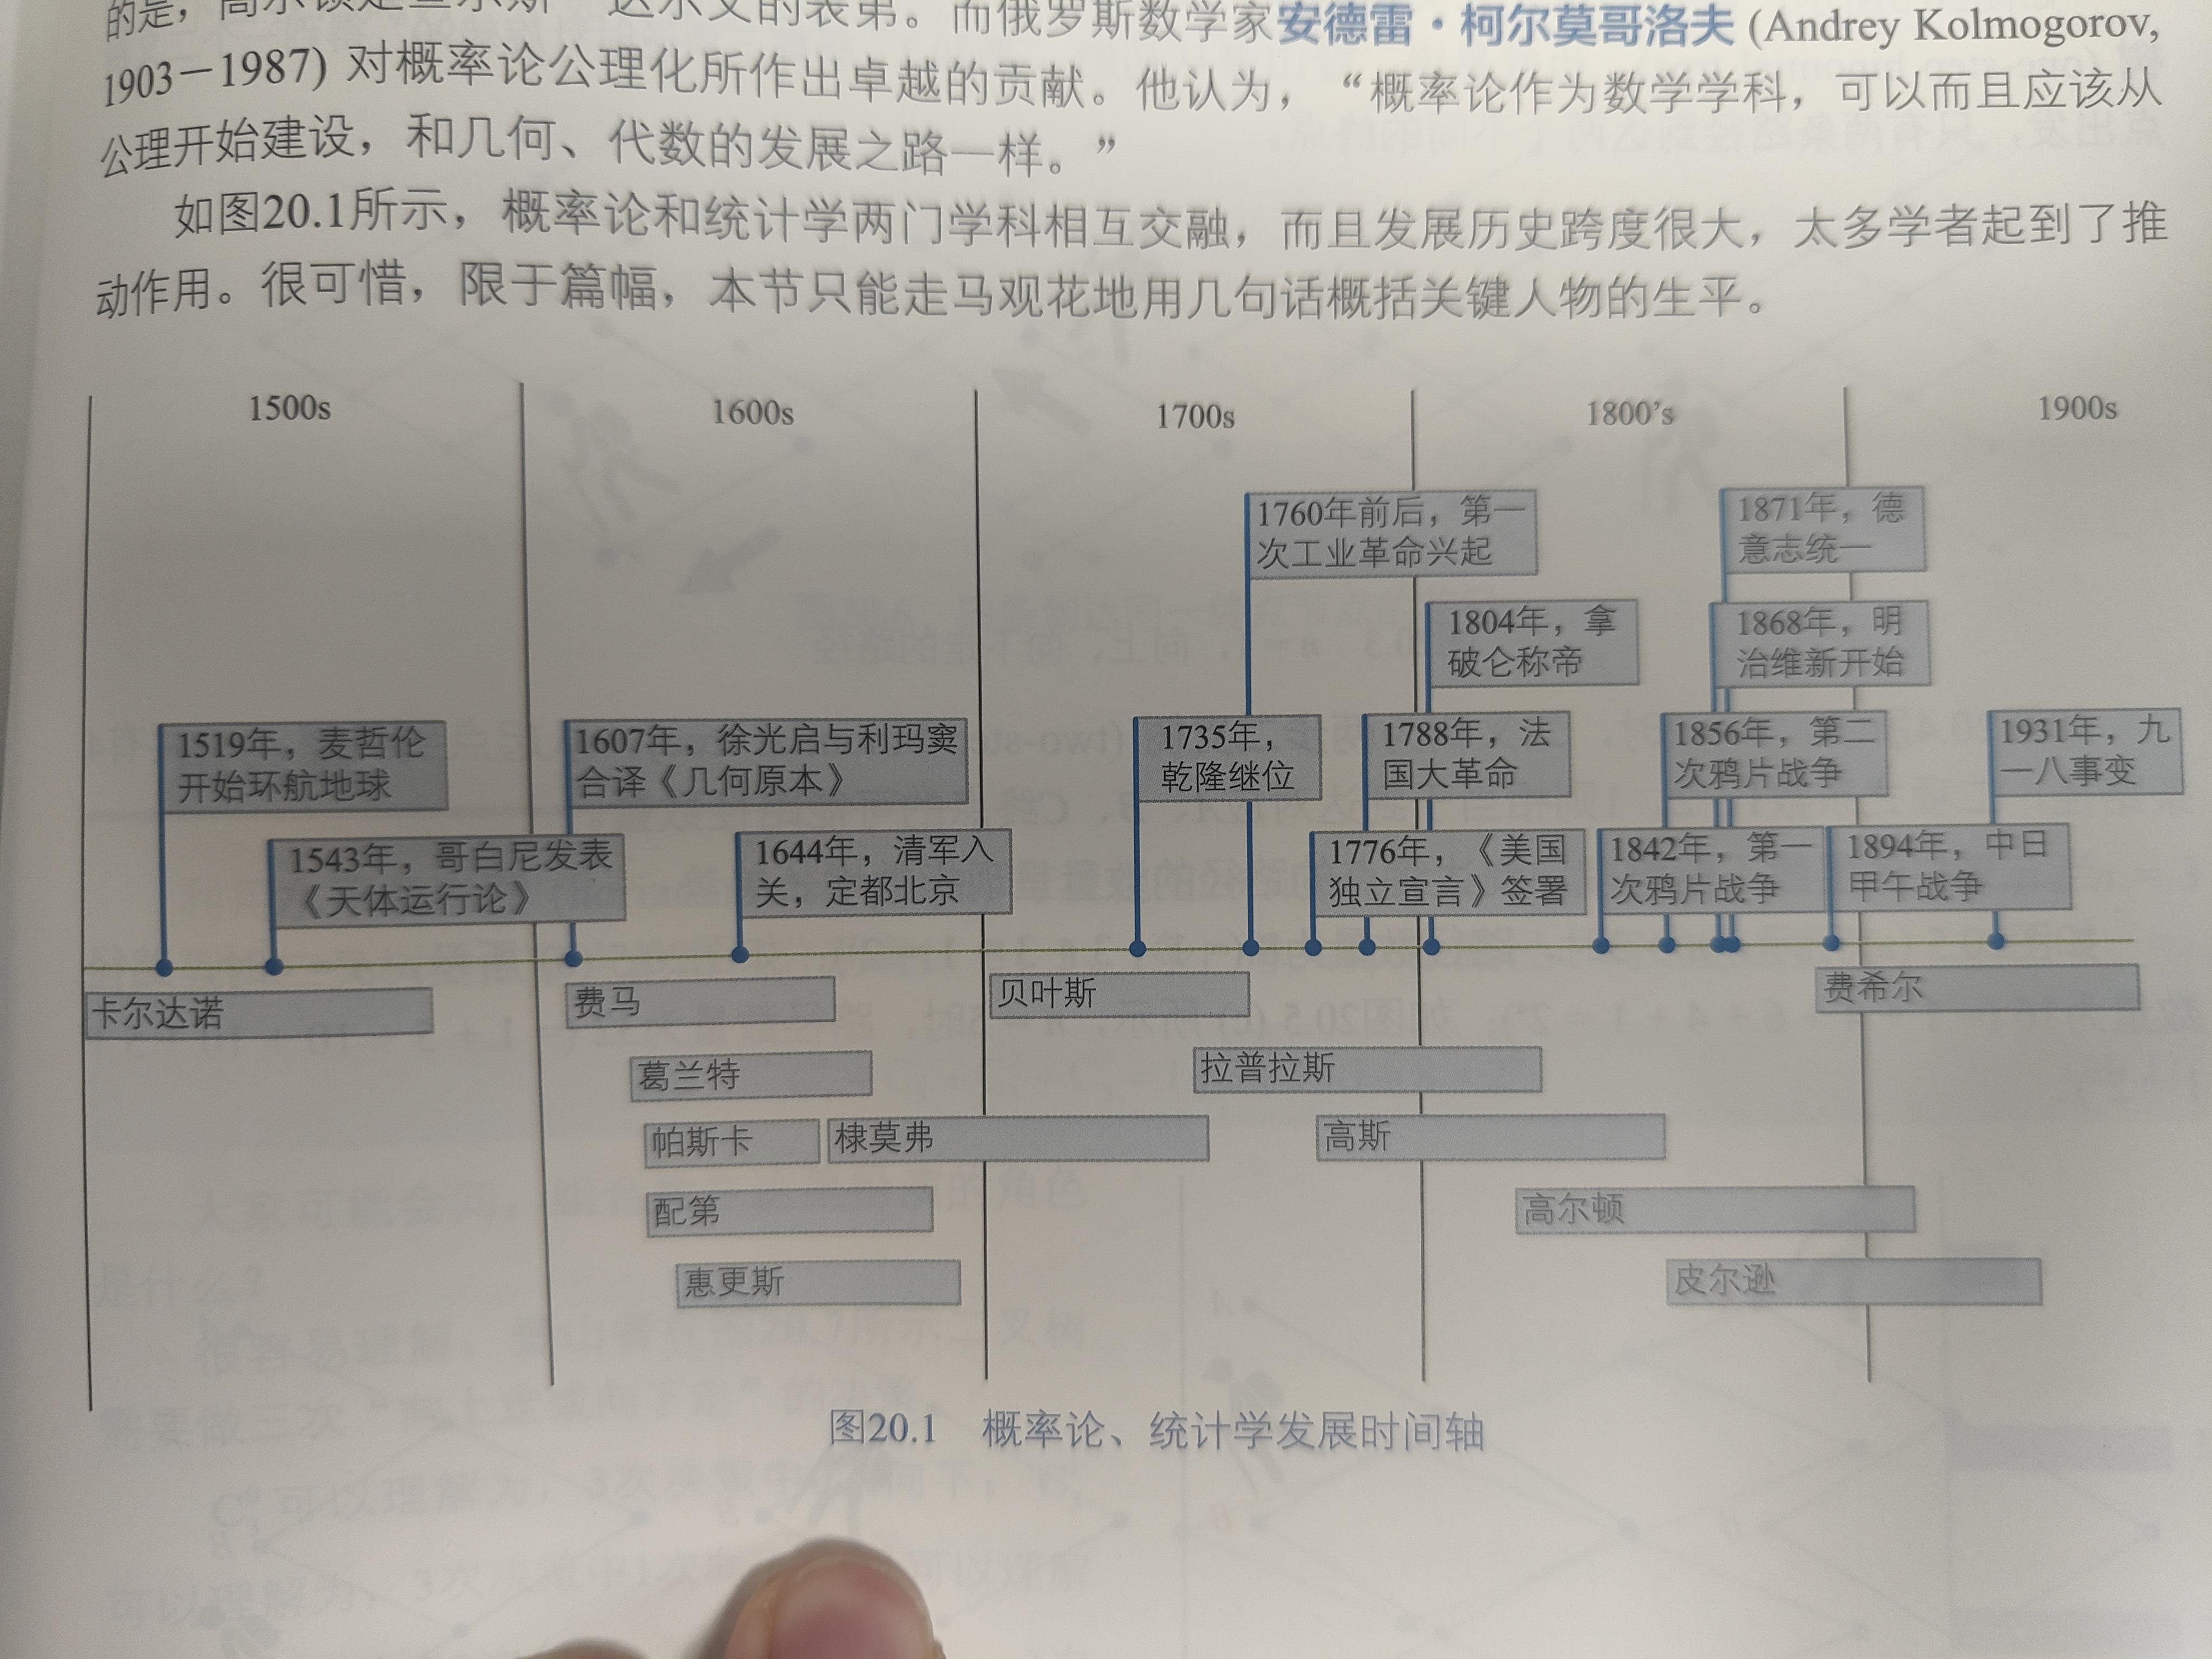
原文配图

在章节的开始,有一个时间轴,整合了概率论发展历史和同时期历史重大事件。我很喜欢这个思路——数学不仅仅是冰冷的公式,更是一部鲜活的发展史。当贝叶斯提出贝叶斯公式的时候,我国还在乾隆时期,“天朝上国,地大物博,无奇不有”。当贝叶斯公式蕴含的哲学思想点燃思想界的篝火的时候,我们还在三纲五常的礼教下循规蹈矩。当高斯研究正态分布的时候,我国正悄悄处于近代史变天的前夜,一场持续百年的民族屈辱即将到来。强烈的对比更激发了我探究的欲望——贝叶斯、高斯、拉普拉提,究竟是什么研究,推动了数学的车轮,甚至是人类文明的车轮向前?

第二个令我意外的点是杨辉三角。杨辉三角(包括本书的另一个亮点主题“鸡兔同笼”)在中学甚至小学阶段就出现在数学教辅书上。我原以为这两个问题仅仅是中小学数学竞赛的奇淫技巧,但这本书巧妙地将这两个主题作为暗线,将代数、几何、概率、线性代数、随机过程串联在一起,从多个新的角度来重新阐释杨辉三角和鸡兔同笼问题,瞬间给人一种“条条大路通罗马”的通达感。

作者将杨辉三角、随机游走、二叉树等概念巧妙地结合在一起——这才是学习数学的正确姿势。知识点之间并不是孤立的,而是可以有内在联系的。目前主流的数学书似乎并没有重视到这一点。我一直以认为,将看起来毫不相关的知识串联在一起是一件很酷的事情。这本书做到了。

杨辉三角的章节中蕴含了“两次算”思想。数学思想也是一个很重要的角度,但是大多数数学书并没有关于数学思想的培养。从我个人的角度,我非常喜欢“两次算”思想。因为我在很小的时候,我看到有一本竞赛辅导书介绍过这个问题,巧妙的构思给我一种茅塞顿开的感觉,强烈地激发了我学习数学的兴趣。

抛n次硬币,一共有多少个结果?如何解释 Cn0+Cn1+Cn2+……+Cnn=2nC_{n}^{0}+C_{n}^{1}+C_{n}^{2}+……+C_{n}^{n}=2^n? 这是一个很简单的问题。作者另辟蹊径,从多个角度去解释,不同角度得到的结果是一致的——两次计算,殊途同归——这种思想很值得玩味。

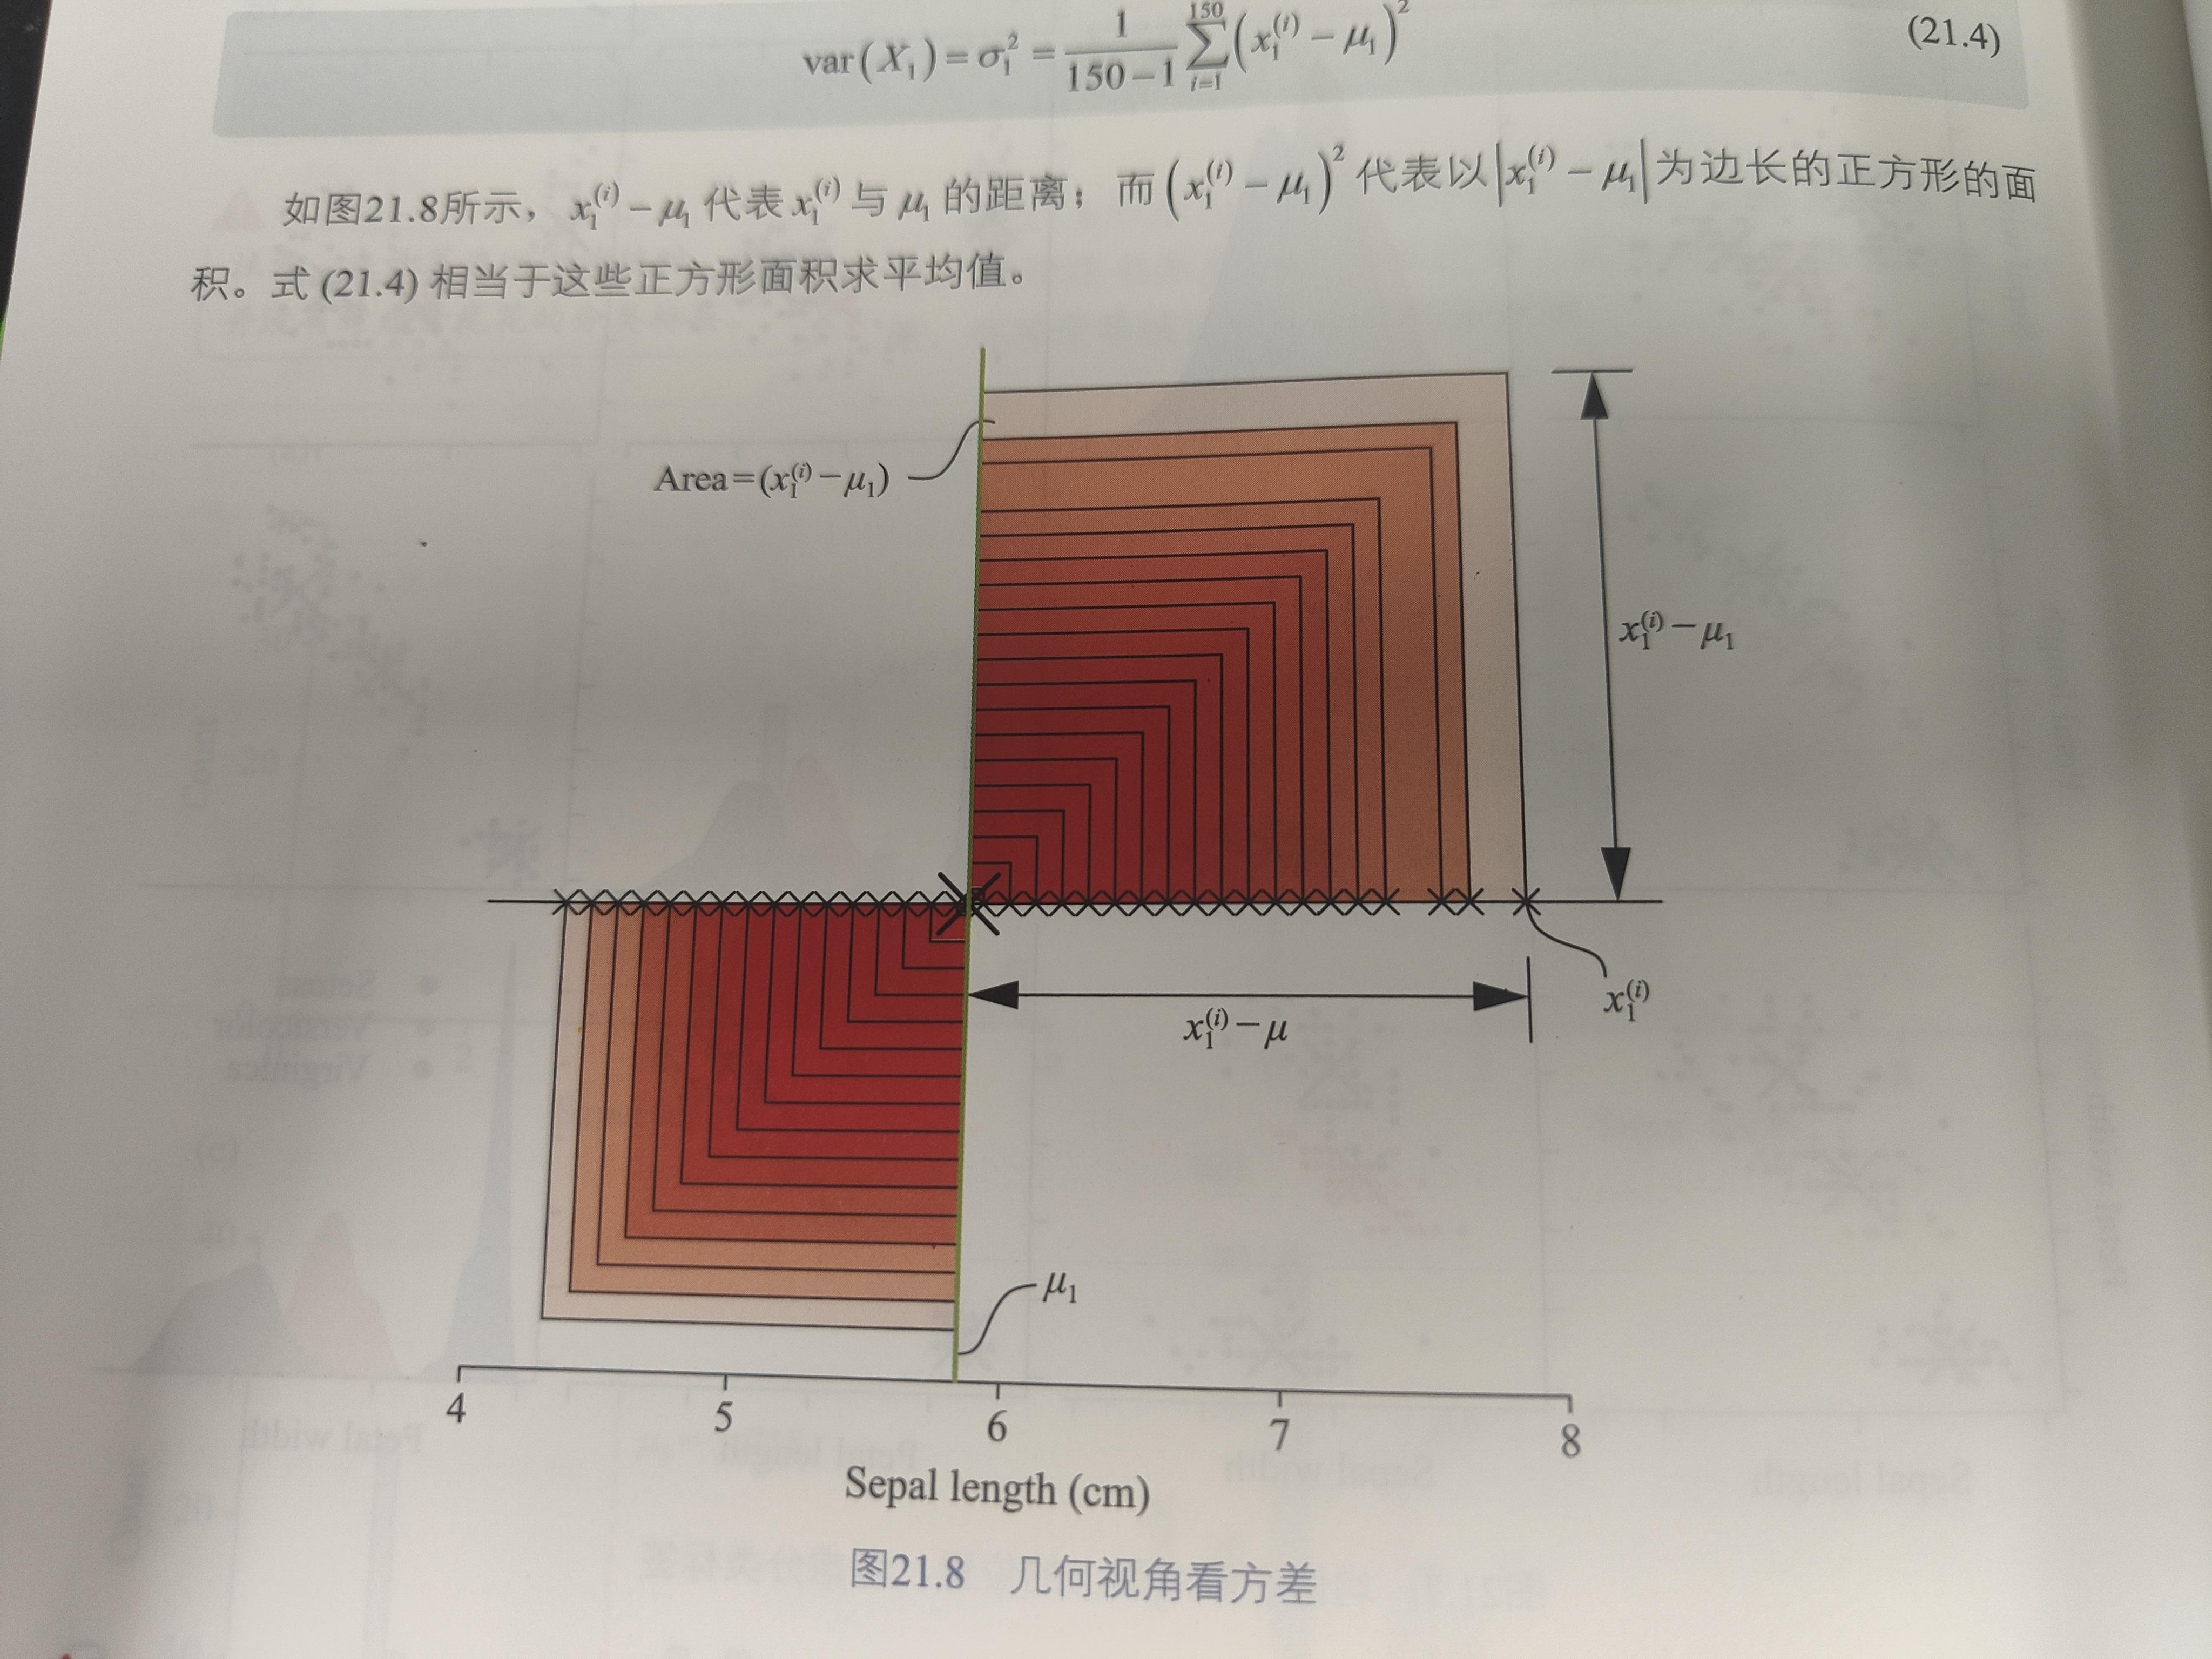
第三个令我眼前一亮的点是,作者从面积的角度来解释方差和协方差。这是以往教科书不曾涉及过的角度。

原文配图

提一个小建议:这部分还可以更加深入——面积背后的数学直觉是什么?面积如何将“离散程度”联系在一起?

以上仅仅列举了概率论部分的亮点。本书的其他亮点还有很多,只是限于篇幅,未能一一列举。

这套书籍提供了可以执行的代码文件,这对学习是至关重要的。仅仅看数学书上的内容,或者做几道题,只能浅尝辄止。只有动手,自己切身去一步一步推导流程,结合代码去数形结合地领会问题的本质,才能真正地将知识消化在自己的脑海里。

知乎原文

突然读懂了一首诗词是什么感受?

我在武大读大四的那个春天,正值樱花季和考研复试。我在复试中表现得不理想,已经做好了落选的心理准备,并联系了几所学校商量调剂。放榜那天,我坐在宿舍一遍遍刷新官网页面,在不知道第几次刷新时,我突然在表格中看到了我的名字。我顿时喜出望外地冲出宿舍。从樱花大道到行政楼,从梅园到桂园,我把每一棵盛开的樱花树都看了个遍。来武大四年了,这是我第一次发自内心地欣赏校园樱花。虽然人山人海,但我感觉时间过得很快。

——春风得意马蹄疾,一日看尽长安花。

知乎原文

现实中是否存在概率为零的事件?

这个问题更像一个哲学问题。

一个简单粗暴的方法是找到一个“不可能事件”就行了,毕竟“不可能事件”一定是“零概率事件”。比如“太阳从西边升起”。但是太阳从西边升起真的是不可能事件吗?谁能保证明天哪个神级文明的外星生命不会来太阳系搞一个恶作剧呢?

又比如“我可以不借助任何外力原地起飞100米高”,古往今来没有任何一个人会飞,这总是不可能事件了吧?但是难道没有一丁点儿可能,我身体内的各种细胞以一种恰到好处的排列方式变化,使得我突然有了飞行的能力?哪怕这个可能性只有 10−10010^{-100} ?

如果找不到不可能事件的话,那么是不是可以退一步,找一个“可能发生但是概率为0”的事件?比如在(0,10)的数轴上均匀取一个点,取到的点刚好为5这个整数的概率是0。

为什么是0?因为均匀地取,落在哪一段的概率,就看那一段有多长。比如落在4到6之间,这一段的长度是2,总长度是10,概率就是2/10。但是“刚好是5”只有一个点,没有长度,所以概率就是0。这里的0不是一个特别小、被四舍五入成0的数,就是0。

在抽象的数学世界中,这是成立的。但是在现实世界,拿尺子量出来的“刚好是5”,通常只是显示到某一位后是5。我们刚刚算的是数学模型里取到5这个点的概率,这两件事要分开。


以下是补充材料:

很多人没有弄明白“概率为0”的含义,把它和“不可能”混为一谈,认为“概率为0的事件”等于“不可能事件”。

“不可能事件”的定义是:若 A=ϕA=\phi ,则 AA 是不可能事件;零概率事件的定义是:若 P(A)=0P(A)=0 ,则 AA 是零概率事件。咋一看,两个定义好像没有什么区别。的确,在掷骰子这样的离散模型中,两者是等价的。但是在连续场合,零概率事件是有可能发生的。比如 XX 服从(0,1)上的均匀分布,那么事件{ X=0.5X=0.5 }发生的概率为0,因为连续型随机变量取一个点的概率为0。但是事件{ X=0.5X=0.5 }是有可能发生的。不可能事件比零概率事件更强。若 P(A)=0P(A)=0 ,无法推出 AA 是空集。

此外,还需要弄明白“事件”的定义。先看“样本空间”。什么是样本空间?样本空间是一个集合,组成这个集合的元素是样本点。什么是样本点?样本点是一个随机现象的最基本的可能的结果。什么是随机现象?并不总是出现相同结果的现象叫做随机现象。问到这里就不能再往下问了,因为已经没办法追本溯源了。

在一些概率论教材中,抛弃了“随机现象”的概念,指出“随机试验”的概念:①试验可在相同条件下重复进行;②每次试验只有一个结果出现且结果事前不能预知;③每次试验所有可能出现的结果已知。

随机试验所有可能出现的结果所组成的集合称为试验的样本空间。

事件域就是样本空间的某些子集组成的全部集合。

举一个例子:

同时抛两枚硬币,观察正面还是反面向上(这是一个随机现象)。

这个随机现象产生了四个最基本的结果:(正,反)、(反、正)、(反、反)、(正、正)。分别对应于(一正一反向上)、(一反一正向上)、(两个反面向上)、(两个正面向上)。

这四个最基本的结果就是四个样本点。

我们为了简化描述,把正面记为1,把反面记为0。因此这四个样本点就是(1,0)、(0,1)、(1,1)、(0,0)。

样本空间就是样本点的集合:{ (1,0),(0,1),(1,1),(0,0) }

接下来最难理解的是事件域:事件域就是样本空间的某些子集组成的集合类。

比如,事件“两个硬币的结果都是正面向上”,对应的事件是{ (1,1) };事件“至少有一个硬币的结果是正面向上”则对应于{ (1,1),(1,0),(0,1) }。

我们可以把所有的事件写出来,以下就是事件域(事件域是一个集合,这个集合的元素也是集合,所以你会看到最后面有两层集合号):

{ ∅,

{(0,0)},

{(0,1)},

{(1,0)},

{(1,1)},

{(0,0),(0,1)},

{(0,0),(1,0)},

{(0,0),(1,1)},

{(0,1),(1,0)},

{(0,1),(1,1)},

{(1,0),(1,1)},

{(0,0),(0,1),(1,0)},

{(0,0),(0,1),(1,1)},

{(0,0),(1,1),(1,0)},

{(1,1),(0,1),(1,0)},

{(0,0),(0,1),(1,0),(1,1)} }

这个事件域有16个元素。16是怎么来的呢?回想事件域的定义:样本空间的某些子集的集合类。而样本空间有4个元素,一共有 C40+C41+C42+C43+C44=24=16C_{4}^{0}+C_{4}^{1}+C_{4}^{2}+C_{4}^{3}+C_{4}^{4}=2^{4}=16 种取法,因此事件域的元素有16个。即产生了16个事件。