知乎原文
如何评价2 月 11 日上线的 DeepSeek 新模型?
完全无法接受Deepseek开始模仿GPT-5.2那种‘我会接住你’的油腻风。
DeepSeek的征途应该是星辰大海和极致逻辑,而不是堕落成一个只会熬鸡汤的‘赛博神棍’。
知乎作品库
知乎原文
完全无法接受Deepseek开始模仿GPT-5.2那种‘我会接住你’的油腻风。
DeepSeek的征途应该是星辰大海和极致逻辑,而不是堕落成一个只会熬鸡汤的‘赛博神棍’。
知乎原文
给你一个硬币,你连续扔了10次,都是正面朝上。你有理由怀疑这枚硬币不是均匀的。因为如果是均匀的,那么产生连续10次都是正面朝上的概率是1/2的10次方,等于1/1024,约等于千分之一。这个概率太小了,因此你有理由怀疑这枚硬币不是均匀的。你要拒绝“这枚硬币是均匀的”这个原假设。
当然拒绝也是有风险的,因为这枚硬币可能真的就是均匀的,只是你刚好运气爆棚而已。
这就是假设检验的基本思想。你先假设【原假设】成立,在原假设成立的情况下,如果观察到一件概率很低的事情发生了,那么你有理由推翻原假设。
注:严格来说,如果要推翻原假设,我们不仅要计算连续10次都是正面朝上的概率(1/1024),也要计算反面的情况(也是1/1024)。当然这个概率是1/512,也是很低了,足够拒绝原假设了。
这里的1/512,就是这次双侧检验的p值。我们可以事先定一个规则:抛10次,如果全是正面或者全是反面,就怀疑这枚硬币有问题。当然,好硬币也可能碰上这种情况。如果拿好硬币反复做这样的检验,平均每512次,也会误判1次。统计学里把这种“冤枉好硬币”的情况叫作第一类错误。
知乎原文
这个矩阵很有趣。在理论上一定可逆,但在计算机里几乎不可逆。
我提供一个直观理解,未必严谨,但是应该有助于你理解。
$\boldsymbol{H}_n= \begin{bmatrix} 1 & \frac{1}{2} & \frac{1}{3} & \cdots & \frac{1}{n} \\ \frac{1}{2} & \frac{1}{3} & \frac{1}{4} & \cdots & \frac{1}{n+1} \\ \frac{1}{3} & \frac{1}{4} & \frac{1}{5} & \cdots & \frac{1}{n+2} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ \frac{1}{n} & \frac{1}{n+1} & \frac{1}{n+2} & \cdots & \frac{1}{2n-1} \end{bmatrix}\\$你可以这么想:如果我们只看矩阵的前两列,把每一行都看作二维平面上的一条直线。 第一行的斜率就是 1/2, 第二行的斜率是 2/3, 第三行的斜率是 3/4, 以此类推,第 n 行的斜率就是 n/(n+1)。
你会发现,随着 n 变大,这些斜率会无限接近于 1,所有的线都挤在一起。
关键点来了:
比如,999999999/1000000000虽然不等于1000000000/1000000001,但是在计算机眼里,如果精度不够的话,这两个数就是相等的。
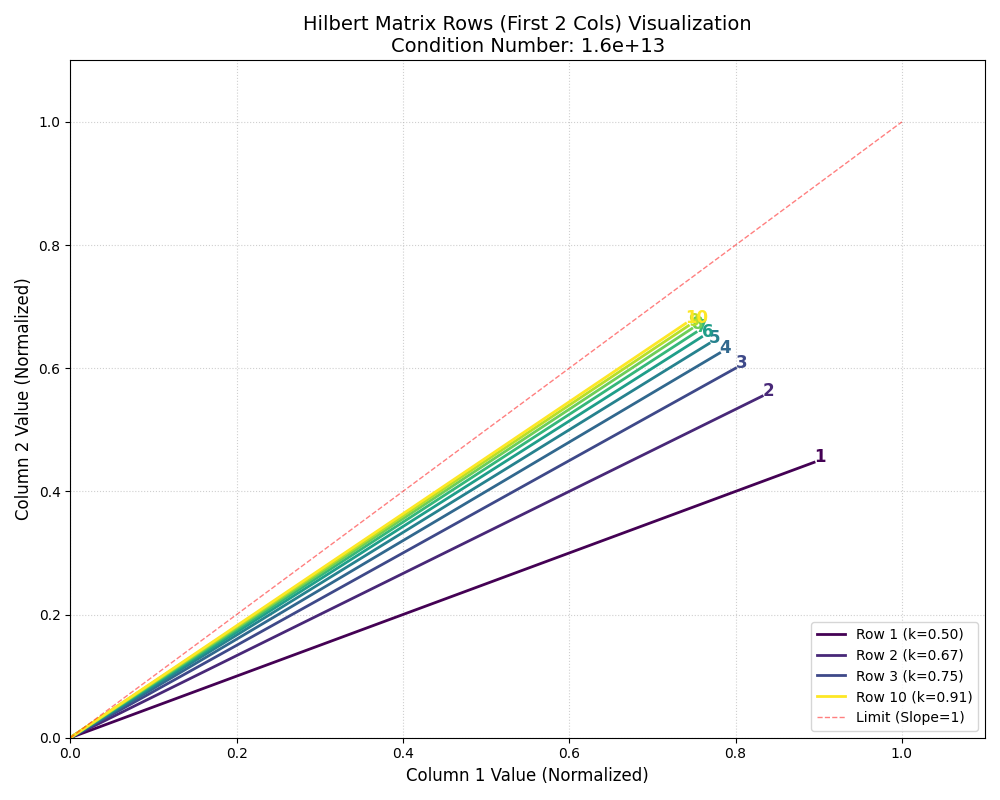
所以,这种矩阵(叫做希尔伯特矩阵),就是那种“虽然每条线都独一无二,但看起来像是一团乱麻”的典型,专门用来搞崩数值算法的。
补充:为什么它一定可逆?
这个矩阵里的分数,刚好可以用积分得到:
我们随便取 n 个不全为0的实数,把它们当作系数,拼成一个多项式:
把它平方、展开,再从0到1积分,恰好就会出现矩阵里的那些分数。把这些系数排成列向量 ,就有:
系数不全为0,这个多项式就不会处处为0。平方以后,曲线不会跑到横轴下方,而且总有一段在横轴上方,所以这块面积一定大于0。
假如 ,右边却应该等于0,矛盾了。所以,这个矩阵不可能把非零向量乘成零向量,因此它可逆。
2026年10月30日更新:我的第一本书终于出版了!
这些年,我在知乎写了不少概率论和数学相关的回答。现在,我的第一本书《大白话概率论:从数学直觉到AI视野》终于由清华大学出版社出版了。这半年有不少朋友一直在等,非常感谢大家的耐心和支持~
这是一本适合自学的概率论与数理统计教材,700多页,延续了我写回答时的讲法:用大白话,讲得很详细,把公式背后的道理讲清楚,也把各个知识点之间的联系串起来。
书中还结合了交叉熵、KL散度等AI相关内容,并设有“AI视野”和“Python实验室”。此外,也收录了2024—2026年考研数学一、数学三的部分概率论真题,以及大厂算法岗面试概率题的详细解答。
如果你喜欢这篇回答的讲法,也想系统地学一遍概率论,可以看看这本书。 下方放了购书卡片,感谢大家支持~
知乎原文
计算机当然能一眼看出,这是我用yolo训的“极大值检测模型”:
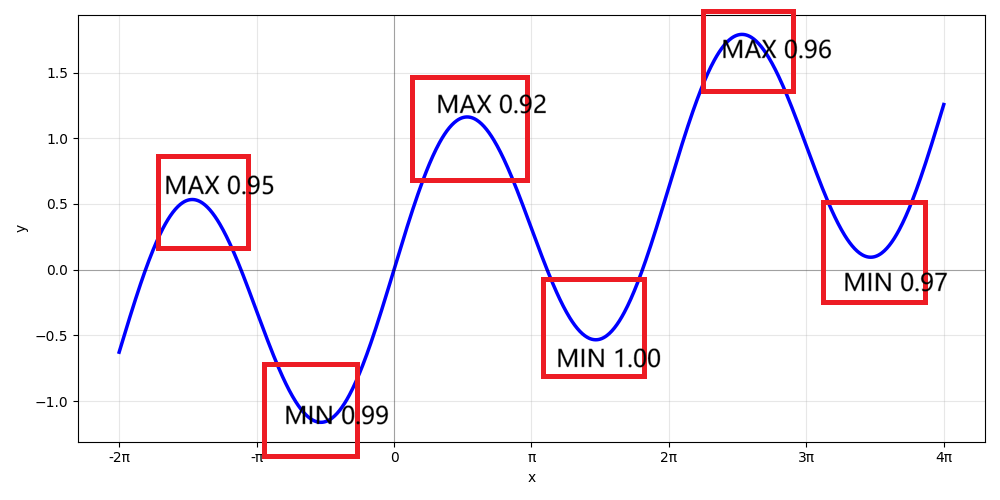
计算机一眼就能看出极大值和极小值(手动滑稽)!
不抖机灵了,正儿八经回答:
这个问题挺有意思。我当时学梯度下降的时候,也想过类似的问题。
比如下面这四张函数图像,或者一段股市的K线图(知乎的港股K线图),我们一眼望过去,就能大概知道哪里高、哪里低。
于是很自然地就想,既然人眼这么厉害,为什么计算机在找函数最小值这个问题上,有时候显得“笨”?吭哧吭哧算半天,还可能算错,掉进一个“局部小坑”里就爬不出来了。
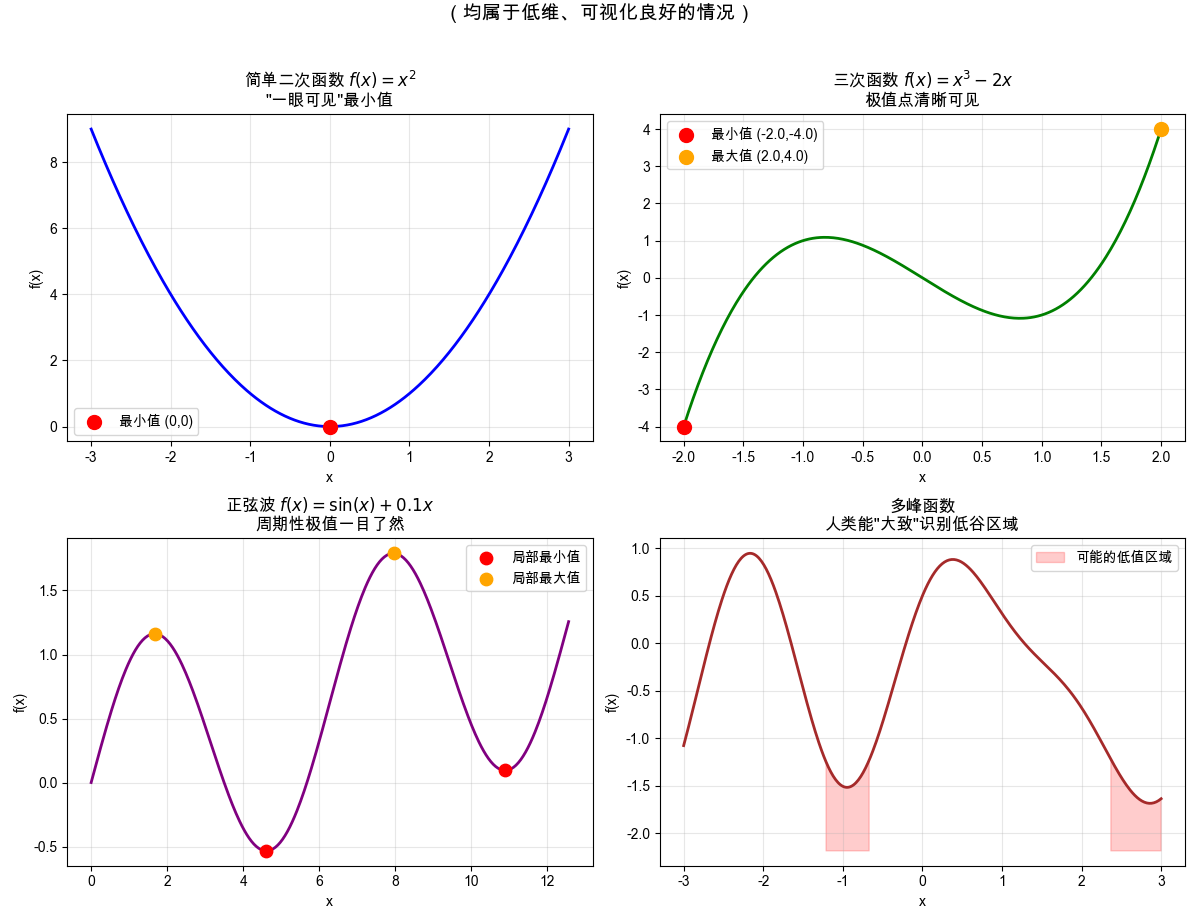
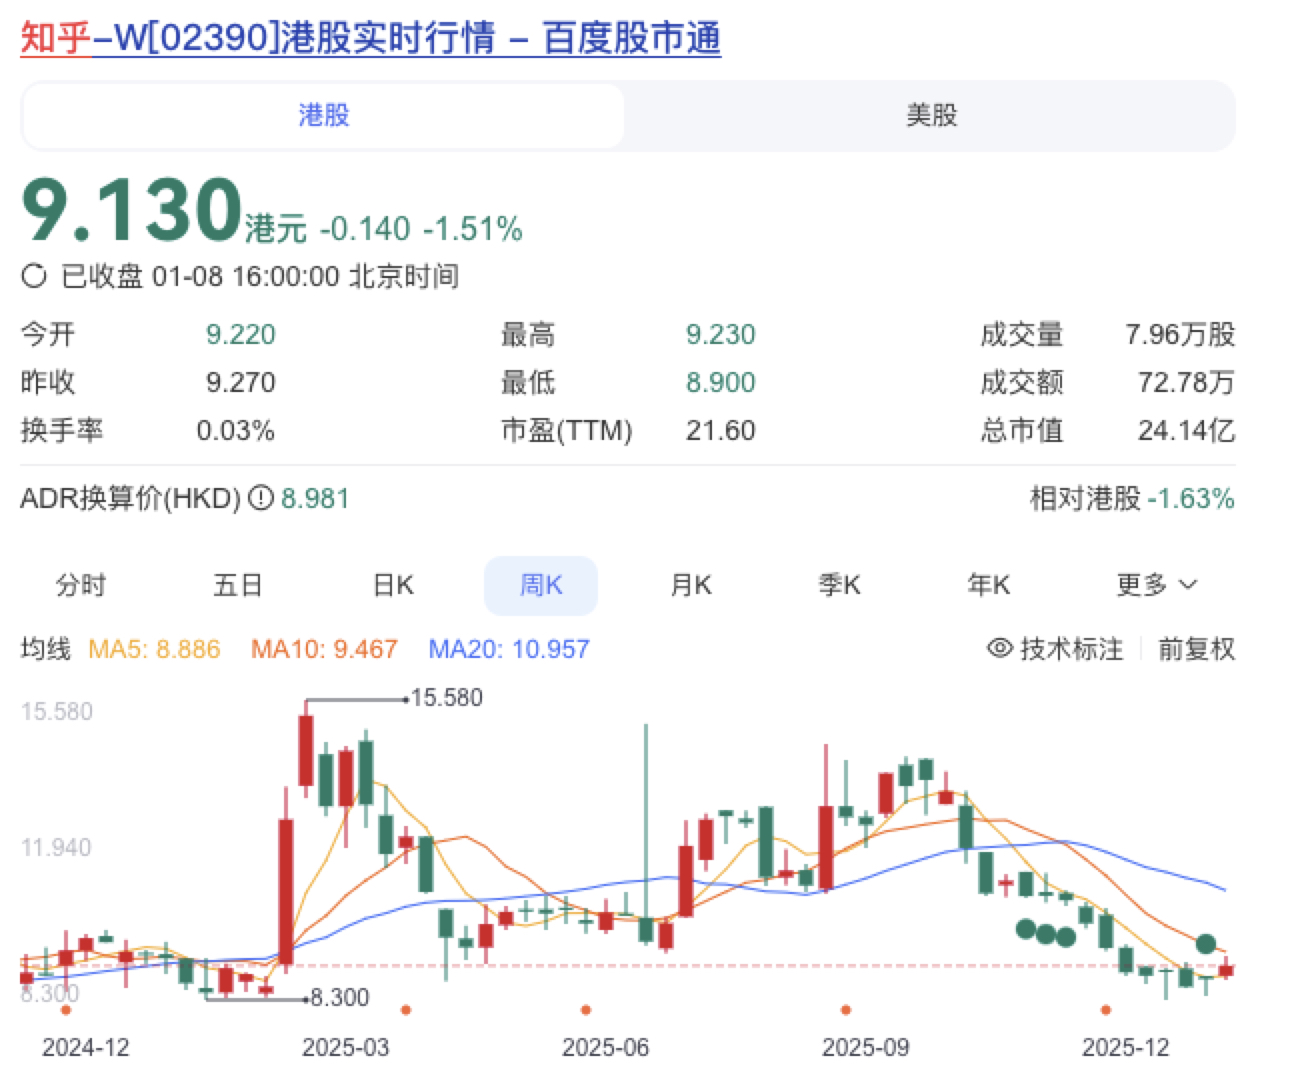
我们觉得自己能“一眼看出”,是因为眼前这些图,恰好是我们能看懂的。
换两种情况,你看看还能不能“一眼看出”:
f(x₁, x₂, ..., x₁₀)。它的图像存在于一个十一维的空间里。现在,请你“一眼”告诉我它的最低点在哪里?我们连十一维的图都想象不出来,又怎么一眼找到它的最低点?f(x) = sin(x²) / log(|x|+1) + 0.1 * random()。x 从0到10之间的最低点?这就没那么容易了。没有画好的图,我们也得先算一算,才能知道它哪里高、哪里低。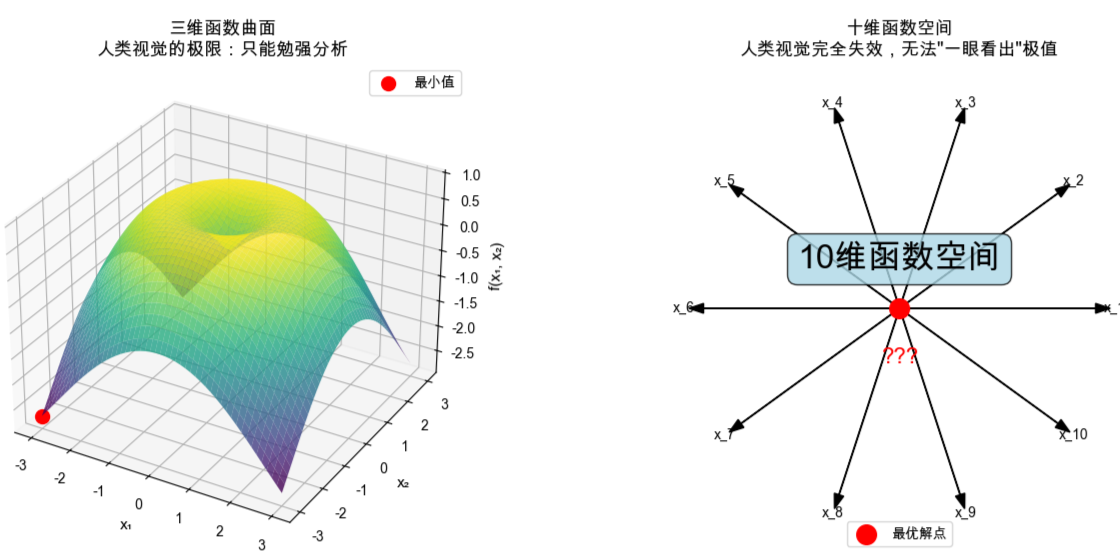
所以,我们能“一眼看出”,前提是先有一张能看懂的图。函数的维度高了,或者只给公式、不画图,就没有这么容易了。
那就接着问:在这些人眼能看懂的图里,为什么梯度下降还要一步一步算?
这里的对比,有点“关公战秦琼”的意思。人和计算机拿到的东西不一样,找最低点的办法也不一样。
模拟一下这个过程。
(1)你拿到的是什么?
是一张已经画好的函数图像。整条曲线哪里高、哪里低,你都能一起看到。
(2)你是怎么做的?
你看着整条曲线,发现这里有个像碗一样的凹陷,碗底大概就在这个位置,于是就能说:“最低点大概在x=5附近。”你没有一步一步去算,而是直接从图上估了个位置。
(1)它拿到的是什么?
它手里没有画好的图。给它一个x,它可以算出这个位置的函数值和斜率;但它不会因此就看到整条曲线。
(2)它是怎么做的?
它像一个拄着拐杖下山的人。比如从某个起点开始,它计算:“这里的斜率是正是负?” 计算结果:“正的。”于是算法说:“好,那我要往反方向,往下走。”它朝着下坡的方向,小心翼翼地迈出一小步,到达一个新的点 x₁。然后,它在这个新点重复同样的问题:“现在的斜率呢?” 再根据答案调整方向,迈出下一步。
它就这样一步、一步、一步往下走,每一步都要先算当前位置的斜率。它看不到整个地形,只知道当前脚下是上坡还是下坡。如果走进了一个小坑,到坑底时斜率为零,它就可能停在这里,把这里当成了“最低点”,却不知道远处还有一个更深的坑。
在这种对比下,计算机显得“笨”,不是因为它的算力不够,而是因为:
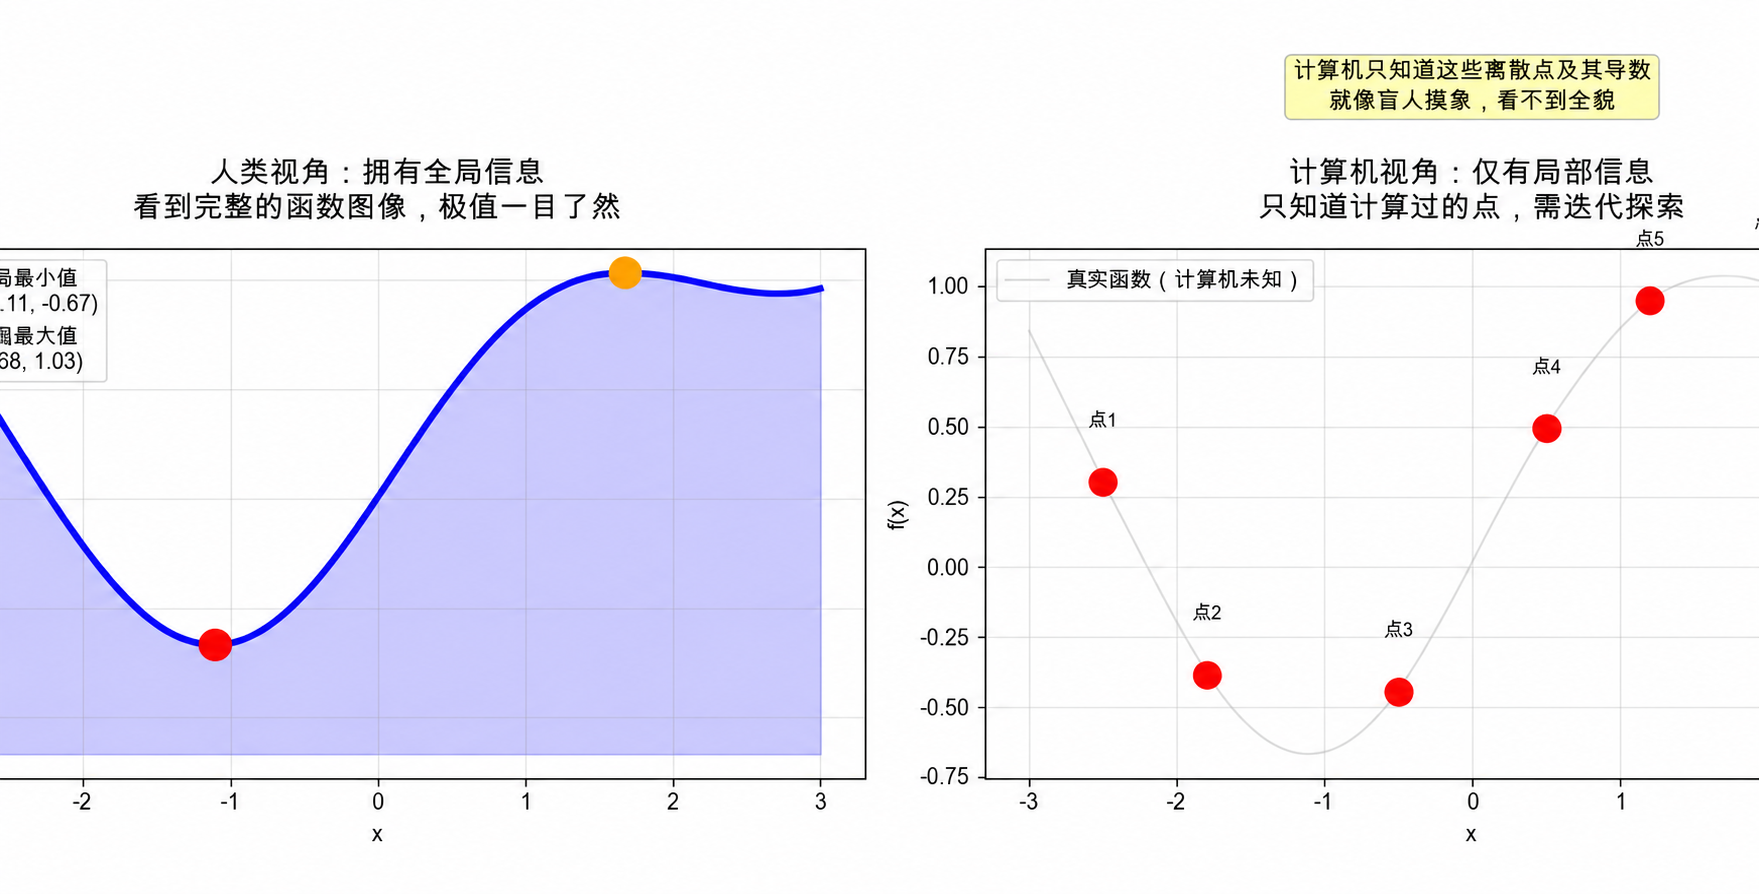
所以,这里比的其实是看着图估位置,和不看图一步一步算。
如果也把图给计算机看呢?回到开头我用YOLO训练的结果,它也能很快指出极值的大致位置。
我的《大白话概率论:从数学直觉到AI视野》已经出版了,也是尽量用大白话、具体例子和详细推导来讲。有兴趣系统学概率论的朋友,可以看看。
知乎原文
其实在古希腊时期(约公元前5世纪)就已经反直觉了。举两个例子。
无理数的发现:
那时候的数学家的直觉是:所有数都可以表示为整数之比。但是古希腊人发现,边长为1的正方形的对角线长度(√2)无法用任何两个整数之比表示。这对当时的部分数学家来说是违反直觉的、不可接受的。
芝诺悖论:
古希腊哲学家芝诺提出一个思想实验:阿基里斯和乌龟赛跑。如果让乌龟先跑一段,那么阿基里斯每次必须先到达乌龟上次所在的位置,而在这段时间里,乌龟又会向前移动一点。这个过程可以无限重复,因此芝诺在逻辑上论证了“快者永远追不上慢者”。
逻辑推导上似乎无懈可击,很反直觉。后来,微积分和极限理论给出了更清楚的数学解释。
殊不知,微积分带来了更多的反直觉……当然这是后话。
知乎原文
情况1:不使用梯度累积,batchsize=b1
情况2:使用梯度累积,batchsize = b1/accumulation_steps,每accumulation_steps个步骤更新参数
两种情况的训练成果是否等价?
直接上代码:
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader

# Step 1: 创建数据集
# 假设我们有以下的数据(输入x和输出y),数据量为6
x_data = torch.tensor([[1.0], [2.0], [3.0], [4.0], [5.0], [6.0]])
y_data = torch.tensor([[2.0], [4.0], [6.0], [8.0], [10.0], [12.0]])

# 创建一个 TensorDataset 和 DataLoader
dataset = TensorDataset(x_data, y_data)
batch_size = 2
dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=False)

# Step 2: 定义模型
class LinearModel(nn.Module):
    def __init__(self):
        super(LinearModel, self).__init__()
        self.linear = nn.Linear(1, 1)
        # self.bn = nn.BatchNorm1d(1)

    def forward(self, x):
        x = self.linear(x)
        # x = self.bn(x)
        return x

model = LinearModel()
model.train()

# 指定初始参数
with torch.no_grad():
    model.linear.weight.fill_(0.5)  # 设定权重初始值为0.5
    model.linear.bias.fill_(-1.0)   # 设定偏差初始值为-1.0

# Step 3: 定义损失函数和优化器
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)

# Step 4: 训练模型
epochs = 2
accumulation_steps = 2  # 设置梯度累积步数(在这个例子中每个epoch训练3次)

for epoch in range(epochs):
    optimizer.zero_grad()  # 清空梯度
    accumulated_loss = 0.0
    # accumulated_loss.requires_grad=True

    # 使用 DataLoader 迭代数据
    for i, (inputs, targets) in enumerate(dataloader):
        y_pred = model(inputs)
        # print('===epoch:{}  batch:{}'.format(epoch,i),'\n',
        #       'y_pred:',[[round(num, 2) for num in sublist] for sublist in y_pred.tolist()],'\n',
        #       'targets:',[[round(num, 2) for num in sublist] for sublist in targets.tolist()],'\n',
        #       'inputs:',[[round(num, 2) for num in sublist] for sublist in inputs.tolist()]
        #       )
        loss = criterion(y_pred, targets)
        group_start = (i // accumulation_steps) * accumulation_steps
        steps_this_group = min(accumulation_steps, len(dataloader) - group_start)
        loss = loss / steps_this_group
        # print('loss:',loss.tolist())
        loss.backward()  # 反向传播,但不立即更新权重
        # print(f'linear Weight Grad: {model.linear.weight.grad}, Bias Grad: {model.linear.bias.grad}')
        # print(f'bn Weight Grad: {model.bn.weight.grad}, Bias Grad: {model.bn.bias.grad}')
        accumulated_loss += loss.item()

        # 每 `accumulation_steps` 步后更新权重
        if (i + 1) % accumulation_steps == 0 or (i + 1) == len(dataloader):
            # accumulated_loss.backward()
            optimizer.step()
            optimizer.zero_grad()

    # print(f'Epoch: {epoch+1}/{epochs}, accumulated_loss: {accumulated_loss / len(dataloader)}')

print("Training finished")
print('accumulation_steps:',accumulation_steps,' batch_size:',batch_size)
print('model.linear.weight',model.linear.weight)
print('model.linear.bias',model.linear.bias)
# print('model.bn.weight',model.bn.weight)
# print('model.bn.bias',model.bn.bias)
以下是我做了几次实验的结果:
Training finished
accumulation_steps: 2  batch_size: 3
model.linear.weight Parameter containing:
tensor([[1.3820]], requires_grad=True)
model.linear.bias Parameter containing:
tensor([-0.7893], requires_grad=True)

Training finished
accumulation_steps: 3  batch_size: 2
model.linear.weight Parameter containing:
tensor([[1.3820]], requires_grad=True)
model.linear.bias Parameter containing:
tensor([-0.7893], requires_grad=True)

Training finished
accumulation_steps: 1  batch_size: 6
model.linear.weight Parameter containing:
tensor([[1.3820]], requires_grad=True)
model.linear.bias Parameter containing:
tensor([-0.7893], requires_grad=True)

Training finished
accumulation_steps: 6  batch_size: 1
model.linear.weight Parameter containing:
tensor([[1.3820]], requires_grad=True)
model.linear.bias Parameter containing:
tensor([-0.7893], requires_grad=True)

Training finished
accumulation_steps: 2  batch_size: 2
model.linear.weight Parameter containing:
tensor([[1.9683]], requires_grad=True)
model.linear.bias Parameter containing:
tensor([-0.6726], requires_grad=True)
可以看到,只要满足accumulation_steps*batch_size相等,那么产生的结果是一致的,可以得到同样的参数。
(1)等价的前提是,每次更新参数时,用到的是同一批数据。这里设置shuffle=False,是为了方便对比。如果两次实验分别打乱数据,分到每次更新里的样本不一样,结果就不一定相同。
(2)网络里有BN层时,两者也不一定等价。BN要用当前batch的均值和方差,2条一组分别算,和4条一组一起算,结果可能不同。上面的小例子还把BN放在最后:不同组原本有不同的整体高低,分别归一化之后,这个差别被抹掉了,就很难同时拟合各组的真实label。
(3)如果两边计算loss时取平均的方式不同,也可能不等价。
比如说batchsize=1,此时有两条数据,第一条数据(第一个batch)的长度是50个token,第二条数据(第二个batch)的长度是200个token。
如果希望每条样本的分量一样,可以先算出每条样本的平均loss,再对两条样本取平均:
另一种方法是先把两条样本的token loss加起来,再除以总共250个token:
这种算法让每个token的分量一样,长文本的token更多,整条样本的分量也就更大。我们这里先按每条样本的分量一样来讨论,所以采用前一种算法。举个直观的例子,有两个国家,第一个国家的人口只有几百人,识字率为100%,第二个国家的人口有几百万人,识字率为50%。如果把两个国家当作平等的对象看待,那么综合识字率应该是75%。这对应的就是每条样本分量一样的算法。但是如果把两个国家的人混合起来,那么综合识字率仍然是50%左右。这样混合下来,第一个国家的特性被淹没了。
回到梯度累积的话题来,要比较两者是否等价,得先让它们按同一种方法计算loss。不能一边按样本平均,另一边又按token平均。
先从batchsize=2开始推理:
$w=w-l\cdot\frac{\partial loss}{\partial w}\\=w-\frac{1}{2}(l\cdot\frac{1}{50}\frac{\partial \sum_{i=1}^{50}{-\log\tilde{y}_i}}{\partial w}+l\cdot\frac{1}{200}\frac{\partial \sum_{i=1}^{200}{-\log\tilde{y}^{(2)}_i}}{\partial w})\\=w-\frac{1}{2}l(\frac{\partial loss1}{\partial w}+\frac{\partial loss2}{\partial w})$
这样的话两者就等价了。
知乎原文
很多人小时候玩过飞行棋,有一条规则是“每轮抛一次骰子,直到抛到6点,才能起飞”。
可以简单算出,平均要抛6次骰子,才能抛出一次6点。
那么,假如真的抛了6次,这6次都还没有出现6点的概率是多少?当你在思考这个问题的时候,自然常数e就离你不远了。
考虑一连串独立的实验,每次实验有成功和失败两种结果。单次实验的成功概率是p。根据几何分布的数学期望,平均实验n=1/p次,实验才会成功一次。那么,当实验了n次,还没有成功的概率是 ,这个式子对n取极限就等于 .
可以直接用抽签来做:从1到100里随机抽一个数,抽到1算成功,每次抽完放回。这样,每次成功的概率就是1%。
连续抽100次算一轮,每轮只记一件事:有没有抽到过1。
比如做了100轮,其中63轮抽到过1,剩下37轮一次都没抽到。那么,这37%的“一轮都没成功”的频率,就接近1/e。再用100除以37,约等于2.70,就是我们对e的一个估计。
多做一些轮,得到的频率通常会更稳。
建议p小于0.1,p越小,结果对e的近似程度越高。
我是怎么想到这个方法的?我分享下我的思考过程,希望对大家有帮助。
说到e,最先想到的是泊松分布:
的意义是单位时间内“冲击”的期望次数。假设=1,在单位时间内还没有冲击的概率是
由于二项分布的极限是泊松分布,可以设计一个成功率为p的实验,n=1/p。把单位时间分成n份,每1/n时间都做一次实验。n越大,这个二项分布越像泊松分布。因此,当n很大时,n次都未成功的概率就接近1/e。
这个实验背后,是几何分布、泊松分布和自然常数e之间的联系。我在《大白话概率论》里专门讲了这部分,有兴趣可以看看。
知乎原文
本回答不涉及任何数学公式,只谈直观理解。
假如你正在玩一个闯关游戏,每关都有可能会出现一个怪物(每关最多出现一个),在每一个关卡中,出现怪物的概率是p。每个关卡是否出现怪物,和之前的关卡无关。
那么,对于第一个关卡,是否出现怪物,或者说出现怪物的个数,服从伯努利分布。出现怪物的概率是p,不出现怪物的概率是1-p。同理,对于第二个关卡,第三个关卡……每一个关卡内,是否出现怪物,都服从伯努利分布。
伯努利分布是最简单最基础的概率分布。
接下来,考虑多个关卡。假如已经完成了n个关卡了,在这n个关卡中,一共出现了多少次怪物?这个值服从二项分布。
一个关卡,是否出现怪物,是伯努利分布;多个关卡,一共出现了多少个怪物,是二项分布。
如果p比较小,比如说是0.1,那么可能连续好几关都不会出现怪物。那么问题来了,从第一关开始,你要经历多少关,才能碰到第一个怪物?这个关数服从几何分布。
几何分布的第一个核心特质就是等待。它的数学期望是概率的倒数。飞行棋中,我平均要等6轮,才能摇到一次为6点的骰子。投篮命中概率为0.2的小坤,平均要投5次篮,才能投中一次。每轮出现怪物的概率是0.1,平均要经过10轮,才会遇到一次怪物。
扩展一下,假设我在第9轮碰到了怪物。那么从下轮开始,我平均要经过多少轮,才能碰到下一个怪物呢?答案还是10轮。哪怕第9轮没有碰到怪物,从下轮开始,我还是要平均经过10轮,才能碰到下一个怪物。几何分布的第二个核心特质就是无记忆性。不管你现在在第几轮,不管之前的回合有多少个怪物来了,不管这一轮有没有怪物来,从下一轮开始,一切仿佛从头开始。
硬币没有记忆,骰子没有良心。很多人以为运气会“攒人品”:连着9关都没碰到怪物,第10关总该来了吧?并不会。开头说过,每一关出不出现怪物,和之前的关卡无关,游戏根本不记得你已经等了多久。
把这两个特质放在一起,几何分布就像一个“永远活在当下”的渣男:你得一直等他,可不管你已经等了多久,过去发生的一切,对他都毫无意义,每次都要你从头开始等。
接下来,上点难度。几何分布问的是:要闯多少关,才能碰到第1只怪物?如果把问题改成:要闯多少关,才能碰到第10只怪物?这个关数就服从负二项分布。你可以把它理解成几何分布的加长版:先等到第1只,再从头开始等第2只……一直等到第10只。每一段等待都像重新开始,每段平均要10关,所以一共平均要10×10=100关。
上面已经说了四种分布:伯努利分布、二项分布、几何分布、负二项分布。
接下来,我们改一下游戏机制。游戏取消了关卡。怪物不再是每回合可能出现一次,而是随时可能出现一只。
请问过了10分钟,出现了多少只怪物?这就引出了题主问题的答案——泊松分布。
一开始游戏是关卡制的,每个关卡最多来一只怪物。我们称这个是离散情况。现在怪物随时可能出现,我们称为连续情况。
注意,这里的“连续”说的是时间连续。怪物的个数还是一只一只数的,0只、1只、2只……所以泊松分布本身仍然是一个离散分布。
在离散情况中,游戏进行了n个关卡,出现的怪物的次数服从二项分布。
那么在连续情况中,游戏进行了m分钟,出现的怪物的次数要怎么知道呢?
很简单,把它近似为离散情况就好了。假设每0.001秒是一个关卡。每个关卡的出现怪物的概率是q,这个q肯定很小。那么10分钟,相当于60万个关卡。问题转变成了——每个关卡出现的概率为q,一共进行了60万个关卡,请问出现的怪物的次数的分布。当然是服从二项分布了!
但是这个仍然是离散的情况。如何才能变成连续的情况呢?办法是把关卡切得更细。上面一个关卡是0.001秒,我们可以改成0.0001秒、0.00001秒……一直切下去。关卡越短,就越接近“怪物随时可能出现”的连续情况。
切的时候要注意两件事。第一,关卡切得越细,关卡数就越多,每关来怪物的概率q也必须跟着变小。否则关卡多了十倍,怪物也多了十倍,就不是原来那个游戏了。比如原来10分钟平均来50只怪物,不管怎么切,10分钟平均还是来50只。第二,原来的规则是每关最多来一只怪物。关卡切得足够细之后,两只怪物恰好挤进同一个极短的关卡,几乎不可能发生,这条限制就可以不管了。
按这个方式一直切下去,二项分布最后变成的那个分布,就是泊松分布。
好的,既然泊松分布是二项分布的极限形式,那么刚刚说到的几何分布,是否也有对应的亲戚呢?当然。从游戏开始,要等多长时间,才能碰到第一只怪物?这个等待时间服从指数分布。
指数分布和泊松分布之间,也有一个“倒数”关系,和前面几何分布的情况是一个道理。回忆一下,关卡制里,每关来怪物的概率是0.1,也就是平均每关来0.1只怪物,那么平均要等1÷0.1=10关,才能碰到第一只。换到连续的情况:假如平均每分钟来5只怪物,那么平均要等1÷5=0.2分钟,才能等到第一只。一个是“单位时间里平均来几只”,一个是“平均要等多久才来一只”,两者互为倒数。
其实泊松分布和指数分布,说的是同一条时间轴上的同一件事。还是按刚才那个模型,假如你站在路边,数一分钟内经过了几辆车,这是泊松分布;你看着手表,记下一辆车还要等多久才来,这是指数分布。一个在数个数,一个在量间隔。
正如几何分布是离散界的渣男,连续界的指数分布也继承了几何分布的特质——等待和无记忆性。在这个游戏中,我平均要等待0.2分钟,才能等到第一个怪物。等到了第一个怪物后,还要平均等待0.2分钟,才能等到第二个怪物。哪怕我已经等了1分钟都没有怪物过来,我平均还是要再等0.2分钟。
最后一个问题,要等多长时间,才能等到第20只怪物?这个时间服从伽马分布。它和指数分布的关系,就像负二项分布和几何分布的关系:指数分布等的是第1只,伽马分布等的是第20只。每一只平均要等0.2分钟,所以等到第20只,平均要20×0.2=4分钟。
最后,用一张图总结文章的内容:
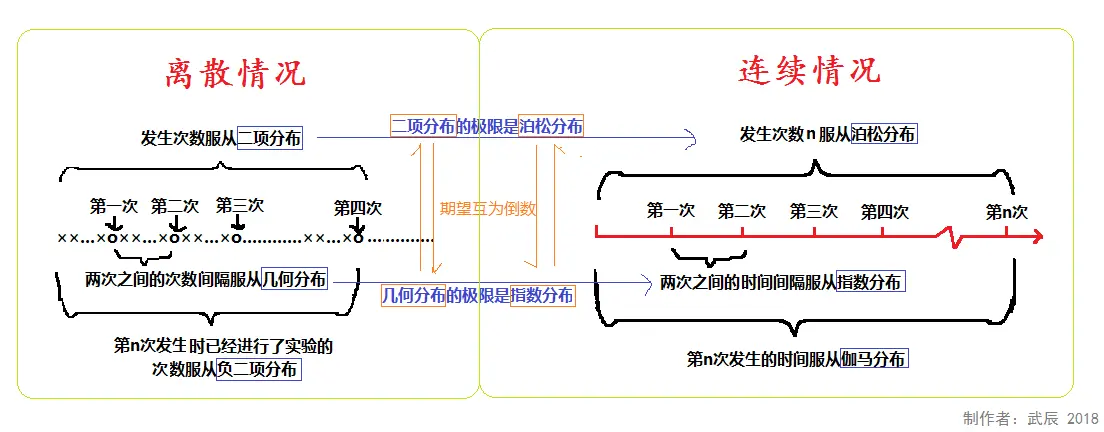
这篇回答里打怪的故事,后来我也写进了《大白话概率论》。书里还顺着这个游戏往下讲了两个问题:玩很多关,总耗时会是什么分布?如果不知道每关出怪的概率,能不能从打过的关里猜出来?书已经出版了,想接着看的朋友,可以阅读这本书。
知乎原文
LLMs可分为三大架构类型:Encoder-only(如BERT)、Decoder-only(如GPT)及Encoder-Decoder(如T5)。
首先比较Encoder-only和Decoder-only,因为这两个的优劣相对更容易比较些。
在比较之前,需要明白Encoder-only和Decoder-only有什么不同:
(1)信息可见性
Encoder-only架构中,每个token可以访问序列中的所有其他token信息,而在Decoder-only架构中,由于采用了因果掩码(causal mask),每个位置的token只能访问自己和前面的token信息。
(2)训练目标
Encoder-only架构主要是通过Masked Language Modeling(MLM)任务进行预训练,即随机遮蔽输入序列中的一些token并让模型预测这些被遮挡的token,以此学习丰富的语言上下文表示。而Decoder-only架构(如GPT)的主要训练方式是基于Next Token Prediction,模型在给定前n-1个token的情况下预测第n个token,这鼓励模型生成连贯的文本序列。
(3)生成方式
你给BERT一段话,它会给每个token算出一个结合了前后文信息的向量。GPT则是接着你给的话往下写:先预测下一个token的概率,再选出一个token,接着继续往下写。如果开启采样(do_sample),每次选到的token可能不一样,所以同一个问题也可以得到不同的回答。
LLM在生成任务上的应用更广泛,因此Decoder-only架构更受青睐。
至于为什么Decoder-only结构会比Encoder-Decoder更好,我赞同 @成诚 的答案。Decoder-only架构相较于Encoder-Decoder的优势,一个关键点在于计算效率与模型规模的扩展性。GPT凭借其规整、线性堆叠的Transformer层,有利于实现高效的流水线并行处理,而T5等Encoder-Decoder结构的复杂性限制了其大规模扩展的潜力。
此外,如果每套Transformer的层数和隐藏维度相同,Encoder-Decoder需要编码器和解码器两套参数,Decoder-only只需要一套,参数量通常更少。
实践层面,Decoder-only架构的广泛应用也得益于大家伙“用脚投票”——因为大家都在用,都觉得好用。OpenAI通过GPT系列确立了Decoder-only架构的强大性能,加之特定技术如KVCache对Decoder-only架构的适配性,共同推动了Decoder-only架构成为当前主流。
知乎原文
我通过一个简单的例子来说明公钥和私钥。
第一步,选择两个大素数,这里为了简化说明,选择了p = 3 和 q = 11。然后计算 n = p * q = 33。p和q不要告诉任何人。
这个n=33是可以告诉大家的,但是33是由哪两个素数相乘,不能告诉大家,而且大家很难知道。(当然,这里的33,一眼可以看出可以分解成3*11。但是在实际场景中,n一般是一个很大很大的数字,大到用几百台电脑都无法在短期内将其质因数分解。因此p和q只有我一个人知道,别人是无法知道的,也很难破解出来。)
第二步,计算(p−1)∗(q−1)=(3−1)∗(11−1)=2∗10=20,这个数也不要让任何人知道。至于为什么要计算这个公式,你暂时只需要死记硬背。
第三步,选择公钥指数e。可以从2到19中,选择一个与第二步的结果20互质的整数,比如选择7。
第四步,选择私钥指数d。找一个整数 d ,使得 (d * e) % ((p-1)*(q-1)) = 1
经过一些数学运算(比如欧几里得算法,这里不详细展开),得到d=3是其中一个解。因为3*7%20=1
这里的d也不要告诉任何人,这是解开加密信息的关键。
如此一来,公钥便是 (e, n) ,即 (7, 33);而私钥是 (d, n), 即 (3, 33)。公钥需要告诉他人,私钥则绝对不要告诉任何人。
接下来如何加密呢?
假如你想给我发一条消息,该消息以数字形式表示为 m = 9。你肯定不能直接将m=9发给我,这样别人可能会窃取到。于是,你需要用公钥将数字9加密。加密过程是c=m^e mod n。在这个例子中,计算过程是 9^7 mod 33 = 15。因此,加密后的密文为 15,可以公开发送。
当我收到 15 后,使用私钥进行解密。解密公式为 m' = c^d mod n。代入数值,我们有 15^3 mod 33 = 9。神奇之处在于,这恰好还原了原始信息 m = 9。
这背后的原理是:(m^e%n) ^d%n=m。具体如何证明就不展开了。这基于欧拉定理和模逆元的性质。用公钥加密后,可以用对应的私钥还原。只看这里的幂运算,反过来也能算;不过,公钥人人都知道,用公钥就能还原的信息,也就谈不上保密了。所以要分清:保密通信是公钥加密、私钥解密;数字签名是私钥签名、公钥验签,用来确认是谁发的、内容有没有被改过。
通俗来说,你首先选取两个大质数,得到了(e, d, n)三个数。你把 (e, n) 作为公钥告诉他人,把 (d, n)作为私钥不透露给他人。他人用公钥将信息加密后发给你,然后你通过私钥将信息解密。